大纲
一、引言:系统设计面试的本质(~5 分钟)
- 为什么大厂面试必考系统设计
- 面试官到底在考察什么
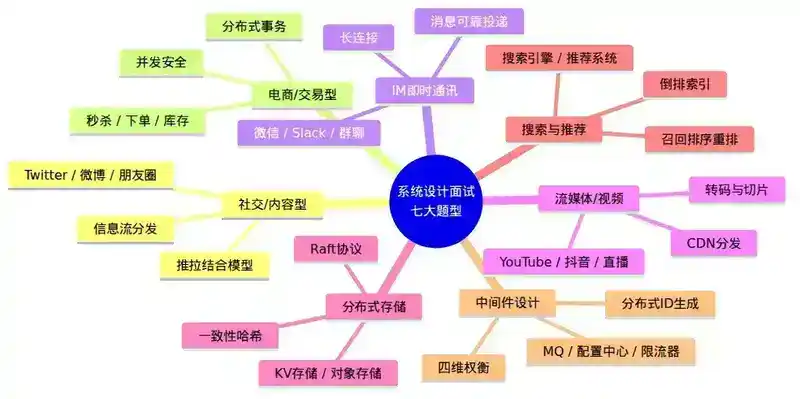
- 本文的七个分类维度
二、社交/内容型系统设计(~8 分钟)
- 核心特征:用户生成内容、关系链、信息流
- 典型题目:设计 Twitter / 设计 Instagram / 设计微博
- 关键设计维度:Feed 推送 vs 拉取模型、粉丝扩散、热度排序
- 技术栈:推拉结合、Timeline 服务、图数据库选型
- 实战思路:从单用户到千万粉丝的架构演进
三、电商/交易型系统设计(~8 分钟)
- 核心特征:订单、库存、支付、一致性
- 典型题目:设计秒杀系统 / 设计电商下单 / 设计库存管理
- 关键设计维度:库存扣减的并发安全、分布式事务、对账
- 技术栈:TCC、Saga、本地消息表、缓存穿透方案
- 实战思路:从 100 QPS 到秒杀场景的架构演进
四、IM 即时通讯系统设计(~7 分钟)
- 核心特征:实时性、有序性、离线消息
- 典型题目:设计微信 / 设计 Slack / 设计群聊
- 关键设计维度:长连接选型、消息可靠投递、群聊扩散
- 技术栈:WebSocket/TCP 长连接、MQ 异步解耦、读扩散 vs 写扩散
- 实战思路:从单聊到万人大群的消息分发
五、流媒体/视频系统设计(~5 分钟)
- 核心特征:大文件传输、转码、自适应码率
- 典型题目:设计 YouTube / 设计抖音 / 设计直播
- 关键设计维度:CDN 分发、自适应码率、实时转码
- 技术栈:HLS/DASH、CDN、编码器选型
- 实战思路:从上传到播放的全链路
六、分布式存储系统设计(~5 分钟)
- 核心特征:持久化、高可用、扩展性
- 典型题目:设计 KV 存储 / 设计对象存储 / 设计分布式文件系统
- 关键设计维度:数据分片、副本、一致性哈希、WAL
- 技术栈:LSM-Tree、Raft/Paxos、Gossip 协议
- 实战思路:从单机存储到 PB 级集群
七、搜索与推荐系统设计(~5 分钟)
- 核心特征:索引、排序、个性化
- 典型题目:设计搜索引擎 / 设计推荐系统 / 设计广告系统
- 关键设计维度:倒排索引、向量检索、召回-排序-重排
- 技术栈:Elasticsearch、Faiss、DNN 排序模型
- 实战思路:从关键词匹配到语义搜索的演进
八、中间件设计(~5 分钟)
- 核心特征:通用性、高吞吐、低延迟
- 典型题目:设计 MQ / 设计配置中心 / 设计限流器 / 设计分布式 ID
- 关键设计维度:性能、可靠性、易用性、扩展性
- 技术栈:存储引擎、网络框架、一致性协议
- 实战思路:从单机到分布式的中间件进化
九、总结:七类系统的横向对比与选型框架(~2 分钟)
- 一张表看清七类系统的核心差异
- 面试中的通用答题框架:需求 → 估算 → 接口 → 数据模型 → 架构 → 深挖
一、引言:系统设计面试的本质
系统设计面试是高级工程师、技术专家和架构师面试中绕不开的一关,也是区分"能写代码"和"能设计系统"的分水岭。面试官要的不是一个完美的方案,而是看你在模糊需求面前如何拆解、权衡和决策。
面试官考察的维度:
- 需求分析能力——能否在 5 分钟内快速理清功能需求和非功能需求
- 容量估算能力——QPS、存储、带宽的 back-of-the-envelope 估算
- 架构抽象能力——能否把复杂系统拆成清晰的模块和服务
- 技术选型与权衡——为什么选 Redis 而不是 MySQL?为什么选推模式而不是拉模式?
- 深度追问能力——面对面试官的"如果…怎么办"能否层层深入
系统设计面试的题目看似五花八门,但归纳起来不过七大类。每一类有固定的"套路"——掌握了这些套路,遇到任何题目都能快速拆解。
二、社交/内容型系统设计
2.1 核心特征
社交/内容型系统的本质是用户生成内容(UGC) 的生产、分发和消费。系统围绕三个核心实体展开:
- 用户:用户画像、关系链(关注/粉丝/好友)
- 内容:帖子、图片、视频、评论
- 信息流:Timeline / Feed,用户看到的内容序列
典型题目:
- 设计 Twitter / X(推文发布与信息流)
- 设计 Instagram(图片社交)
- 设计微博(内容广场 + 热搜)
- 设计朋友圈(私密社交 + 可见性控制)
2.2 关键设计维度
Feed 推送 vs 拉取模型
这是社交系统设计中最核心的权衡。用一个比喻来理解:
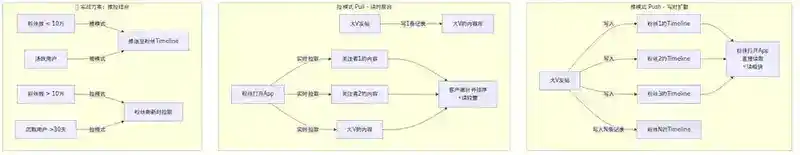
推模式(Push / Fan-out on Write):你发一条微博,系统立刻帮你把这条内容"塞"到所有粉丝的 Timeline 里。就像你写了一封信,复印了 N 份投递到每个朋友的信箱。
- 优点:读操作极快,粉丝打开 App 直接取自己的信箱
- 缺点:写操作重——一个百万粉丝的大 V 发帖,需要瞬间写 100 万条记录
- 适用场景:粉丝数可控的场景(如朋友圈)
拉模式(Pull / Fan-out on Read):你打开微博,系统实时去查你关注的所有人最近发了什么,合并排序后展示。就像你上门去每个朋友家取信。
- 优点:写操作轻,大 V 发帖只需写一条记录
- 缺点:读操作重,每刷一次 Feed 都要聚合 N 个人的最新内容
- 适用场景:读操作压力不大的场景
实战方案:推拉结合
大多数现代社交系统采用混合策略:
对于粉丝数 < 10 万的普通用户:推模式(推送至粉丝 Timeline)
对于粉丝数 > 10 万的大 V:拉模式(粉丝刷新时拉取大 V 内容)
        + 活跃用户推模式
        + 非活跃用户(> 30 天未登录):拉模式
热度排序 vs 时间排序
- 时间排序:简单,时间线存储,用户拉取时按时间倒序
- 热度排序:需要引入排序服务,计算内容的"热度分"——基于点赞、评论、转发、发布时间衰减等因子加权
热度的核心公式通常类似 Hacker News 算法:
Score = (U - 1) / (T + 2)^G
其中 U = 点赞数,T = 发布时间(小时),G = 重力因子(通常 1.5~1.8)
图数据库选型
社交关系是典型的图结构——关注、好友、粉丝都是节点之间的边。设计关系查询时需要考虑:
- 一跳查询:我的关注列表 → 普通关系型数据库完全够用
- 二跳查询:我关注的人也关注了谁 → 需要图遍历
- N 跳查询:推荐"你可能认识的人" → 图算法(PageRank、Community Detection)
选型建议:
- 粉丝数 < 1 万、关系查询简单:MySQL 的 follower 表 + Redis 缓存足够
- 百万级用户、需要推荐算法:引入 Neo4j 或 Nebula Graph 等图数据库
- 超大规模:自研图存储,如 Facebook 的 TAO(社交图专用存储)
2.3 架构演进思路
阶段 1(MVP)
  App → API Server → MySQL(user, post, follower 三张表)
  QPS: 100

阶段 2(引入缓存)
  App → API Server → Redis(Timeline 缓存)→ MySQL
  QPS: 1,000

阶段 3(读写分离 + 推拉结合)
  App → Feed Service → Redis Cluster(Timeline)
                     → MySQL 主库(写入)
                     → MySQL 从库(读取)
  QPS: 10,000

阶段 4(大 V 专项优化 + CDN)
  App → CDN(图片/视频)
      → Feed Service → 推拉路由器 → 普通用户推模式
                                   → 大 V 拉模式 + 合并
                     → 图数据库(推荐)
  QPS: 100,000+
三、电商/交易型系统设计
3.1 核心特征
电商系统与社交系统最大的区别:每一笔操作都涉及钱。这意味着系统必须在一致性、可用性和性能之间做出精密的权衡。
核心实体:
- 商品:SKU、库存、价格
- 订单:创建、支付、履约、售后
- 用户:买家、卖家、账户余额
典型题目:
- 设计秒杀系统
- 设计电商下单流程
- 设计库存管理系统
- 设计优惠券/促销系统
3.2 关键设计维度
库存扣减的并发安全
这是电商系统中最经典的并发问题。假设只剩 1 件商品,两个用户同时下单:
-- 错误做法:先查后扣
SELECT stock FROM product WHERE id = 1; -- 用户 A 读到 stock=1
SELECT stock FROM product WHERE id = 1; -- 用户 B 读到 stock=1 (并发)
UPDATE product SET stock = 0 WHERE id = 1; -- A 扣减
UPDATE product SET stock = 0 WHERE id = 1; -- B 也扣减 → 超卖!
正确做法:
-- 方案 1:数据库行锁 + 条件更新
UPDATE product SET stock = stock - 1
WHERE id = 1 AND stock >= 1;
-- 返回 affected rows = 0 表示库存不足

-- 方案 2:Redis 预扣库存(秒杀场景)
-- 将库存预热到 Redis,利用 Redis 的原子性
DECR stock:product:1
-- 返回 < 0 表示库存不足
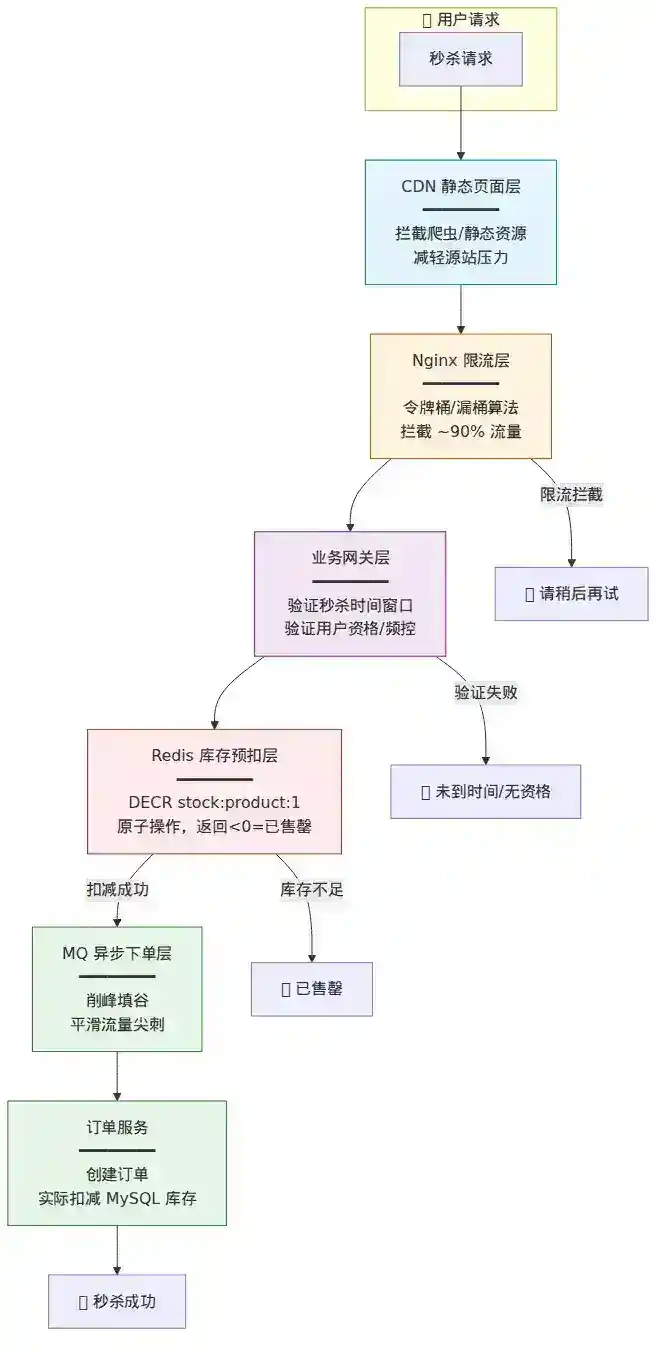
秒杀系统中的多层防护:
客户端 → CDN(静态页面)
       → Nginx 限流层(令牌桶/漏桶,拦截 90% 流量)
       → 业务网关层(验证秒杀时间、用户资格)
       → Redis 库存预扣(原子 DECR)
       → MQ 异步下单(削峰填谷)
       → 订单服务(创建订单 + 实际扣减 MySQL 库存)
分布式事务与最终一致性
电商下单流程涉及多个服务:订单服务、库存服务、支付服务、积分服务。任何一个服务失败,如何保证数据一致性?
方案对比:
| 方案 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 2PC / XA | 两阶段提交,协调者先 prepare 再 commit | 强一致性 | 性能差、单点故障 |
| TCC | Try-Confirm-Cancel,业务层实现补偿 | 性能好、灵活 | 代码侵入强 |
| Saga | 每个步骤有正向操作和补偿操作 | 长事务友好 | 隔离性弱 |
| 本地消息表 | 本地事务 + 消息表,异步重试 | 最终一致性、简单 | 需要处理重复消息 |
实战:电商下单的 Saga 实现
正向流程:
1. 创建订单(状态: PENDING)
2. 锁定库存(库存服务预留 N 件)
3. 创建支付单(支付服务)
4. 扣减积分(积分服务)
5. 订单确认(状态: CONFIRMED)

补偿流程(任何步骤失败时):
- 步骤 3 失败 → 释放库存 + 取消订单
- 步骤 4 失败 → 取消支付 + 释放库存 + 取消订单
3.3 架构演进思路
阶段 1:单体应用
  App → Order Service → MySQL(单库单表)
  QPS: 100

阶段 2:缓存 + 读写分离
  App → Order Service → Redis(库存/商品缓存)
                      → MySQL 主(写) → MySQL 从(读)
  QPS: 1,000

阶段 3:微服务拆分 + 消息队列
  App → 网关 → 订单服务 → MQ → 库存服务
              → 商品服务 → 支付服务
  QPS: 10,000

阶段 4:异构数据 + 多级缓存
  本地缓存(Caffeine)→ Redis 集群 → MySQL 分库分表
  热点探测 + 自动预热
  QPS: 100,000+
四、IM 即时通讯系统设计
4.1 核心特征
IM 系统的核心挑战在于实时性、可靠性和有序性三个维度的博弈。消息不能丢、不能乱、不能慢。
典型题目:
- 设计微信单聊
- 设计群聊(万人大群)
- 设计 Slack / 企业 IM
- 设计在线状态服务
4.2 关键设计维度
长连接选型
IM 系统需要服务端能主动向客户端推送消息,短轮询(客户端不断问"有新消息吗?")性能太差。
| 方案 | 原理 | 适用场景 |
|---|---|---|
| 短轮询 | HTTP 定时请求 | 已淘汰 |
| 长轮询 | HTTP 请求挂起,有消息时返回 | 兼容性好,延迟较高 |
| WebSocket | 全双工 TCP 连接 | 浏览器/移动端,主流方案 |
| TCP 长连接 | 自定义协议 | 移动端原生,微信/QQ 方案 |
实践中,大多数 IM 系统采用 WebSocket + TCP 长连接双通道:
客户端 → 长连接网关(连接管理)→ 消息路由层 → 消息存储层

连接网关负责:
- 连接管理(建连、心跳、断线重连)
- 协议解析(Protobuf/自定义二进制协议)
- 负载均衡(一致性哈希分配到固定网关节点)
消息可靠投递:ACK 机制
IM 消息投递需要端到端的确认,而不是简单的"发出去了":
发送方 → 服务端 → 接收方

每一跳都有 ACK:
1. 发送方发送消息 → 服务端回复 ACK(服务端确认收到)
2. 服务端推送消息 → 接收方回复 ACK(客户端确认收到)
3. 如果超时未收到 ACK → 重试(指数退避)
消息存储模型:
消息表(message)
- msg_id (全局唯一,雪花算法生成)
- from_uid
- to_uid / group_id
- content
- create_time
- msg_sequence(会话内严格递增序号,用于保证有序)

每个用户维护一个会话级别的 last_msg_seq,用于:
- 拉取离线消息(last_msg_seq 之后的消息)
- 检测消息丢失
- 多端同步
群聊扩散:读扩散 vs 写扩散
这是群聊设计中最关键的权衡:
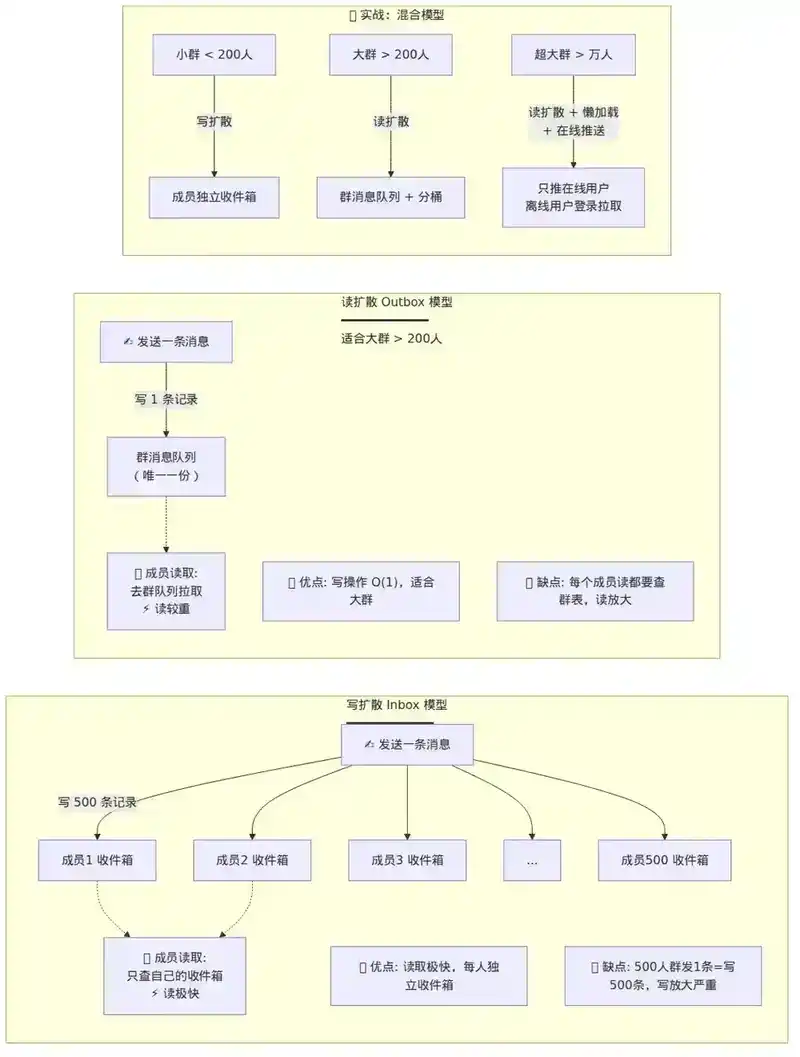
写扩散(Inbox 模型):消息发出时,为群内每个成员写一条"收件箱记录"。
优点:成员读取极快,查自己的收件箱即可
缺点:500 人大群,发一条消息要写 500 条记录,写放大严重
适用:小群(< 100 人)
读扩散(Outbox 模型):消息只存一份,成员读取时去群的消息队列里拉取。
优点:写操作 O(1),适合大群
缺点:每个成员读消息时都要查群的消息表,读放大
适用:大群(> 100 人)
实战方案:混合模型
小群(< 200 人):写扩散,每个成员有自己的消息收件箱
大群(> 200 人):读扩散,消息存一份,成员拉取时聚合
超大群(万人大群):读扩散 + 消息分桶 + 懒加载

特别优化:
- 只给在线用户实时推送,离线用户下次登录时拉取
- 活跃用户写扩散,沉默用户读扩散
4.3 架构设计
                        ┌──────────────┐
                        │   长连接网关   │
                        │  (WebSocket)  │
                        └──────┬───────┘
                               │
                        ┌──────┴───────┐
                        │   消息路由层   │
                        │ (一致性哈希)   │
                        └──────┬───────┘
                               │
            ┌──────────────────┼──────────────────┐
            │                  │                  │
     ┌──────┴──────┐   ┌──────┴──────┐   ┌──────┴──────┐
     │  消息存储服务  │   │  群组服务    │   │  在线状态服务  │
     │ (TiDB/HBase) │   │  (Redis+DB) │   │   (Redis)    │
     └─────────────┘   └─────────────┘   └─────────────┘
五、流媒体/视频系统设计
5.1 核心特征
流媒体系统的核心挑战是大文件、高带宽、低延迟。一个 10 分钟的高清视频动辄几百 MB,如何在用户点击后几乎无感地开始播放?
典型题目:
- 设计 YouTube
- 设计抖音/TikTok(短视频)
- 设计直播系统
- 设计视频会议(Zoom)
5.2 关键设计维度
视频处理管线
上传 → 存储 → 转码 → 切片 → CDN分发 → 播放

详细流程:
- 上传:分片上传(断点续传),原始文件存入对象存储(S3/MinIO)
- 转码:将原始视频转为多种分辨率
- 1080p / 720p / 480p / 360p / 240p
- 不同编码格式:H.264 / H.265 / VP9 / AV1
- 切片:将每个分辨率的视频切成 2~10 秒的 TS 片段
- CDN:将切片分发到全球 CDN 节点
- 播放:客户端根据网络状况自适应选择码率
#### 自适应码率(ABR)
客户端维护一个播放缓冲区(5~30 秒)
缓冲充足 → 请求更高码率 → 更清晰 缓冲不足 → 请求更低码率 → 保证不卡顿
主流协议:HLS(Apple)、DASH(MPEG 标准)
#### 直播 vs 点播的核心差异

| 维度 | 点播(YouTube) | 直播 |
|------|-----------------|------|
| 延迟要求 | 秒级即可 | 毫秒级(< 3 秒) |
| 编码 | 离线转码,追求压缩率 | 实时编码,追求速度 |
| 分发 | CDN,预热缓存 | 边缘推流 + 实时转码 |
| 协议 | HLS/DASH | RTMP(推流)/ WebRTC(低延迟) |
| 存储 | 永久存储 | 短期存储,可转点播 |

### 5.3 架构设计
推流端 → RTMP/WebRTC → 推流服务器 ↓ 实时转码集群 ↓ ┌─── CDN ───┐ ↓ ↓ HLS 切片 边缘节点 ↓ ↓ CDN 边缘 播放端 ↓ 播放端
---

## 六、分布式存储系统设计

### 6.1 核心特征

分布式存储是许多系统的基础设施,面试中常考其底层原理而非调 API 的姿势。

**典型题目:**
- 设计一个 Key-Value 存储
- 设计对象存储(类似 S3)
- 设计分布式文件系统(类似 HDFS)
- 设计一个支持范围查询的 NoSQL 数据库

### 6.2 关键设计维度

#### 数据分片策略

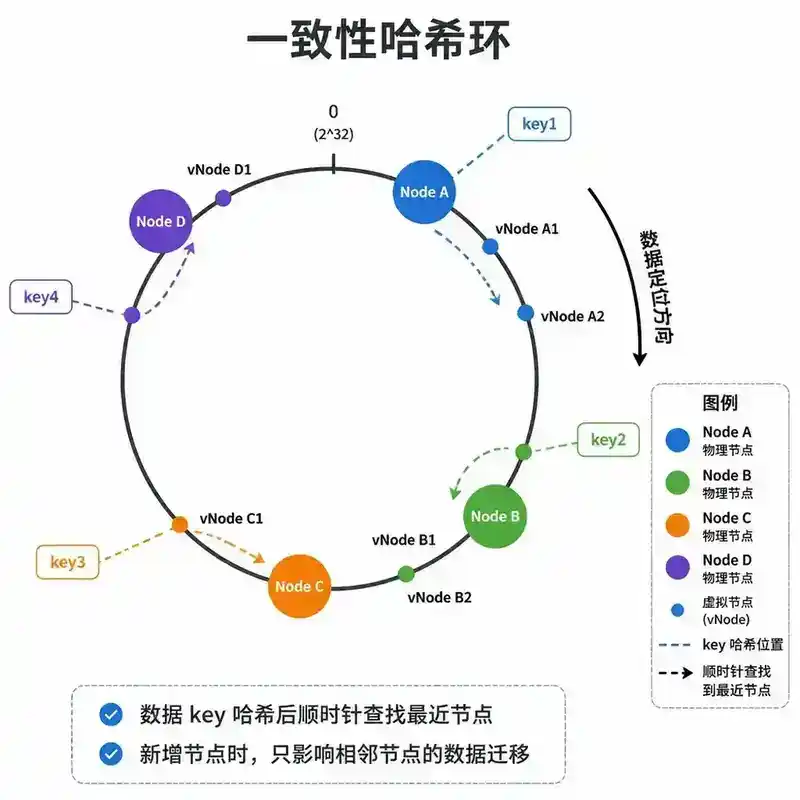
**一致性哈希:**
- 将节点和数据都映射到同一个哈希环上
- 新增/删除节点时,只影响相邻节点,数据迁移量最小
- 引入虚拟节点解决数据倾斜

**范围分片:**
- 按 key 范围分片(A-C、D-F、G-I...)
- 支持范围查询,但容易热点
- 适合 HBase / TiKV 等

**哈希分片:**
- key 哈希后取模
- 均匀分布,但扩容时需大量迁移
- 适合 Redis Cluster / Memcached

#### 副本与一致性

单副本:数据丢失风险高
多副本(3 副本):Raft 协议保证一致性

**Raft 的核心流程:**
- Leader 接收写请求
- 将日志复制到 Follower(多数派 ack 即成功)
- 提交日志
- 应用到状态机
- 返回客户端

**关键参数:**
- 副本数 = 3(1 Leader + 2 Follower)
- 多数派 = 2(容忍 1 个节点故障)
- 读写都走 Leader(强一致性)
- 读可走 Follower(最终一致性,性能更好)

#### 存储引擎选型

| 引擎 | 结构 | 写性能 | 读性能 | 代表 |
|------|------|--------|--------|------|
| B+ Tree | 平衡多叉树 | 一般 | 好 | MySQL InnoDB |
| LSM-Tree | 顺序写 + 多层合并 | 极好 | 一般 | RocksDB, LevelDB |
| Hash | 哈希表 | 极好 | 好(点查) | Redis |

### 6.3 架构设计
客户端 → 元数据服务(NameNode / Master) ↓ 数据节点集群(DataNode / Region Server)
元数据服务:
- 存储文件/对象的元信息(文件名、大小、位置映射)
- 高可用部署(Active-Standby 或 Raft 集群)
数据节点:
- 实际存储数据块(Block / Chunk)
- 每个块多副本(默认 3 副本)
- 心跳上报 + 副本自动修复
七、搜索与推荐系统设计
7.1 核心特征
搜索和推荐虽然场景不同,但底层技术栈高度重叠。搜索是"用户主动找内容",推荐是"内容主动找用户"。
典型题目:
- 设计一个搜索引擎(类似 Google 简化版)
- 设计推荐系统(抖音/淘宝推荐)
- 设计广告系统(搜索广告 + 信息流广告)
7.2 关键设计维度
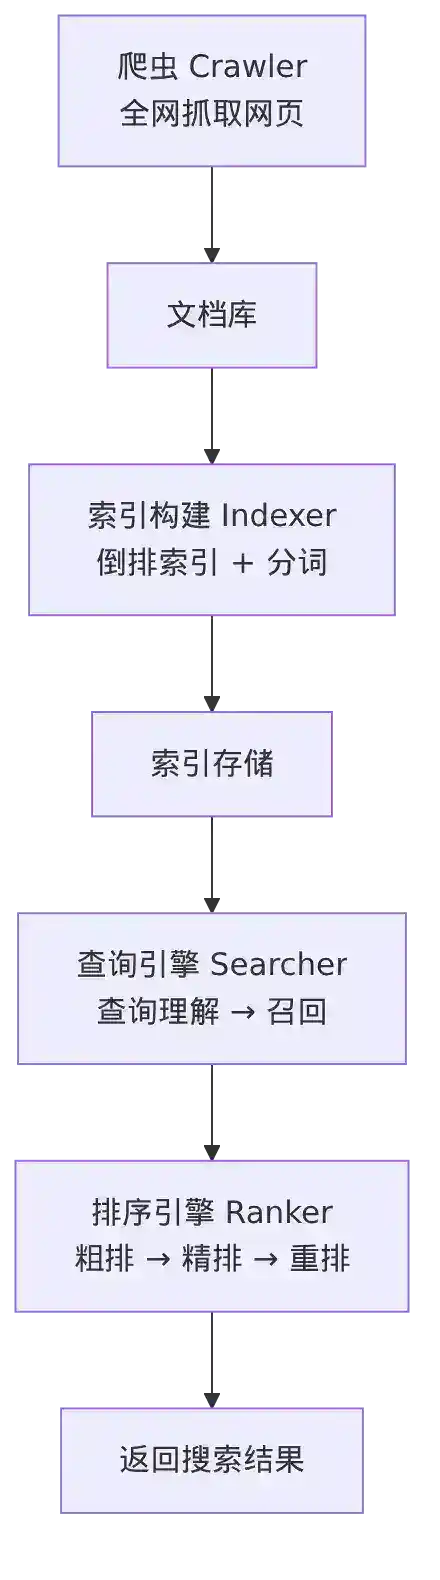
搜索引擎的四大组件
1. 爬虫(Crawler)
- 全网抓取网页,存到文档库
- 去重、URL 规范化
2. 索引构建(Indexer)
- 倒排索引:词 → 文档列表
- 正向索引:文档 → 词列表
- 分词:中文分词(jieba / HanLP)
3. 查询引擎(Searcher)
- 查询理解:分词、纠错、意图识别
- 召回:从倒排索引中检索候选文档
- 排序:相关性打分(TF-IDF → BM25 → 语义匹配)
4. 排序引擎(Ranker)
- 粗排:简单特征快速过滤
- 精排:复杂特征 + 模型打分
- 重排:多样性、去重、业务规则
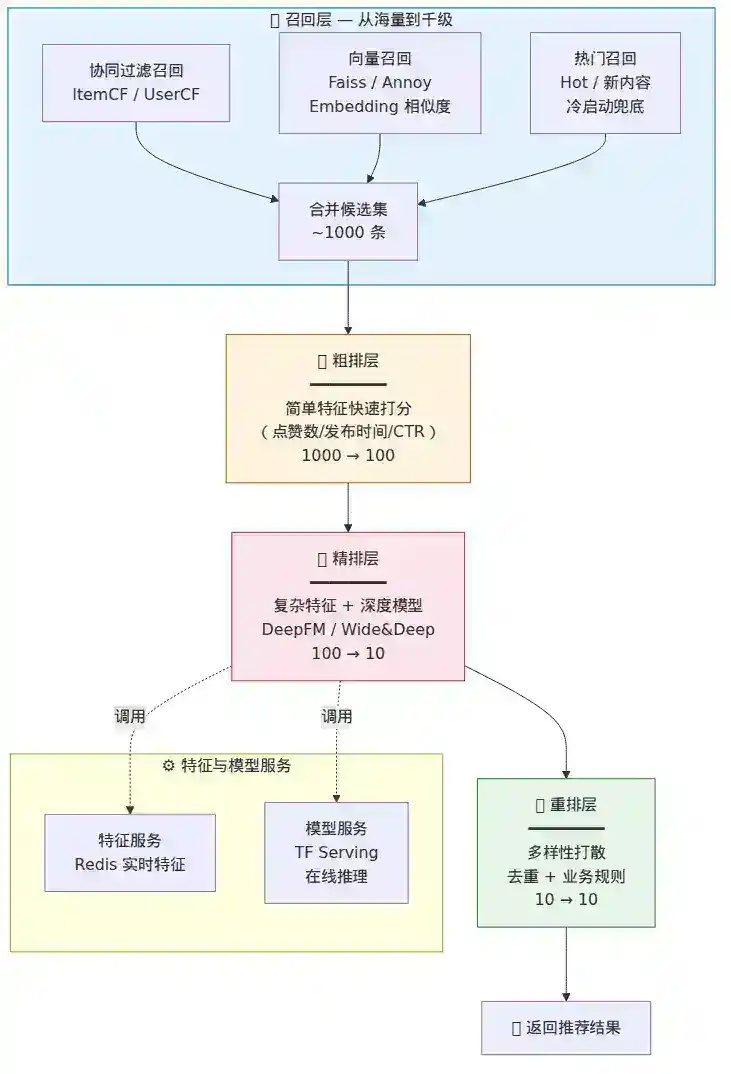
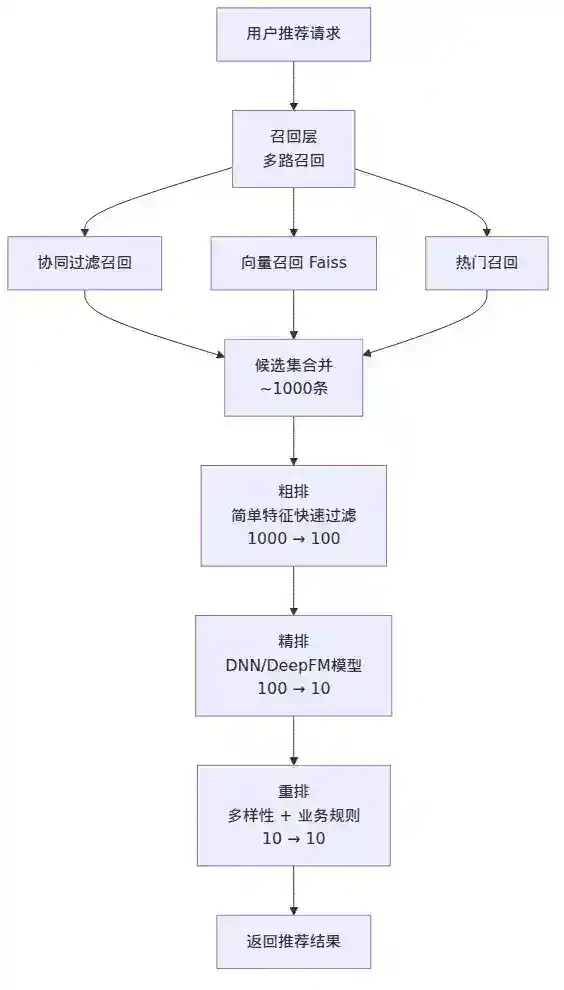
推荐系统的召回-排序-重排架构
                  ┌──────────────────┐
                  │    推荐请求        │
                  └────────┬─────────┘
                           │
            ┌──────────────┼──────────────┐
            │              │              │
      ┌─────┴─────┐ ┌─────┴─────┐ ┌─────┴─────┐
      │ 协同过滤召回 │ │ 向量召回   │ │ 热门召回   │
      │ (Item/User) │ │ (Faiss)   │ │ (Hot)     │
      └─────┬─────┘ └─────┬─────┘ └─────┬─────┘
            │              │              │
            └──────────────┼──────────────┘
                           │
                  ┌────────┴────────┐
                  │   粗排(1000→100)│
                  └────────┬────────┘
                           │
                  ┌────────┴────────┐
                  │   精排(100→10)  │
                  │  DNN/DeepFM/Wide │
                  │  & Deep          │
                  └────────┬────────┘
                           │
                  ┌────────┴────────┐
                  │   重排(10→10)   │
                  │  多样性 + 规则    │
                  └────────┬────────┘
                           │
                  ┌────────┴────────┐
                  │    返回结果       │
                  └─────────────────┘
7.3 架构设计
离线链路: 数据源 → 特征工程 → 模型训练 → 模型评估 → 模型上线
在线链路: 用户请求 → 召回层 → 排序层 → 重排层 → 返回
- 特征服务 (Redis)
- 模型服务 (TensorFlow Serving)
八、中间件设计
8.1 核心特征
中间件是分布式系统的"胶水",面试中考察中间件设计,本质是考察你从零造一个基础设施的能力。
典型题目:
- 设计一个消息队列(MQ)
- 设计一个配置中心
- 设计一个限流器
- 设计一个分布式 ID 生成器
- 设计一个 RPC 框架
8.2 关键设计维度
消息队列设计
核心组件:
1. 存储引擎
- 顺序写磁盘(CommitLog)→ 类似 Kafka 的日志存储
- 或内存 + 持久化 → 类似 RabbitMQ
2. 消费模型
- 推模式:Broker 主动推给 Consumer
- 拉模式:Consumer 主动拉取(Kafka 模式)
- 消费位点管理:记录每个 Consumer Group 消费到哪了
3. 可靠性
- 生产者确认(ACK)
- Broker 持久化 + 多副本(ISR 机制)
- 消费者确认(手动 ACK)
4. 高性能
- 零拷贝(sendfile 系统调用)
- 批量发送 + 批量拉取
- 分区并行消费
架构:
Producer → Broker Cluster(Leader-Follower)→ Consumer Group
 ↓
 ZooKeeper / KRaft(元数据管理)
分布式 ID 生成器设计
方案对比:
1. UUID
- 优点:简单,无中心化
- 缺点:128 位长,无序,不利于数据库索引
- 适用:临时 ID、不需要排序的场景
2. 数据库自增
- 优点:简单,有序
- 缺点:单点瓶颈,不适合高并发
- 适用:小规模系统
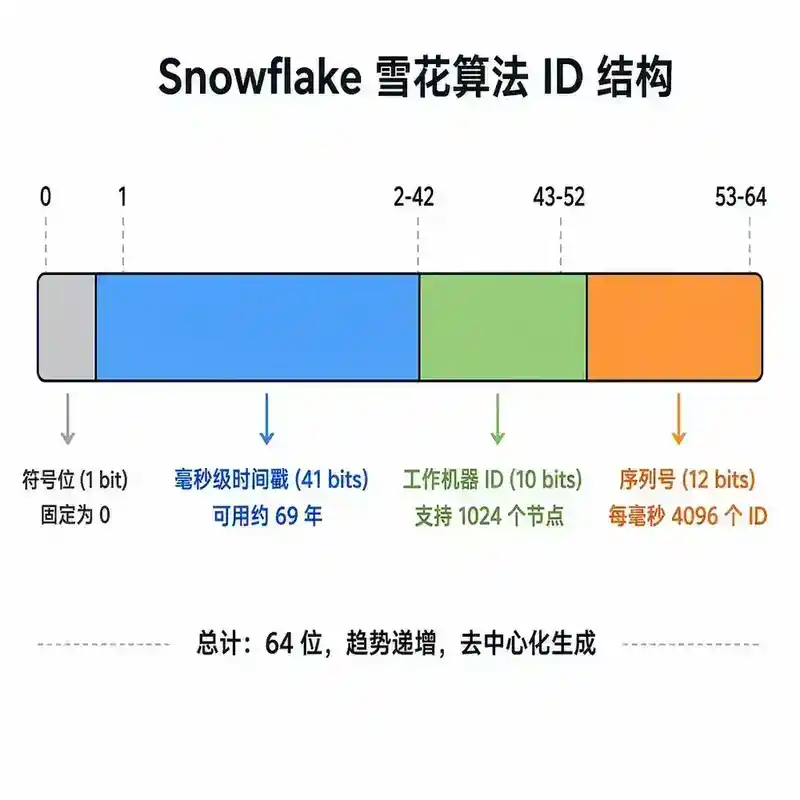
3. 雪花算法(Snowflake)
结构:64 位
┌─1─┬───41────┬───10───┬───12───┐
│ 0 │ 毫秒时间戳 │ 机器 ID │ 序列号 │
└───┴─────────┴────────┴────────┘
- 优点:高性能、趋势递增、去中心化
- 缺点:依赖机器时钟,时钟回拨需处理
- 适用:绝大多数分布式系统
4. 号段模式(Segment)
- 从数据库批量取一段 ID 号段,本地分配
- 优点:性能高,容灾好
- 适用:美团 Leaf 等生产方案
8.3 中间件设计通用思路
设计中间件时,面试官关注的是你能否系统性地思考以下四个维度:
性能 ←→ 可靠性
 ↑ ↑
 ↓ ↓
易用性 ←→ 扩展性

每次设计都要在这四个维度间做权衡:
- 要性能 → 牺牲可靠性?(异步刷盘 vs 同步刷盘)
- 要可靠 → 牺牲性能?(多副本同步 vs 单副本异步)
- 要易用 → 牺牲灵活性?(黑盒自动 vs 暴露配置)
- 要扩展 → 牺牲简单?(分片路由 vs 单机直连)
九、总结:七类系统的横向对比与通用答题框架
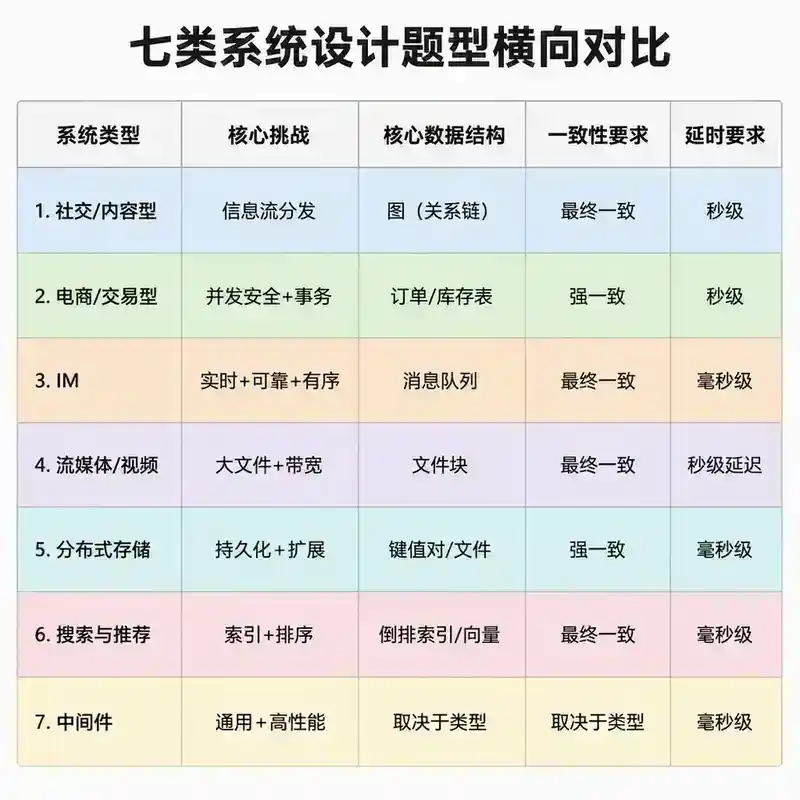
9.1 七类系统核心差异一览
| 系统类型 | 核心挑战 | 核心数据结构 | 一致性要求 | 延时要求 |
|---|---|---|---|---|
| 社交/内容型 | 信息流分发 | 图(关系链) | 最终一致 | 秒级 |
| 电商/交易型 | 并发安全 + 事务 | 订单/库存表 | 强一致 | 秒级 |
| IM | 实时 + 可靠 + 有序 | 消息队列 | 最终一致 | 毫秒级 |
| 流媒体/视频 | 大文件 + 带宽 | 文件块 | 最终一致 | 秒级延迟 |
| 分布式存储 | 持久化 + 扩展 | 键值对/文件 | 强一致 | 毫秒级 |
| 搜索与推荐 | 索引 + 排序 | 倒排索引/向量 | 最终一致 | 毫秒级 |
| 中间件 | 通用 + 高性能 | 取决于类型 | 取决于类型 | 毫秒级 |
9.2 通用面试答题框架(PEDALS)
面试中无论遇到哪类系统设计题,都可以用这个框架组织回答:
P - Problem(需求澄清):5 分钟
- 功能需求:核心功能有哪些?写出来,和面试官确认
- 非功能需求:QPS、延迟、一致性、可用性
E - Estimation(容量估算):3 分钟
- QPS 估算:DAU × 人均请求数 / 86400
- 存储估算:数据量 × 保留天数
- 带宽估算:QPS × 单次请求大小
D - Data Model(数据模型):3 分钟
- 核心实体:有哪些表/集合?
- 关系:一对一、一对多、多对多
- 索引:按什么查询?建什么索引?
A - API / Interface(接口设计):3 分钟
- 核心接口:RESTful API 还是 RPC?
- 请求/响应结构:字段、类型、错误码
L - Layered Architecture(分层架构):10 分钟
- 画架构图:从客户端到数据库
- 关键组件:服务拆分、缓存层、MQ、CDN
- 数据流:请求如何经过各层?
S - Scale & Deep Dive(扩展与深挖):10 分钟
- 瓶颈分析:哪里先撑不住?如何扩展?
- 故障处理:某个组件挂了怎么办?
- 面试官追问:针对关键点深入讨论
9.3 面试避坑指南
- 不要一上来就画架构图——先花 5 分钟澄清需求,避免走错方向
- 不要只给方案不给理由——每个技术选型都要说"为什么"
- 不要忽略非功能需求——高可用、可扩展、可监控是评分重点
- 不要回避 trade-off——面试官想听的就是你的权衡过程
- 不要说得太满——承认方案的局限性,提出改进方向
文末:面试官视角提问
以下 6 个问题从面试官视角出发,覆盖七类系统的核心设计思想。建议先独立作答,再对照答案检验理解深度。不计入 40 分钟阅读时间。
问题 1:Feed 流系统的推拉模型——"大 V 发微博,粉丝 5000 万,你的系统怎么设计?"
面试官追问场景:你先说了推模式,我又追问"如果大 V 发一条微博,你需要写 5000 万条 Timeline 记录,延迟怎么办?"你改说拉模式,我再追问"那普通用户打开 App 要聚合 200 个关注对象的最新内容,刷新速度怎么保证?"
回答要点:
推拉结合是标准答案,但面试官真正想听的是分层的策略设计:
- 活跃用户推、沉默用户拉:统计用户 30 天内登录频率,活跃用户(> 3 次/周)维持推模式,保证打开即刷的体验;沉默用户(> 30 天未登录)切到拉模式,节省写扩散的资源。
- 大 V 拉、普通用户推:粉丝数超过阈值(如 10 万)的账号,发布时只写一条主 Feed 记录,不扩散到粉丝 Timeline。粉丝刷新时,合并"普通 Timeline(推)"+"大 V 最新内容(拉)"两个来源。
- 异步扩散 + 离线拉取:大 V 的推模式可以异步执行——先把内容发到消息队列,由后台 Worker 慢慢扩散到粉丝 Timeline,发布者 50ms 内返回成功。对于"刚刚发布 5 秒内刷新看到"的体验,通过"补拉"来兜底——客户端刷新时,额外拉一次最近 5 秒内关注的大 V 有没有新内容。
- 关键数据支撑:为什么阈值是 10 万?因为 99.9% 的用户粉丝数不超过 10 万,推模式对他们完全够用;剩下的 0.1% 大 V 贡献了 50% 以上的内容消费,但只占 0.1% 的写请求。
问题 2:库存扣减——"Redis DECR 和 MySQL 条件更新,到底哪个更安全?"
面试官追问场景:你说 Redis DECR 原子操作可以防超卖,我追问"Redis 主从切换时,主节点挂了,从节点提升,DECR 还没同步过去怎么办?"你说那用 MySQL 条件更新,我再追问"MySQL 条件更新在高并发下,行锁竞争导致死锁怎么办?"
回答要点:
这个问题考察的是对 CAP 理论在具体场景中的应用理解:
- Redis DECR 的安全性边界:单节点 Redis 的 DECR 确实是原子的,但 Redis 默认异步复制(主从),主节点宕机时可能丢失最近的写操作。如果用 Redis 做库存扣减,必须接受最终一致性——即允许少量超卖,通过离线对账和退款补偿。如果不接受,就要用 Redis 的 WAIT 命令(同步复制到至少 1 个从节点)或 Redis Cluster 的同步复制,但代价是延迟增加 10-20ms。
- MySQL 条件更新的行锁粒度:
UPDATE ... WHERE stock >= 1在 InnoDB 下是行级锁,锁的粒度很细。但死锁的真正原因不是库存扣减本身,而是扣减库存的同时还操作了其他表(比如同时更新订单表、优惠券表),导致锁的获取顺序不一致。解决方案:统一加锁顺序(先锁库存、再锁优惠券),或者把库存扣减拆成独立事务,通过 MQ 异步处理后续操作。 - 终极方案:库存分层。秒杀场景下,Redis 做"预扣库存"(快速过滤),MySQL 做"真实库存"(最终一致)。Redis 预扣 120% 的库存(允许少量超卖容忍),MySQL 实际扣减时用条件更新兜底,超卖部分通过异步退款处理。对用户来说,Redis 层失败(已售罄)直接返回,MySQL 层失败(超卖)异步退款——体验上"下单成功但后来被告知失败"的概率远低于"压根抢不到"。
问题 3:IM 消息可靠投递——"消息发出去了,接收方离线,怎么保证他上线后一定能收到?"
面试官追问场景:你说用 ACK 机制保证可靠投递,我追问"服务端给发送方回了 ACK,但还没来得及推给接收方就挂了,消息丢了怎么办?"你说消息已经持久化了,我追问"那接收方上线后拉取消息,怎么知道从哪一条开始拉?如果消息序号不连续,怎么发现有丢失?"
回答要点:
- 消息必须先持久化,再回复 ACK:发送方发消息 → 服务端写入消息表(先写 WAL 日志,再写内存)→ 返回 ACK。只有持久化成功的消息才返回 ACK 给发送方,避免"ACK 了但消息丢了"。
- 会话级别的严格递增序号(msg_sequence):每个会话维护一个严格递增的序号,每条消息的序号 +1。接收方本地维护
last_seq(最后收到的序号),上线后向服务端请求last_seq + 1之后的所有消息。如果收到的消息序号不连续(比如收到了 seq=100 和 seq=102,缺了 seq=101),说明有消息丢失,客户端主动请求补发 seq=101。 - 离线消息的生命周期:离线消息不永久存储。服务端为每个用户维护一个"离线消息队列",存储最近 N 天(如 7 天)的未投递消息。超过时间的消息标记为"已过期",用户上线后只拉取有效期内的消息。消息表本身是全量持久化的,离线消息队列只是"未投递"的索引。
- 多端同步的挑战:同一个用户可能在手机、电脑、平板同时登录。每个设备各自维护自己的
last_seq,服务端记录每个设备的同步位点。如果用户在两台设备上交替使用,需要保证两边的消息序号一致——这通常通过"消息序号由服务端统一分配,客户端不参与"来实现。
问题 4:推荐系统的召回-排序-重排——"为什么不能一步到位?为什么需要三层?"
面试官追问场景:你说推荐系统分召回、排序、重排三层,我追问"能不能直接用精排模型对所有候选打分?为什么还要粗排?"你说粗排是为了性能,我追问"那如果我的候选池只有 100 个,是不是可以砍掉粗排?"
回答要点:
- 三层架构的本质是"计算资源和效果的最优分配":召回层(候选池从百万到千)用简单模型跑全量,速度快但精度低;排序层(千到百)用复杂模型跑精选,速度慢但精度高;重排层(百到百)不用模型,用规则(多样性、去重、业务策略)微调最终排序。
- 为什么不能跳过粗排:精排模型(如 DeepFM、DIN)一次推理可能需要 10-50ms。如果候选池有 100 万条,用精排直接跑需要 10000 秒,这在在线请求中完全不可接受。粗排(如双塔模型或 LR)一次推理只需 0.1-1ms,100 万条跑完只需 100 秒——再通过并行化 + 提前截断,实际只需几十毫秒。
- 候选池只有 100 个是否可以砍掉粗排:可以。但面试官想听的是你的弹性设计思维——推荐系统不应该写死"三层架构",而应该根据候选池大小动态调整。比如设计一个配置驱动的 pipeline:候选池 < 500 → 直接精排;500-5000 → 粗排 + 精排;> 5000 → 多路召回 + 粗排 + 精排 + 重排。
- 更深一层:为什么召回也不能只用一种方式:多路召回(协同过滤、向量召回、热门召回、地理召回)是为了保证"覆盖面"。如果只用协同过滤,新用户和新内容永远得不到曝光(冷启动问题)。多路召回互为补充,每路召回几十到几百条,合并去重后进入排序层。
问题 5:雪花算法——"Snowflake ID 依赖机器时钟,如果时钟回拨怎么办?"
面试官追问场景:你说雪花算法可能因为时钟回拨生成重复 ID,我追问"有没有什么办法可以彻底解决时钟回拨问题?"你说可以用 NTP 同步,我追问"NTP 同步本身也可能导致回拨,你怎么处理?"
回答要点:
- 首先要理解为什么时钟回拨是问题:雪花算法中,41 位时间戳是 ID 全局递增的关键。如果时钟回拨(比如从 10:00:05 回拨到 10:00:03),新生成的 ID 时间戳部分会小于之前生成的 ID,导致 ID 不再递增,甚至可能与之前的 ID 重复(如果序列号也碰巧相同)。
- 方案一:等待时钟追上——检测到回拨后,阻塞等待直到时钟恢复到上次记录的时间。简单粗暴,但会短暂拒绝服务,不适合对可用性要求极高场景。
- 方案二:备用时钟——记录每次生成 ID 时的"逻辑时钟"(不是系统时钟,而是自增计数器)。如果系统时钟回拨,使用逻辑时钟 + 1 作为时间戳。等系统时钟恢复到逻辑时钟之后,再切回系统时钟。
- 方案三:号段模式(生产级方案)——美团 Leaf 的做法:从数据库批量取一段 ID 号段(如 1-1000),本地分配,完全不依赖时钟。号的递增性由数据库号段保证,性能通过本地缓存号段保证。号段用完时批量取下一段,数据库挂了也能撑一段时间。
- 方案四:混合方案——雪花算法 + 号段双模。正常情况下用雪花算法(高性能),当时钟回拨时自动切到号段模式(兜底),时钟恢复后切回。
问题 6:PEDALS 框架实战——"给你一个新题:设计一个'在线协作文档系统'(类似 Google Docs),用 PEDALS 框架走一遍"
面试官追问场景:这道题综合考察你能否把前面七类系统的知识融会贯通。在线协作文档系统涉及实时协作(IM 的实时性 + 分布式存储的一致性)、文档存储(分布式存储)、权限管理(社交系统的关系链)、版本历史(存储系统的 WAL 日志思想)。
回答要点:
P - Problem(需求澄清):
- 功能需求:创建/编辑文档、实时协作(多人同时编辑看到彼此改动)、评论与建议模式、版本历史与回滚、导出(PDF/Word)、权限控制(只读/评论/编辑)
- 非功能需求:编辑延迟 < 200ms(用户感知不到延迟)、协作人数上限 50 人/文档、99.99% 可用性、数据不丢失
E - Estimation(容量估算):
- 假设 DAU 1000 万,人均创建 1 个文档、编辑 5 次
- 文档存储:1000 万 × 1 × 100KB = 1TB/天 → 365TB/年
- QPS:1000 万 × 5 / 86400 ≈ 580 QPS(编辑写入),峰值 × 3 ≈ 1700 QPS
- 协作流量:50 人同时编辑 × 每秒 10 次操作 × 并发文档数 = 取决于协作密度
D - Data Model(数据模型):
- Document 表:doc_id, title, owner_id, created_at, updated_at
- DocumentContent 表:doc_id, version, content(JSON/OT 操作序列)
- Operation 表:doc_id, user_id, operation(insert/delete/format), position, timestamp, version
- Permission 表:doc_id, user_id, role(owner/editor/viewer/commenter)
- 关键设计:内容不存"最终状态",而是存"操作序列"(OT/CRDT),每次打开文档时回放操作得到最新状态
A - API / Interface(接口设计):
POST /docs— 创建文档GET /docs/{id}— 获取文档(含最新状态)WebSocket /docs/{id}/collab— 协作通道,收发操作GET /docs/{id}/history— 版本历史POST /docs/{id}/rollback/{version}— 回滚到指定版本
L - Layered Architecture(分层架构):
- 接入层:WebSocket 长连接网关,管理协作连接
- 协作引擎:OT/CRDT 算法,操作转换 + 冲突解决
- 文档存储:操作序列存 MySQL/TiDB,快照存对象存储
- 权限服务:文档级别的 RBAC 权限控制
- CDN:导出的 PDF/Word 文件分发
S - Scale & Deep Dive(扩展与深挖):
- 瓶颈 1:单文档 50 人协作,操作冲突频繁 → CRDT 优于 OT(无中心化依赖,冲突自动合并)
- 瓶颈 2:长文档操作序列过长,打开慢 → 定期做快照(每 100 个操作版本合并一次),打开时先加载最近快照,再回放增量操作
- 瓶颈 3:WebSocket 连接数 → 一致性哈希分配网关,单网关维持 10 万连接,水平扩展
面试官总结:这 6 道题背后的考察逻辑
如果你能完整回答以上 6 道题,面试官会得到以下判断:
- 问题 1、2 考察的是权衡能力——你能否在不同约束下做出合理的技术决策,而不是背诵标准答案。
- 问题 3、5 考察的是底层原理——你能否深入技术细节,而不停留在"用 Redis 做缓存"的层面。
- 问题 4 考察的是架构思维——你能否理解"为什么这样设计",而不是"怎么用这个工具"。
- 问题 6 考察的是综合能力——你能否把分散的知识点串联起来,解决一个全新的、没有标准答案的问题。
系统设计面试没有标准答案,但有标准的思考路径。掌握了这七类系统的核心套路和 PEDALS 答题框架,你就能在任何题目面前从容不迫。
(全文完,含文末 Q&A 模块)