正文
一、引言:为什么容量规划是架构师的必修课
2019 年双十一,某知名电商平台在零点峰值时刻,订单服务集群的 QPS 从预估的 50 万飙升到 80 万,超出容量上限 60%。结果是:用户下单失败、购物车清空、优惠券过期,半小时内客服电话被打爆。事后复盘发现,问题出在容量规划上——业务方给的预估 DAU 是 2 亿,实际达到 3.2 亿,而容量规划时没有留出足够的弹性空间。
这不是孤例。几乎每个经历过大规模流量冲击的团队,都曾在容量规划上交过学费。容量规划,说白了就是回答一个问题:这套系统要撑住多大的流量,需要多少资源?
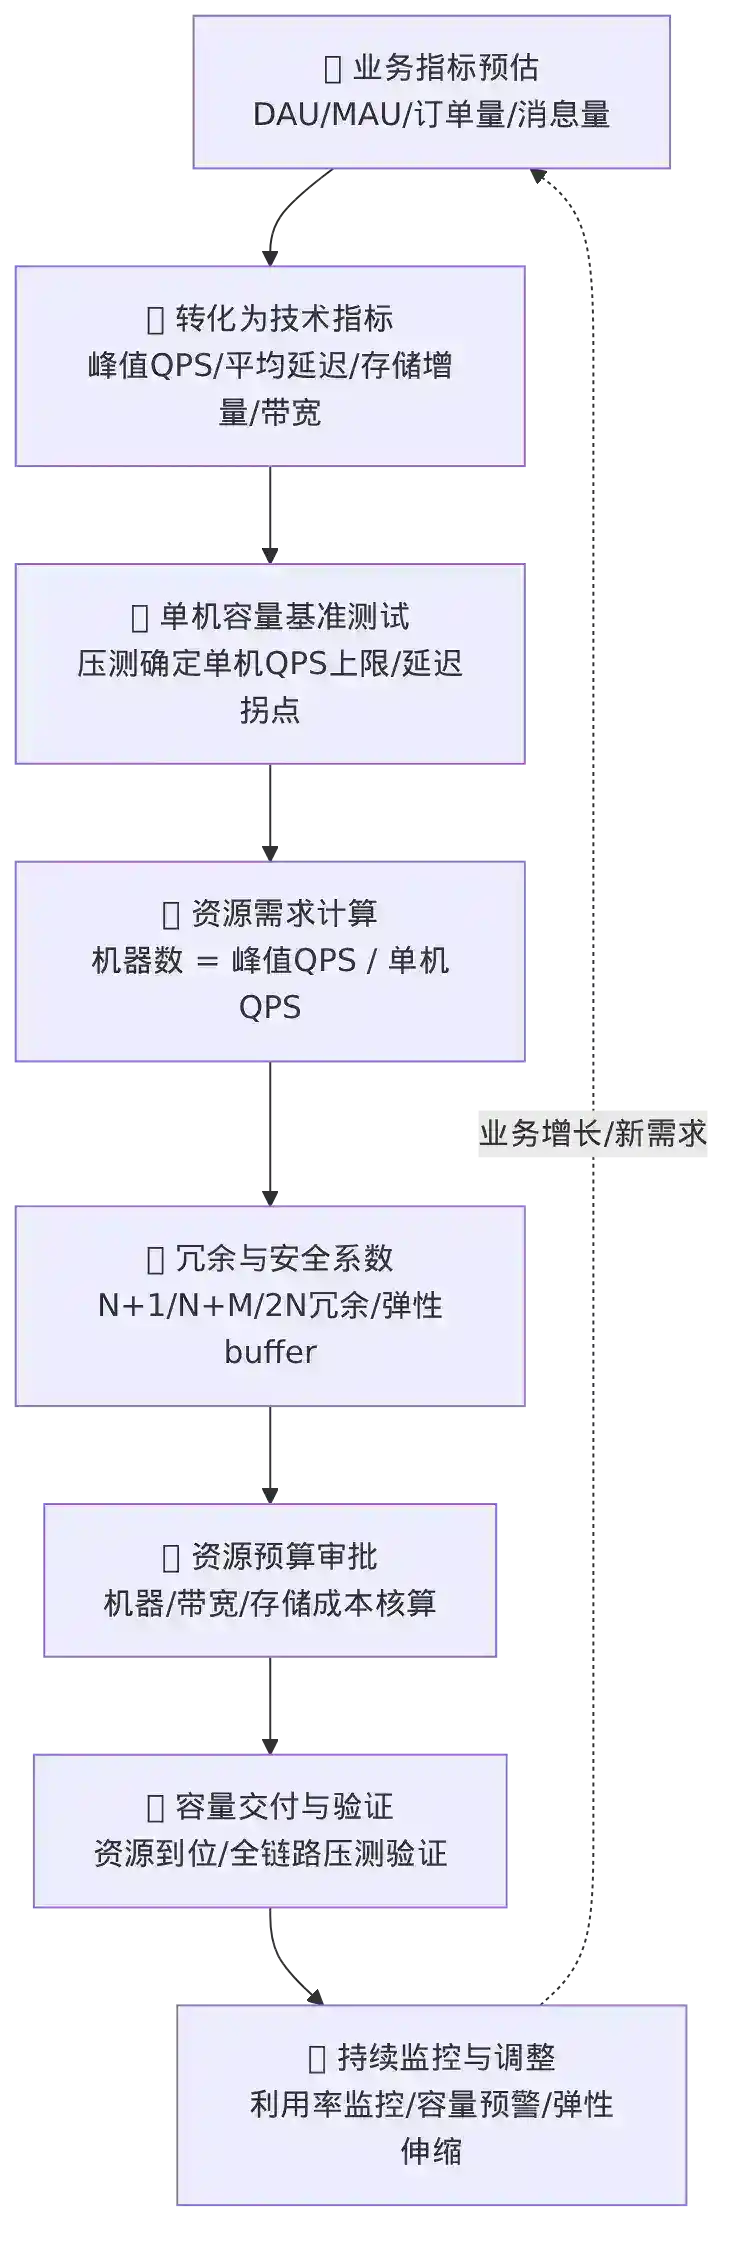
听起来简单,做起来却涉及多个维度的交叉判断:业务量如何转化为技术指标?单机能扛多少?峰值流量和均值流量差多少?存储要预留多少?网络带宽够不够?这些问题任何一个算错,都可能导致线上故障。
容量规划不是一个"算完就完"的静态任务,而是一个持续迭代的过程。业务在增长,系统在演进,流量模型在变化。一个合格的容量规划方案,既要能回答当前的问题,也要能预判未来的趋势。
本文将从核心概念出发,逐步深入到建模方法论、实战流程和典型案例,帮助你建立完整的容量规划知识体系。
二、核心概念与度量指标
2.1 QPS/TPS:吞吐量的标准度量
QPS(Queries Per Second) 和 TPS(Transactions Per Second) 是容量规划中最基础的指标。二者的区别在于:
- QPS:每秒查询次数,适用于读多写少的场景。一次 HTTP 请求、一次数据库查询都算一次 QPS。
- TPS:每秒事务数,适用于需要保证原子性的业务场景。一个事务可能包含多个操作(如扣库存 + 生成订单),但只算一次 TPS。
在实际工作中,这两个概念经常混用,但面试时一定要区分清楚。举个例子:
一个下单接口,内部调用了 3 次数据库查询 + 1 次 Redis 操作 + 1 次消息队列发送,对外暴露的 QPS 是 1000,但内部子系统承受的 QPS 远高于此。
容量规划中的 QPS 计算公式:
峰值 QPS = (日均请求量 × 峰值系数) / (24 × 3600)
假设日均请求量 2 亿,峰值系数 3(即峰值时段流量是均值的 3 倍),那么:
峰值 QPS = (200,000,000 × 3) / 86,400 ≈ 6,944
这是一个粗略的估算,实际场景中还需要考虑业务高峰的持续时间(如电商秒杀场景的"脉冲型"流量,可能在 1 秒内冲到均值的 10 倍以上)。
2.2 延迟(Latency):P50/P90/P99/P999 的统计学意义
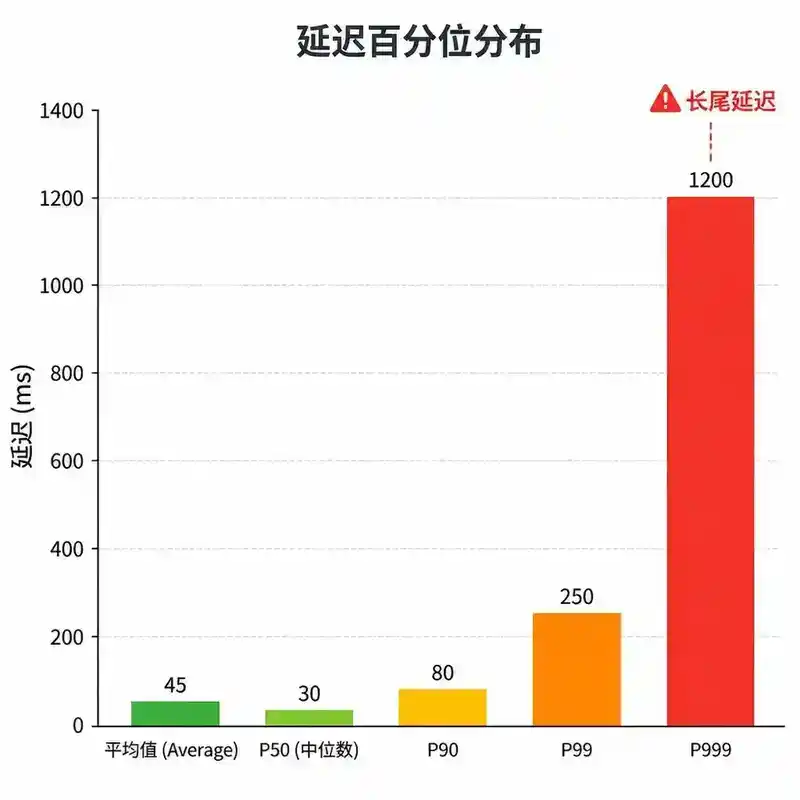
延迟衡量的是系统对单个请求的响应时间。容量规划中,用百分位数(Percentile) 来描述延迟分布,比用平均值更有意义:
| 百分位 | 含义 | 应用场景 |
|---|---|---|
| P50(中位数) | 50% 请求的延迟低于此值 | 表征"典型用户体验" |
| P90 | 90% 请求的延迟低于此值 | 发现尾部延迟的早期信号 |
| P99 | 99% 请求的延迟低于此值 | SLA 的核心指标,绝大多数在线服务以此为基准 |
| P999 | 99.9% 请求的延迟低于此值 | 高可用系统关注的"长尾延迟" |
为什么不用平均值? 假设一个服务处理了 1000 个请求:999 个在 10ms 内完成,1 个因为 GC 停顿了 10 秒。平均延迟 ≈ 20ms,看起来还不错。但 P99 = 10 秒,这 1% 的用户体验极差。平均值掩盖了分布的不均匀性,而百分位数暴露了它。
长尾延迟的来源:
- GC 停顿:Full GC 导致所有请求卡顿数百毫秒
- 操作系统调度:CPU 时间片被抢占
- 磁盘 IO 抖动:SSD 的 garbage collection
- 网络丢包重传:TCP 重传超时
- 锁竞争:热点 key 导致的排队等待
- 资源争抢:同一物理机上其他进程的干扰
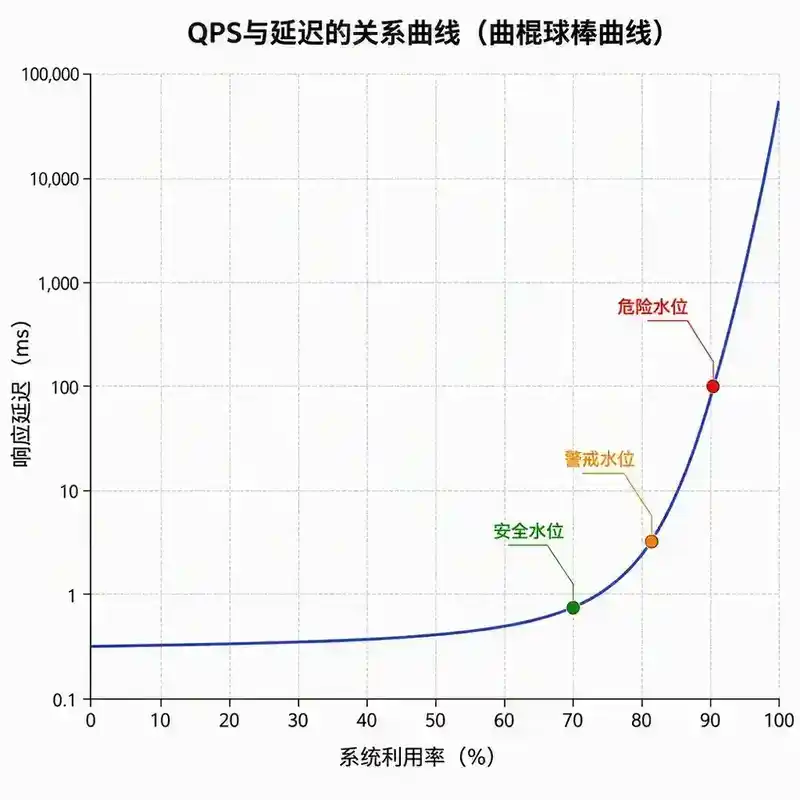
容量规划与延迟的关系:系统容量不是无限的。当负载接近容量上限时,延迟会呈非线性增长——这就是著名的"曲棍球棒曲线"。在 70% 利用率时,延迟可能只增加了 10%;到 90% 利用率时,延迟可能已经翻倍;到 95% 利用率时,系统可能已经不可用。因此,容量规划的核心目标之一,就是让系统运行在利用率与延迟的甜点区间。
2.3 峰值流量与均值的倍数关系
峰值流量是容量规划的第一输入。常见业务类型的峰值系数:
| 业务类型 | 典型峰值系数(峰值/均值) | 说明 |
|---|---|---|
| 企业内部系统 | 2-3 倍 | 工作时间集中,波动可预测 |
| 电商平台 | 3-5 倍 | 促销活动日峰值明显 |
| 电商大促 | 5-10 倍 | 双十一、618 等特定时段 |
| 社交/内容平台 | 2-4 倍 | 晚间高峰,周末效应 |
| 金融交易 | 5-20 倍 | 开盘/收盘时段高度集中 |
| 秒杀/抢购 | 50-100 倍 | 瞬发脉冲,秒级峰值 |
关键原则:不要用日均值做容量规划。必须以峰值流量为基准,还要考虑流量增长(如未来 6-12 个月的业务增长),以及安全冗余(通常 20%-50%)。
2.4 并发连接数、连接池与线程数
这三个概念经常被混淆,但它们衡量的是系统的不同维度:
- 并发连接数:同时建立的 TCP 连接数。受操作系统文件描述符限制(
ulimit -n),以及四元组(源 IP、源端口、目标 IP、目标端口)限制。一个客户端最多建立约 65,535 个到同一目标 IP:Port 的连接。 - 连接池大小:应用层维护的长连接数量。连接池过小导致请求排队,过大浪费数据库/Redis 等服务端资源。公式:
连接池大小 = ((核心线程数 × 2) + 有效磁盘数)是一个经验起点,但需根据实际 QPS 和 RT 动态调整。 - 线程数:操作系统线程或用户态协程。Java 中的线程数要结合 CPU 核心数和 IO 等待时间计算。
线程池大小估算公式(IO 密集型):
最佳线程数 = CPU 核心数 × (1 + IO等待时间 / CPU计算时间)
例如,CPU 8 核,每个请求 CPU 计算 10ms,IO 等待 90ms:
最佳线程数 = 8 × (1 + 90/10) = 80
实际生产环境中,线程数设置还要考虑上下文切换开销、内存占用(每个线程约 1MB 栈空间)等因素。
2.5 存储容量:数据量、增量与保留策略
存储容量规划的三个维度:
① 当前数据量:已有数据的总大小。包括业务数据、日志、索引、备份等。
② 日增量/月增量:每天新增的数据量。影响因素:
- 业务数据增长(订单、用户、日志等)
- 索引膨胀(MySQL 索引通常是数据量的 1.5-2 倍)
- 日志与监控数据(可能占存储的 50% 以上)
③ 保留策略:数据保留多久?超过保留期的数据如何归档/删除?
存储容量计算公式:
规划容量 = 当前数据量 + (日增量 × 保留天数) + 索引/冗余空间 + 安全缓冲(30%)
分库分表的存储考量:水平拆分时,每个分片的存储容量需要纳入规划。如果数据量持续增长,需要预留足够的分片数,并考虑扩容时的数据迁移成本。
2.6 带宽与网络吞吐
带宽是容易被忽视的容量维度。从链路角度,需要考虑:
- 公网带宽:用户请求进入系统的入口带宽。按峰值 QPS × 平均请求大小计算
- 内网带宽:服务间 RPC 通信、数据同步、消息队列产生的流量
- 跨机房/跨地域带宽:异地多活场景下的数据同步带宽
带宽估算公式:
峰值带宽(Mbps) = 峰值 QPS × 平均响应大小(KB) × 8 / 1000
例如,峰值 QPS = 10,000,平均响应大小 = 50KB:
峰值带宽 = 10,000 × 50 × 8 / 1000 = 4,000 Mbps = 4 Gbps
常见陷阱:只算了入口带宽,忽略了出口带宽不对称(云厂商的带宽通常是上下行分开计费)、内部服务间通信带宽、以及数据同步/备份产生的带宽消耗。
三、容量建模方法论
3.1 Little's Law:排队论视角下的容量理解
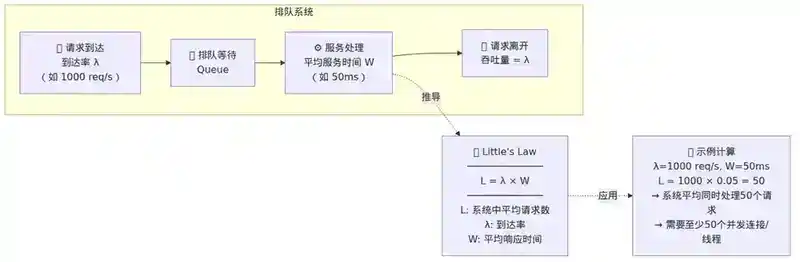
Little's Law 是排队论中最优雅的定理之一:
L = λ × W
其中:
- L:系统中平均的请求数(包括正在处理和排队等待的)
- λ:请求到达率(QPS)
- W:平均响应时间(RT)
直观理解:如果一个系统每秒处理 100 个请求(λ=100),每个请求平均耗时 0.1 秒(W=0.1),那么系统中平均同时存在的请求数 L = 100 × 0.1 = 10 个。
容量规划中的应用:
- 估算并发度:已知 QPS 和 RT,可以算出需要多少并发处理能力
- 瓶颈分析:如果 L 超过了系统能同时处理的上限,说明系统已经过载,请求开始排队
- 连接池大小校准:
连接池大小 ≈ L = λ × W,如果实际连接池远小于此值,说明连接池是瓶颈
实例:假设一个数据库代理,QPS=5000,P99 延迟=20ms,则:
L = 5000 × 0.02 = 100
这意味着代理需要至少 100 个并发连接才能无排队地处理所有请求。如果连接池只有 50,那么至少有 50 个请求需要排队等待。
3.2 通用可扩展性定律(USL):容量增长的物理上限
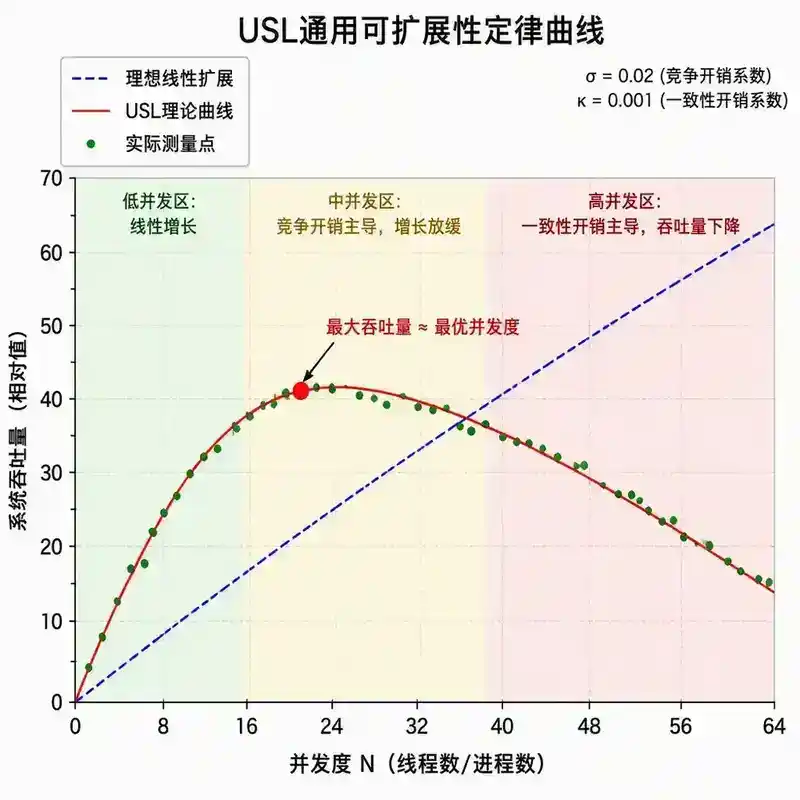
Amdahl 定律告诉我们,加速比受限于串行部分:
Speedup = 1 / (S + (1-S)/N)
其中 S 是串行部分占比,N 是处理器数量。当 S=5% 时,即使 N→∞,加速比上限也只有 20 倍。
通用可扩展性定律(Universal Scalability Law, USL) 更进一步,引入了一致性开销(coherence penalty):
C(N) = N / (1 + α(N-1) + βN(N-1))
其中:
- α:竞争度系数(contention),衡量共享资源争抢导致的性能退化
- β:一致性系数(coherency),衡量缓存一致性协议等开销
- N:并发度/节点数
实际意义:USL 画出的不是一条持续上升的曲线,而是一条先上升后下降的抛物线。这意味着盲目增加资源不仅不能提升容量,反而可能因为竞争和一致性开销导致性能下降。
容量规划中的启示:
- 单机容量有上限,不是堆 CPU 就能无限提升
- 水平扩展(加机器)也有上限,受限于分布式一致性开销
- 需要找到系统的"甜点"并发度,而不是无限追求高并发
3.3 资源消耗模型:CPU 密集型 vs IO 密集型 vs 内存密集型
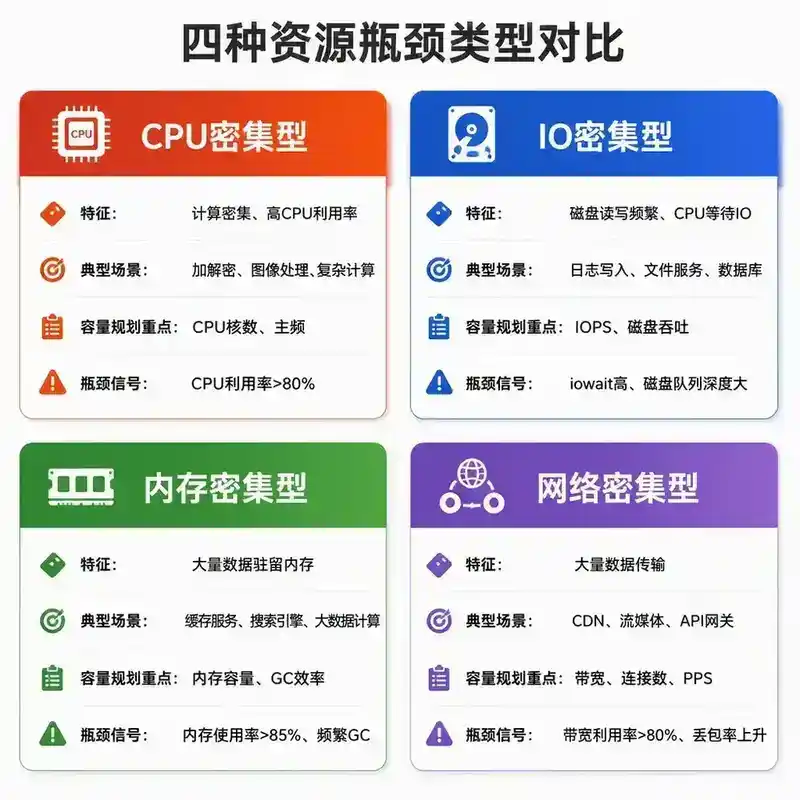
不同的系统,容量瓶颈维度不同。识别系统类型是容量规划的第一步:
| 类型 | 瓶颈资源 | 典型场景 | 容量规划重点 |
|---|---|---|---|
| CPU 密集型 | CPU 利用率 | 加解密、编解码、图像处理、复杂计算 | CPU 核心数、CPU 利用率水位 |
| IO 密集型 | IO 等待时间 | 数据库查询、RPC 调用、文件读写 | IO 吞吐(IOPS)、连接数、线程数 |
| 内存密集型 | 内存容量 | 缓存、搜索引擎、大数据计算 | 内存大小、GC 策略、堆外内存 |
| 网络密集型 | 网络带宽 | 文件传输、流媒体、API 网关 | 带宽、连接数、压缩比 |
混合型系统:大多数生产系统是混合型的。例如一个 Web 服务,业务逻辑偏 CPU,数据库查询偏 IO,缓存访问偏内存。容量规划时需要分别评估各维度的需求,取最紧张维度的瓶颈作为容量的上限。
资源利用率水位建议:
| 资源 | 安全水位 | 警戒水位 | 危险水位 |
|---|---|---|---|
| CPU | 60-70% | 80% | 90%+ |
| 内存 | 70-80% | 85% | 90%+ |
| 磁盘 IO | 70% | 80% | 90%+ |
| 网络带宽 | 60% | 75% | 85%+ |
| 连接数 | 60% | 75% | 85%+ |
3.4 单机容量基准测试:如何科学地压测
单机容量基准(Benchmark)是容量规划的基础数据。一个不科学的压测结果,会让整个容量规划建立在一个错误的基数上。
压测的四个关键原则:
① 隔离性:压测目标服务要部署在独立的环境(或至少独立实例),排除其他服务干扰。不要在共享数据库的连接池上压测单个服务,因为数据库可能是瓶颈。
② 阶梯加压:从低 QPS 开始,逐步增加,记录每个梯度的 QPS 和 RT。画出 QPS-RT 曲线,找到"延迟拐点"——即延迟开始非线性增长的 QPS 点。
③ 足够长的持续时间:每个梯度至少持续 5-10 分钟。短时间压测可能触发 JIT 编译优化,导致延迟虚低;也可能因为刚启动缓存未预热,导致延迟虚高。需要运行到稳态后再取数据。
④ 模拟真实流量:压测的请求分布要贴近线上真实流量。包括:
- 请求参数分布(热点与长尾)
- 读写比例
- 数据量级(缓存命中率高度依赖数据量)
- 请求大小分布
单机容量的确定:
单机容量 QPS = 延迟拐点 QPS × 0.7
取 70% 作为安全水位,留出 30% 缓冲应对流量波动和故障场景(如一台机器宕机后流量切换到其他机器)。
四、容量规划的实战流程
4.1 业务量预估:从业务指标到技术指标的转化
业务量预估是容量规划的起点,也是最容易出错的环节。常见的转化链路:
业务指标 → 技术指标 → 资源需求
示例:电商平台大促容量预估
| 步骤 | 输入 | 转化 | 输出 |
|---|---|---|---|
| 1. 业务指标 | 预估 DAU 5000 万,人均下单 0.1 次 | DAU × 人均下单 | 日均订单 500 万 |
| 2. 峰值系数 | 大促峰值时段 2 小时完成 60% 订单 | 日均订单 × 60% / 2h | 峰值订单 TPS = 416 |
| 3. 接口放大 | 一次下单涉及 20 个内部接口调用 | TPS × 接口放大系数 | 内部接口峰值 QPS = 8,320 |
| 4. 数据库放大 | 一次下单涉及 5 次数据库写 + 10 次读 | QPS × 数据库操作系数 | 数据库峰值 QPS = 124,800 |
| 5. 缓存放大 | 一次下单涉及 8 次缓存查询 | QPS × 缓存操作系数 | 缓存峰值 QPS = 66,560 |
注意:每一步的放大系数都需要通过线上监控数据或全链路压测来校准,不能拍脑袋。还要区分"稳态"和"瞬态"——秒杀场景的瞬态峰值可能远高于 2 小时均值。
4.2 单机容量评估:从压测到线性推演
有了单机基准容量和总需求 QPS,就可以计算需要的机器数量:
机器数 = 峰值 QPS / 单机容量 QPS × 安全系数
但线性推演有两个前提:
- 系统的瓶颈在应用层,下游依赖(数据库、缓存)能支撑更大的流量
- 系统是无状态的,可以水平扩展
不能线性推演的场景:
- 下游数据库是瓶颈:加应用机器不解决问题,需要对数据库做分库分表或读写分离
- 有状态服务:一致性哈希等方案下,增减机器涉及数据迁移
- 集中式资源:如全局唯一 ID 生成器、分布式锁服务
4.3 冗余与安全系数:N+1?2N?N+M?
冗余策略决定了容量规划中"多买多少":
| 策略 | 含义 | 适用场景 | 成本 |
|---|---|---|---|
| N+1 | 多 1 台冗余 | 可容忍单机故障,故障恢复快 | 低 |
| N+M | 多 M 台冗余 | 可容忍多台同时故障 | 中 |
| 2N | 100% 冗余 | 核心服务,严格要求高可用 | 高 |
| 异地多活 | 跨机房/地域冗余 | 金融级、灾备要求 | 最高 |
安全系数:除了物理冗余,还需要在容量上留出弹性:
实际资源 = 理论资源 × 安全系数(1.2-1.5)
安全系数考虑:
- 流量预估误差
- 系统性能退化(GC、内存碎片等)
- 故障转移时的流量放大(一台宕机,流量分摊到其他机器)
4.4 资源预算:从容量到成本的换算
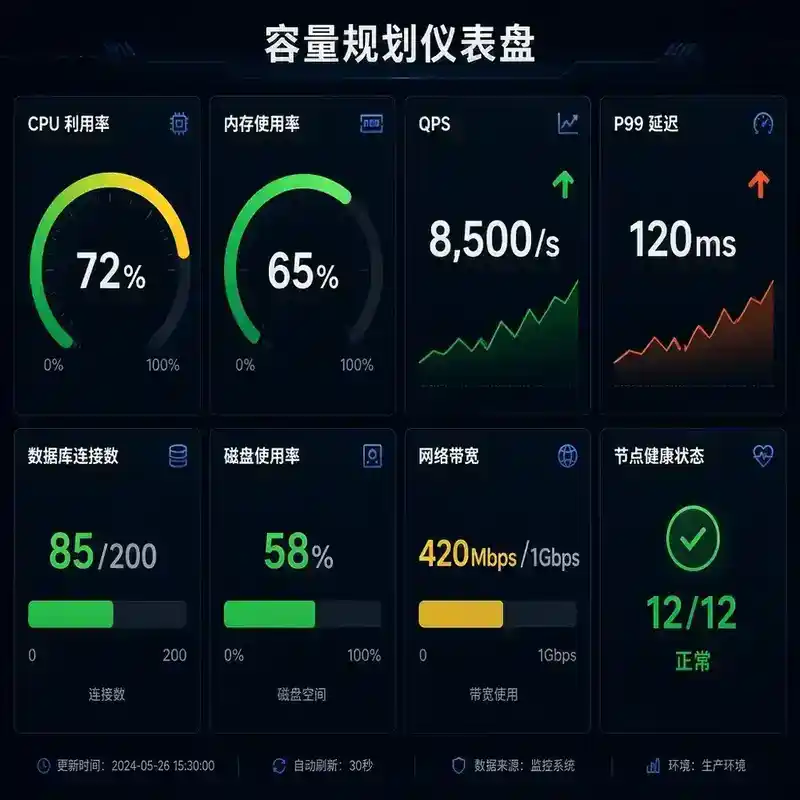
容量规划最终要落地为资源预算。以一个典型的微服务为例:
资源清单模板:
| 资源类型 | 规格 | 数量 | 单价 | 月成本 |
|---|---|---|---|---|
| 应用服务器 | 8C16G | 10 | ¥2,000 | ¥20,000 |
| 数据库 | 16C64G 高可用 | 1 主 2 从 | ¥8,000 | ¥24,000 |
| 缓存 | 16G 集群版 | 3 节点 | ¥3,000 | ¥9,000 |
| 消息队列 | 标准版 | 1 集群 | ¥5,000 | ¥5,000 |
| 对象存储 | 标准存储 | 10TB | ¥0.12/GB | ¥1,200 |
| 带宽 | 100Mbps | 1 | ¥1,500 | ¥1,500 |
| 合计 | ¥60,700/月 |
成本优化方向:
- 弹性伸缩:非峰值时段缩容,节省成本 30-50%
- 资源规格优化:避免过度配置(over-provisioning),通过压测数据找到最优规格
- 存储分层:热数据用 SSD,冷数据用对象存储
4.5 弹性伸缩与容量规划的关系
弹性伸缩不是容量规划的替代品,而是补充。二者的关系:
- 容量规划是"基线":确定常驻资源,保证日常流量稳定运行
- 弹性伸缩是"缓冲":应对流量波动,但受限于扩容速度(通常 1-5 分钟)
弹性伸缩的局限性:
- 扩容延迟:从触发告警到新实例 Ready,通常需要 2-5 分钟,秒杀场景根本来不及
- 资源池限制:云厂商可能在高峰期资源售罄
- 冷启动问题:新实例启动后缓存为空,需要预热
- 成本不可控:如果弹性伸缩参数设置不当,可能产生巨额账单
最佳实践:常驻资源覆盖 80% 的流量场景,弹性伸缩覆盖 20% 的峰值。大促等可预见的峰值,提前扩容而非依赖弹性伸缩。
五、典型案例分析
5.1 电商大促:从 DAU 到 TPS 的全链路推导
场景:某电商平台预计双十一当天 DAU 1 亿,订单量 2000 万单。
推导过程:
Step 1: 峰值时段订单量
- 假设 60% 订单集中在 0:00-2:00 的 2 小时内
- 峰值订单量 = 2000万 × 60% = 1200万
- 峰值下单 TPS = 1200万 / (2×3600) = 1667 TPS

Step 2: 内部接口 QPS 估算
- 下单链路涉及 20 个内部 RPC 调用
- 内部接口总 QPS = 1667 × 20 = 33,340 QPS

Step 3: 数据库 QPS 估算
- 每个订单 5 次写操作 + 10 次读操作
- 数据库总 QPS = 1667 × 15 = 25,005 QPS

Step 4: 缓存 QPS 估算
- 每个订单涉及 8 次缓存查询
- 缓存总 QPS = 1667 × 8 = 13,336 QPS

Step 5: 带宽估算
- 平均响应大小 30KB
- 峰值带宽 = 33,340 × 30 × 8 / 1000 ≈ 8,000 Mbps = 8 Gbps

Step 6: 机器数估算
- 单机压测容量 2000 QPS
- 应用机器数 = 33,340 / 2000 × 1.2(安全系数) ≈ 20 台
5.2 实时消息系统:长连接与带宽规划
场景:IM 系统,预计 100 万同时在线用户,每秒 10 万条消息。
容量规划要点:
连接数规划:
- 100 万长连接,假设每个连接内存占用 50KB(含缓冲区)
- 连接层总内存 = 100万 × 50KB = 50GB
- 单机最多维持 10 万长连接(受操作系统限制)
- 连接层机器数 = 100万 / 10万 = 10 台
带宽规划:
- 每条消息平均 1KB,每秒 10 万条消息
- 广播模式(1 对 N):如果群聊平均 50 人,下行带宽 = 10万 × 50 × 1KB × 8 / 1000 = 40,000 Mbps = 40 Gbps
- 点对点模式:下行带宽 = 10万 × 1KB × 8 / 1000 = 800 Mbps
这是一个典型的"带宽密集型"场景,容量瓶颈在带宽而非 CPU 或内存。
5.3 数据存储系统:数据增长与分片规划
场景:时序数据库,每天新写入 10TB 数据,保留 90 天,总数据量 900TB。
存储规划:
- 考虑 3 副本:900TB × 3 = 2.7PB 实际存储
- 单机存储 50TB:需要 2.7PB / 50TB ≈ 54 台存储节点
- 考虑索引膨胀(1.5 倍):54 × 1.5 = 81 台
分片规划:
- 按时间范围分片(如每天一个分片),90 天 = 90 个分片
- 分片数远小于节点数,每个节点可承载多个分片
- 预留 30% 容量:81 × 1.3 ≈ 105 台
关键考量:数据增长不是线性的。如果业务增长 50%,数据写入量也可能增长 50%,需要在规划中预留扩容能力。
六、总结
容量规划是架构师的核心能力之一,它连接了业务需求和技术资源。核心要点:
- 以峰值流量为基准,不是均值
- 用百分位数衡量延迟,不是平均值
- 单机容量 × 70% 作为安全水位
- Little's Law 理解并发与排队的关系
- USL 理解容量增长的物理上限
- 识别资源瓶颈类型(CPU/IO/内存/网络),精准投放资源
- 弹性伸缩是补充,不是替代——可预见的峰值提前扩容
- 容量规划是持续迭代的过程,需要定期回顾和校准
一个好的容量规划,不是"买足够多的机器"——那是烧钱。而是用最少的资源,稳定支撑最大的业务流量。
面试问答模块
以下问题从面试官视角出发,考察候选人是否真正理解容量规划的核心概念,而非死记硬背。
Q1:你们公司今年双十一预计订单量比去年增长 50%,作为架构师,你怎么做容量规划?请给出完整的推导过程。
参考答案:
第一步,拿到业务方的预估数据。增长 50% 意味着订单量翻 1.5 倍,但 DAU 的增长不一定是线性同步的——需要确认业务方给出的增长 50% 是基于什么口径(注册用户增量?营销预算增量?还是历史增速外推?)。不同的口径对应不同的置信度,也决定了安全系数怎么取。
第二步,从业务指标推导到技术指标,走全链路。假设去年峰值 TPS 是 1000,今年目标 1500。但下单链路涉及 20+ 个内部 RPC 调用,每个接口的放大系数不同。关键是不走平均放大系数,而是按接口逐个分析——有些接口是 1:1 映射(如用户信息查询),有些是 1:5(如库存扣减涉及多个仓库),有些是 1:20(如风控引擎的规则匹配)。最容易被忽略的是异步链路——消息队列的堆积量、消费速率,这些也要纳入容量评估。
第三步,识别瓶颈。去年大促后复盘,数据库连接池被打满是最常见的瓶颈。所以今年优先做数据库的容量评估:读 QPS → 读写分离是否足够?写 QPS → 主库是否需要进一步分库分表?缓存穿透场景 → 热点 key 是否做了本地缓存?
第四步,压测验证。用 1.5 倍目标 QPS 压测,观察各层指标。如果压测结果和理论推导偏差超过 20%,说明有未知瓶颈,需要定位后重新评估。
第五步,冗余和安全系数。理论需求乘以 1.3(安全系数),再加 N+1 物理冗余。最后输出一份容量清单:应用服务器 25 台 → 30 台(含冗余),数据库主库从 16C64G 升级到 32C128G,缓存集群从 3 节点扩到 5 节点,带宽从 5Gbps 扩到 8Gbps。
面试官想听的关键点:候选人是否知道"业务指标到技术指标不是简单乘系数"——每个接口的放大系数不同,需要逐个分析;是否知道"压测是验证,不是推导"——理论推导后再用压测校准;是否能在回答中体现复盘意识——去年的教训今年怎么避免。
Q2:你的服务 P99 延迟是 100ms,P50 是 5ms,用户投诉偶尔卡顿,你会怎么排查?这和容量规划有什么关系?
参考答案:
P50 5ms 说明绝大多数请求处理得很快,系统本身不慢。P99 100ms 说明有 1% 的请求经历了 20 倍的延迟恶化。这种"长尾延迟"的典型排查路径:
排查方向:首先看 GC 日志——是否 Full GC 导致 Stop-The-World?如果 P99 的尖刺和 GC 时间点对齐,问题就在 GC 上。其次看操作系统层面——vmstat 看 CPU 是否有被其他进程抢占(steal time),iostat 看磁盘 IO 是否偶发高延迟。再次看网络——ss -s 看 TCP 重传率,即使万分之一的重传也可能导致 P99 显著恶化。最后看业务逻辑——是否有热点 key 导致锁竞争,是否有慢 SQL 偶发(缺少索引导致全表扫描)。
与容量规划的关系:这个问题的本质是容量规划没做好——不是总容量不够,而是容量模型没有考虑延迟分布。如果容量规划只看了平均 QPS 和平均 RT,那 P99 100ms 的"长尾"会被完全掩盖。正确的容量规划要用 P99 延迟作为目标,而不是平均延迟。另外,如果系统已经接近容量上限(比如 CPU 利用率 80%+),即使平均延迟看起来还好,但请求排队会导致 P99 急剧恶化——这就是"曲棍球棒曲线"的尾部效应。
面试官想听的关键点:候选人是否知道"P50 好但 P99 差"的典型原因(GC、OS 调度、网络抖动),是否能把这种现象和容量规划联系起来(系统接近容量上限时 P99 会非线性恶化),是否知道长尾延迟对用户体验的影响(1% 的慢请求可能影响 20% 的用户,因为一个用户操作可能触发多个请求)。
Q3:为什么单机容量不能线性推演?什么情况下加机器反而会导致性能下降?请用 USL 定律解释。
参考答案:
单机容量不能线性推演,核心原因有三个:
竞争开销(Contention):这是 USL 中 α 系数描述的。多个线程/进程争抢共享资源——锁、连接池、数据库连接、文件描述符——争抢开销随并发度增加而非线性增长。比如一个全局锁,单线程时没有竞争,2 线程时竞争概率 50%,10 线程时几乎每次都要等待。这导致加速比不是线性的,而是趋向于 1/α 的上限。
一致性开销(Coherency):这是 USL 中 β 系数描述的。分布式系统中,节点间需要同步状态——缓存一致性协议、分布式事务的两阶段提交、Raft/Paxos 的日志复制。节点越多,每次状态变更需要同步的节点越多,一致性开销随 N² 增长。这就是 βN(N-1) 项的含义——当 N 足够大时,一致性开销会超过并行带来的收益,导致吞吐量反而下降。
加机器反而性能下降的典型场景:
- 分布式锁:10 台机器抢同一把锁,比 5 台机器抢锁的竞争激烈得多,等待时间更长。
- 缓存一致性:Redis 集群扩节点,如果使用了强一致性模式,节点间同步开销增大,写入延迟反而上升。
- 数据库分片过度:分 32 个库,但有些查询需要跨分片 join,导致需要查询多个分片后聚合,总延迟反而增加。
- 消息队列:Kafka 的 partition 数过多,每个 partition 的 leader 选举、ISR 同步开销导致吞吐量下降。
USL 的实践意义:不是"加机器就能提升容量",而是每个系统有一个最佳并发度。超过这个点后,继续加资源边际收益递减,甚至为负。这要求我们在容量规划中,通过压测找到系统的"甜点"并发度,并以此作为水平扩展的决策依据。
面试官想听的关键点:候选人是否理解 USL 的两个系数(α 竞争和 β 一致性)分别对应什么场景,能否举出"加机器反而变慢"的具体例子,是否知道水平扩展的天花板不是无限大。
Q4:容量规划中,你如何确定"安全水位"?为什么是 70% 而不是 80% 或 90%?
参考答案:
安全水位的确定基于三个因素的叠加:
延迟非线性增长:如"曲棍球棒曲线"所示,CPU 利用率在 70% 以下时,延迟增长几乎是线性的——利用率从 30% 到 60%,延迟可能只增加 20%。但从 70% 到 90%,延迟可能翻倍甚至更多。这不是 CPU 本身的问题,而是排队效应——利用率越高,请求排队的概率和等待时间呈指数增长。M/M/1 排队模型中,平均排队时间 = 服务时间 × 利用率 / (1 - 利用率)。当利用率 70% 时,乘数是 2.3;80% 时是 4;90% 时是 9;95% 时是 19。
故障转移的流量放大:假设 10 台机器,每台跑 70% 利用率。如果 1 台宕机,剩余 9 台承担 10 台的流量,利用率变为 70% × 10/9 ≈ 78%。如果水位是 80%,宕机后变成 89%,接近危险区。如果水位是 70%,宕机后是 78%,仍在安全区。这意味着 70% 水位天然支持 N+1 故障转移。
流量预估误差:业务预估通常有 10-20% 的误差。如果容量规划以 80% 水位做,业务预估偏低 20% 就直接冲到 96%,系统不可用。70% 水位给预估误差留了缓冲。
不同资源的安全水位不同:CPU 70% 是通用建议,但内存应该更低(80% 是因为 GC 需要在内存满之前触发),网络带宽应该更低(60% 是因为网络流量有突发性,TCP 的 burst 特性)。连接池的安全水位取决于连接建立成本——数据库连接池 60% 比较安全,因为连接耗尽后新请求直接失败,没有降级空间。
面试官想听的关键点:候选人是否知道 70% 是排队论推导出来的,不是拍脑袋;是否知道安全水位和故障转移的关系(N+1 场景下的利用率变化);是否知道不同资源的安全水位不同。
Q5:弹性伸缩能在多大程度上替代容量规划?请列举弹性伸缩解决不了的问题。
参考答案:
弹性伸缩不能替代容量规划,它们是互补关系。弹性伸缩解决不了的问题:
扩容延迟:从触发告警到新实例加入流量,通常需要 2-5 分钟。容器镜像拉取 30 秒,应用启动 30 秒,健康检查通过 30 秒,服务注册和负载均衡生效 30 秒——这些加起来已经 2 分钟了。对于秒杀场景,峰值流量可能只持续 30 秒,弹性伸缩根本来不及反应。
冷启动问题:新实例启动后,缓存为空,JIT 尚未充分编译,连接池需要建立。在这个"预热期"内,新实例的处理能力可能只有稳态的 30-50%。如果直接把流量切过来,新实例可能被瞬间打爆,触发新一轮扩容,形成"扩容-打爆-再扩容"的恶性循环。
数据库等有状态资源的瓶颈:弹性伸缩主要解决应用层的容量问题。如果瓶颈在数据库——连接数打满、主库写入压力过大——加应用机器不仅没用,反而增加数据库连接压力。数据库的扩容(分库分表、升级规格)需要提前规划,不能在业务高峰期做。
资源池限制:云厂商在高峰期(如双十一)可能资源售罄。你设了弹性伸缩策略,但触发了才发现没有可用资源。这不是假设——2021 年某云厂商在双十一期间确实出现了部分区域资源售罄的情况。
成本不可控:弹性伸缩如果参数设置不当,可能产生巨额账单。比如 CPU 阈值设得过低,每次微小的流量波动都触发扩容,月末账单翻倍。一个真实案例:某团队设了"CPU > 50% 扩容",结果一个 Bug 导致 CPU 空转,弹性伸缩不断扩容到 100 台,一天烧掉几万块。
跨地域/跨机房容灾:弹性伸缩通常在单地域内操作。如果需要异地多活,涉及 DNS 切换、数据同步、流量调度,这些不是弹性伸缩能解决的,需要容量规划提前设计。
最佳实践:容量规划确定基线资源(覆盖 80% 场景),弹性伸缩覆盖流量波动(20% 场景),大促等可预见峰值提前扩容。
面试官想听的关键点:候选人是否知道弹性伸缩的扩容延迟和冷启动问题,是否能举出真实的失败案例,是否理解"容量规划是基线、弹性伸缩是缓冲"的互补关系。
Q6:你负责一个核心服务,日常 QPS 5000,偶尔因运营活动飙到 50000。你的容量规划方案是什么?成本最优的方案是什么?
参考答案:
这是一个典型的"高均值比峰值"场景——峰值是均值的 10 倍。如果按峰值 50000 做常驻容量,成本是日常需求的 10 倍,不合理。
分层的容量方案:
常驻资源层(覆盖日常 + 可预期的波动):QPS 5000,按 1.5 倍冗余 → 7500 QPS 容量。如果单机 1000 QPS,需要 8 台(含 N+1 冗余)。这是基线,保障日常运行。
预扩容层(覆盖运营活动):运营活动通常是提前知道的——活动排期表、营销日历。在活动开始前 2 小时,手动或通过定时任务扩容到 50000 QPS 需要的容量。活动结束后缩容。这个方案的关键是扩容流程要自动化——一键扩容,而不是手动一台台加。
紧急弹性层(覆盖意外峰值):设弹性伸缩,但阈值设得保守——CPU 80% 持续 2 分钟才触发扩容,避免误触发。这个层是兜底的,不指望它解决主要问题。
成本最优方案:
- 常驻资源:8 台按包年包月购买(比按量便宜 30-50%)
- 预扩容资源:使用按量付费实例,活动前扩容、活动后释放,只在活动期间付费
- 配合资源预留(Reserved Instances):如果有规律性的活动(如每周五促销),购买周期性的预留实例比按量更便宜
额外的降级策略:如果运营活动的流量超出预期,不要无限制扩容——通过限流、降级保护核心链路。比如活动页面的非核心推荐模块降级,只保下单链路。
面试官想听的关键点:候选人是否知道"按峰值建常驻资源"是成本浪费,是否能给出分层的容量方案,是否知道包年包月和按量付费的成本差异,是否能在容量方案中融入降级策略。
Q7:Little's Law 在容量规划中如何应用?请用一个你实际经历过的场景举例说明。
参考答案:
Little's Law:L = λ × W,其中 L 是系统中的平均请求数,λ 是请求到达率(QPS),W 是平均响应时间。
我经历过的实际场景:做一个支付网关,下游对接了 5 个银行渠道。某次大促期间,发现支付成功率从 99.5% 降到 95%,排查发现是建设银行渠道超时严重。
用 Little's Law 分析:
- 建设银行渠道的 QPS(λ)≈ 200
- 超时时间设置是 3 秒,实际 P99 延迟 ≈ 2.5 秒
- 按 Little's Law,系统中同时存在的请求数 L = 200 × 2.5 = 500
- 但是支付网关到建设银行的连接池只配置了 100 个连接
结论:L=500 远大于连接池 100,说明有 400 个请求在排队等待。排队时间越来越长,最终触发 3 秒超时,导致支付失败。
解决方案:不是简单加大连接池——加大连接池会增加建设银行那边的压力,可能让银行侧也过载。正确的做法是:
- 对这个渠道增加限流,QPS 降到 100
- 超时时间从 3 秒降到 1.5 秒(快速失败,不堆积)
- 失败的请求走其他银行渠道(如果有可用渠道的话)或者排队重试
容量规划中的指导意义:Little's Law 告诉我们,连接池大小不能只看 QPS,还要看 RT。很多人设连接池只凭经验(比如数据库连接池默认 20),但正确做法是:连接池大小 = QPS × P99 延迟 × 1.5(冗余)。如果 QPS 5000,P99 延迟 20ms,连接池至少需要 5000 × 0.02 × 1.5 = 150。如果只设了 50,那就是瓶颈。
面试官想听的关键点:候选人是否能用 Little's Law 解释一个实际问题,是否知道 L 代表的是"系统中同时存在的请求数"(包括排队),是否能把 Little's Law 和连接池大小、线程池大小等实际配置联系起来。
Q8:数据库连接池大小怎么设置?和你估算的 QPS 数字有什么关系?
参考答案:
数据库连接池大小设置,有几种常用的方法:
方法一:Little's Law 推导(最推荐)
连接池大小 = 峰值 QPS × 平均 RT × 安全系数(1.3-1.5)
例如:峰值 QPS 2000,平均 RT 5ms → 2000 × 0.005 × 1.5 = 15。所以连接池至少 15。
方法二:HikariCP 官方公式(经验公式)
连接池大小 = ((CPU 核心数 × 2) + 有效磁盘数)
例如:8 核 CPU + 1 块 SSD = 17。这个公式来自 PostgreSQL 的性能测试,对于大多数 OLTP 场景适用。
方法三:压测校准(最准确)
在压测中逐步增加连接池大小,观察 QPS 和 RT 的变化。当连接池从 10 → 20 时 QPS 显著提升,但从 20 → 30 时 QPS 几乎不变——说明 20 就是最优值。超过最优值后,连接池越大,数据库端的上下文切换开销越大,反而可能降低性能。
和 QPS 的关系:连接池大小直接决定了应用能支撑的最大并发数据库请求数。如果 QPS 2000、RT 5ms,连接池只需 15,理论上 2000 QPS 不需要排队。但如果 QPS 增长到 4000,RT 变成 10ms,连接池需要 4000 × 0.01 × 1.5 = 60。如果连接池还是 15,那 75% 的请求需要排队,延迟会急剧恶化。
常见陷阱:
- 连接池设太大(如 200):超过数据库的 max_connections 限制,新连接直接失败。而且即使数据库能接受,200 个连接在数据库端的上下文切换开销也很大。
- 多个应用共享一个数据库:每个应用都设了 20 的连接池,10 个应用就是 200 个连接,可能超过数据库上限。容量规划时要算所有应用的总连接数。
- 连接泄漏:如果连接池 20,但代码中有未释放的连接,连接池会逐渐耗尽。这是容量规划中"连接数"维度要考虑的隐患。
面试官想听的关键点:候选人是否知道 Little's Law 和连接池大小的关系,是否知道 HikariCP 的经验公式,是否知道连接池不是越大越好,是否能把这个和 QPS 估算串联起来。
Q9:一个服务部署了 10 台机器,单机 8C16G,CPU 利用率都只有 15%,但 P99 延迟很高。问题出在哪?这和容量规划有什么关系?
参考答案:
CPU 15% 但 P99 很高,说明瓶颈不在 CPU,而在其他地方。这是一个典型的"容量规划只看 CPU 导致误判"的案例。排查方向:
1. IO 等待:CPU 15% 可能包含了大量的 iowait——线程在等待磁盘 IO 或网络 IO 时,CPU 是空闲的,但请求在等待。top 看 %wa(iowait),如果超过 10%,说明 IO 是瓶颈。可能是数据库慢查询、磁盘性能不足、RPC 调用超时。
2. 锁竞争:线程在等待锁时,CPU 是空闲的,但请求没有被处理。用 jstack 看线程状态,如果有大量 BLOCKED 或 WAITING 状态的线程,说明锁竞争严重。比如一个热点 key 的分布式锁,10 台机器在抢同一把锁,9 台在等待。
3. 连接池耗尽:虽然 CPU 只有 15%,但数据库连接池或 HTTP 连接池被打满,新请求在等待连接归还。用 jstack 看线程是否在 getConnection() 上阻塞。
4. 线程池饱和:线程池大小不够,请求在队列中排队。虽然处理中的请求 CPU 利用率不高,但整体吞吐量受限于线程数。Tomcat 默认线程池 200,如果业务 RT 是 500ms,200 个线程只能支撑 400 QPS。如果流量超过 400 QPS,多余请求在 TCP 队列排队,CPU 利用率也不高。
5. 下游瓶颈:P99 延迟高可能是因为下游服务(数据库、缓存、RPC)响应慢,应用层在等待下游返回。这种情况应用层 CPU 利用率低,但延迟高。
与容量规划的关系:这个案例说明容量规划不能只看 CPU 利用率。正确的容量规划是多维度的:CPU、内存、IO、连接数、线程数、下游 QPS,每个维度都要监控和评估。CPU 15% 的时候,可能连接数已经达到 90%,这才是真正的瓶颈。容量规划中要建立"瓶颈矩阵"——列举所有可能的瓶颈维度,逐个评估,取最紧张的作为容量上限。
面试官想听的关键点:候选人是否能跳出"CPU 不高就是没瓶颈"的思维定式,是否知道 IO 等待、锁竞争、连接池耗尽这些"低 CPU 高延迟"的常见原因,是否能把这个和容量规划的多维度评估联系起来。
Q10:你如何估算一个全新系统(没有历史数据)的容量需求?
参考答案:
没有历史数据的新系统容量估算,靠的是"类比 + 压测 + 迭代"。
第一步:业务类比。找业务形态相近的已有系统作为参考。比如要建一个短视频推荐系统,参考同类系统的数据:DAU 1000 万 → 峰值 QPS 5 万,单机扛 2000 QPS,需要 25 台。但这个类比只是粗略的起点,因为不同系统的计算复杂度差别很大。
第二步:技术拆解。把系统拆成链路,估算每个环节的 QPS 放大系数。比如一个推荐系统:
- 用户请求 → API 网关(1:1)
- API 网关 → 召回服务(1:10,一次请求触发 10 路召回)
- 召回服务 → 排序服务(1:1)
- 排序服务 → 特征服务(1:100,每个候选 item 需要 100 个特征)
- 特征服务 → Redis(1:100)
- 排序服务 → 重排服务(1:1)
如果用户请求 1000 QPS,Redis 的 QPS = 1000 × 10 × 100 = 100 万。这个数字很吓人,说明需要做缓存优化——特征可以做本地缓存,不需要每次查 Redis。
第三步:原型压测。搭建最小原型,用压测工具(JMeter、wrk)做单机 Benchmark。这是最可靠的容量数据来源。压测时注意:数据量要模拟真实规模(至少 100 万条),请求分布要模拟真实模式(热点数据 + 长尾数据),持续压测 10 分钟以上取稳态数据。
第四步:保守估算,预留弹性。新系统的容量估算偏差通常很大(可能差 50% 以上),所以:
- 安全系数取 1.5-2.0(比成熟系统的 1.3 更高)
- 架构设计上支持水平扩展(无状态化)
- 上线后第一周密切监控,根据实际数据调整
第五步:灰度验证。从 1% 流量开始灰度,逐步放量。每个阶段观察 24 小时,确认容量够用后再放下一阶段。如果某个阶段发现容量不够,立即回滚并扩容。
面试官想听的关键点:候选人是否知道新系统和成熟系统的容量规划方法不同,是否能讲出"技术拆解、估算放大系数"的方法,是否知道原型压测的注意事项(数据量、请求分布、持续时间),是否知道新系统的安全系数要取更高,是否有灰度验证的意识。
本系列文章基于《Java 技术专家 / 架构师面试:250 个高频考点总览》逐篇扩写。编号 196。