阅读时间:约 45 分钟 难度:中高级 适用人群:Java 技术专家、架构师、高级后端工程师
一、引言:高并发不是"加机器"那么简单
你在凌晨三点被报警电话叫醒——线上服务 QPS 突然翻了 10 倍,CPU 飙到 95%,接口响应时间从 50ms 拉到了 5s。你第一反应是什么?"扩容!加机器!"
但如果加机器真的能解决一切,架构师这个岗位就不存在了。
高并发系统设计本质上是一道资源约束下的最优化问题:给定有限的预算、时间和人力,如何让系统在流量洪峰下依然稳定、快速、正确地响应请求。它不是一个技术点,而是一套系统化的方法论,包含四个核心环节:
- 流量估算:先算清楚账,知道系统要扛多少量
- 瓶颈识别:找到系统的阿喀琉斯之踵
- 分层优化:从接入层到数据层,逐层击破
- 容量冗余:为不可预知的流量留出安全边际
本文将以"设计一个支持千万 DAU 的秒杀系统"为主线,带你走完这四步。
二、流量估算:在写代码之前,先把账算清楚
架构师的第一项基本功不是画图,是算数。
2.1 核心指标
| 指标 | 含义 | 典型问法 |
|---|---|---|
| DAU / MAU | 日活 / 月活用户数 | "系统要支持多少用户?" |
| QPS | 每秒查询数 | "高峰期每秒多少请求?" |
| TPS | 每秒事务数 | "每秒完成多少笔订单?" |
| RT / P99 | 响应时间 / 99 分位延迟 | "接口响应时间要求多少?" |
| 并发连接数 | 同时保持的连接 | "长连接还是短连接?" |
| 带宽 | 网络吞吐量 | "单次请求/响应多大?" |
2.2 估算公式
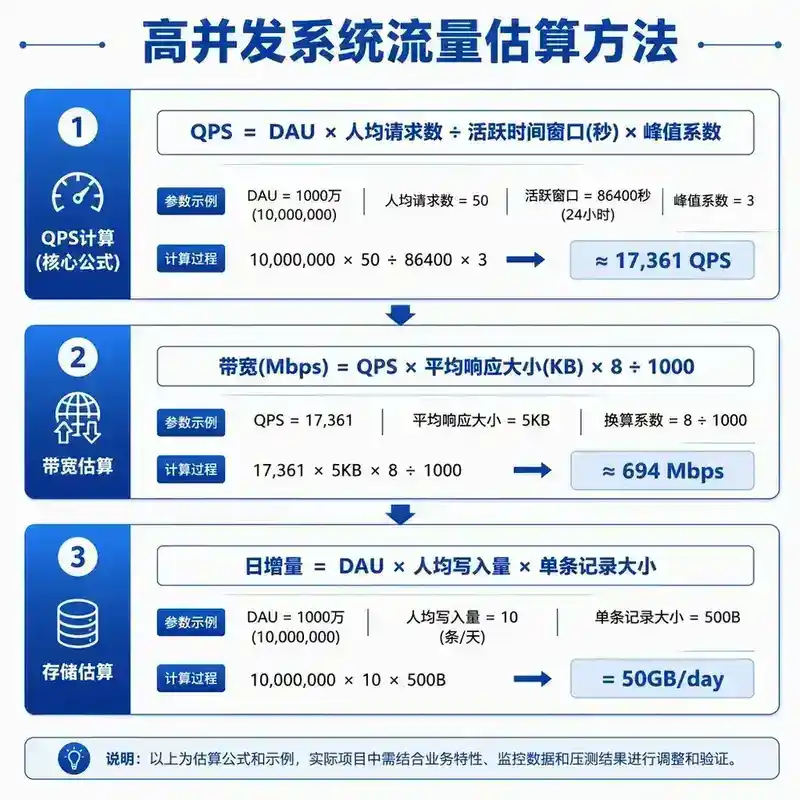
QPS 估算:
QPS = DAU × 人均请求数 ÷ 活跃时间窗口(秒) × 峰值系数
以千万 DAU 的电商 App 为例:
- DAU = 10,000,000
- 人均请求数 ≈ 50 次(浏览商品、搜索、下单、查看物流等)
- 活跃时间窗口 ≈ 12 小时 = 43,200 秒(用户不会均匀分布,假设集中在 12 小时内)
- 平均 QPS = 10,000,000 × 50 ÷ 43,200 ≈ 11,574
但这只是平均。真正要命的是峰值:
- 峰值系数通常取 3~5 倍(取决于业务特征,秒杀场景可能到 10~50 倍)
- 峰值 QPS = 11,574 × 5 ≈ 57,870 QPS
秒杀场景的特殊性:
秒杀不是均匀流量,而是在某个时间点(如 10:00:00)的瞬时脉冲:
- 假设 1000 万人同时在 10:00 点抢 1 万件商品
- 前 1 秒的 QPS 可能达到 数百万级别
- 这就是为什么秒杀需要独立隔离的设计
带宽估算:
带宽(Mbps) = QPS × 平均响应大小(KB) × 8 ÷ 1000
假设平均响应 5KB,峰值 QPS 57,870:
- 带宽 = 57,870 × 5 × 8 ÷ 1000 ≈ 2,315 Mbps ≈ 2.3 Gbps
2.3 存储估算
数据库存储:
日增量 = DAU × 人均写入量 × 单条记录大小
假设每人每天产生 5 条订单记录,每条 1KB:
- 日增量 = 10,000,000 × 5 × 1KB ≈ 50 GB/天
- 年增量 ≈ 18 TB
- 保留 3 年 = 54 TB
缓存存储:
缓存容量 = 热点数据量 × 副本系数 × 内存膨胀系数
- 热点商品数据 ≈ 10 万条 × 2KB = 200 MB
- 副本系数(Redis Cluster)= 2(一主一从)
- 内存膨胀系数(Redis 内部结构开销)≈ 1.5
- 缓存容量 ≈ 200MB × 2 × 1.5 = 600 MB
面试官常问:"一个千万 DAU 的系统,带宽需要多少?"——这就是在考察你能否快速估算。
2.4 流量估算的常见陷阱
- 忽略峰值系数:平均 QPS 看起来不大,但峰值可能翻 10 倍。很多系统平时好好的,一到双十一就挂,就是因为按均值设计的。
- 忽略长尾请求:P99 延迟可能是 P50 的 10 倍。不能用平均响应时间来算并发数。
- 忽略网络开销:RPC 框架的序列化开销、TCP 握手、TLS 加密——这些都会吃掉带宽和处理时间。
- 忽略放大效应:一个前端请求可能触发 10 个后端 RPC 调用。QPS 要在每一层分别估算。
三、瓶颈识别:找到最短的那块木板
你说系统慢,到底慢在哪?CPU、内存、磁盘、网络、还是锁?
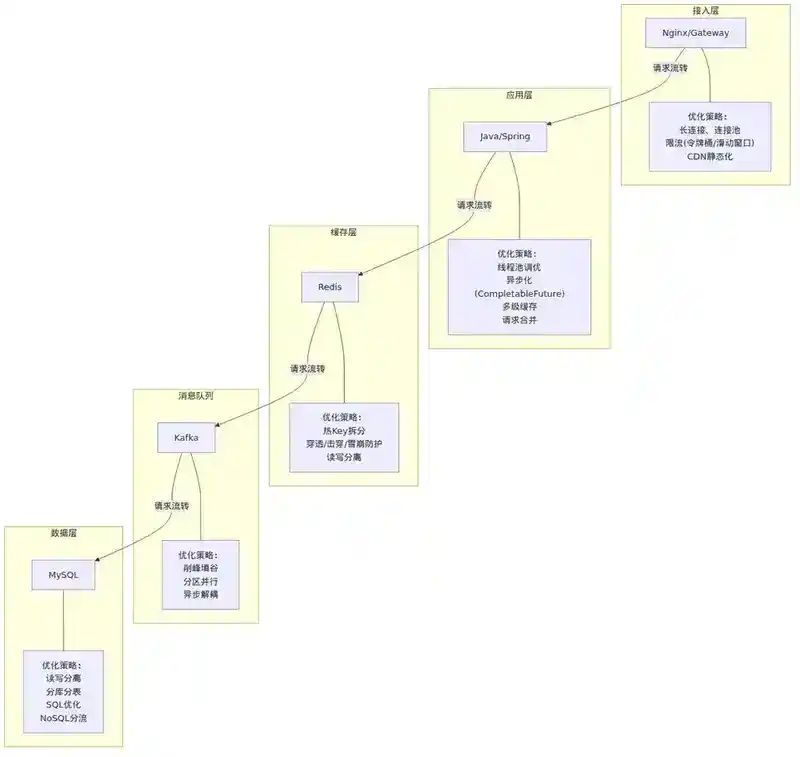
3.1 分层分析框架
┌─────────────────────────────────┐
│         接入层 (Nginx/Gateway)    │  ← 连接数、带宽
├─────────────────────────────────┤
│         应用层 (Java/Spring)      │  ← CPU、线程池、GC
├─────────────────────────────────┤
│         缓存层 (Redis)            │  ← 内存、连接数、热Key
├─────────────────────────────────┤
│         消息队列 (Kafka/RocketMQ)  │  ← 吞吐量、分区数、消费速度
├─────────────────────────────────┤
│         数据层 (MySQL/ES)         │  ← IOPS、连接数、慢SQL
└─────────────────────────────────┘
每一层都有各自的瓶颈特征,需要分别诊断。
3.2 瓶颈识别方法
方法一:压测驱动
压测不是"跑一下 JMeter 看看 TPS 多少",而是有方法论的系统工程:
| 压测类型 | 目的 | 做法 |
|---|---|---|
| 基准压测 | 确定单机极限 | 单接口逐步加压,找到 QPS 拐点 |
| 负载压测 | 验证预期容量 | 按预估峰值 QPS 持续施压 |
| 压力压测 | 找系统崩溃点 | 持续加压直到系统不可用 |
| 稳定性压测 | 验证长时间运行 | 80% 峰值负载跑 24 小时 |
| 混合压测 | 模拟真实流量 | 多接口按真实比例混合施压 |
压测时的关键观察指标:
- QPS 拐点:QPS 不再随并发数线性增长时的点——这是系统的容量上限
- RT 拐点:响应时间突然陡增的点——通常意味着某个资源饱和
- 错误率:什么时候开始出现超时/5xx——这是系统的可用性边界
方法二:监控驱动
生产环境的瓶颈识别靠监控体系:
瓶颈识别 = 指标采集 → 异常检测 → 关联分析 → 根因定位
| 层级 | 关键指标 | 报警阈值示例 |
|---|---|---|
| 接入层 | 连接数、4xx/5xx 比例、SSL 握手耗时 | 5xx > 1% |
| 应用层 | CPU、内存、GC 频率/耗时、线程池队列长度 | Full GC > 1次/小时 |
| 缓存层 | 命中率、内存使用率、慢查询、连接数 | 命中率 < 90% |
| 数据层 | 慢 SQL、连接数、IOPS、主从延迟 | 慢 SQL > 50 条/分钟 |
方法三:代码级诊断
- 线程 Dump:
jstack <pid>看线程卡在哪——是等锁、等 IO、还是等网络? - 火焰图:CPU 时间花在哪?是业务逻辑还是框架开销?
- Arthas:在线诊断神器,
trace看调用链耗时,watch看入参出参 - GC 日志:
-XX:+PrintGCDetails看 GC 是否频繁
3.3 常见瓶颈及典型症状
| 瓶颈位置 | 典型症状 | 原因 |
|---|---|---|
| 数据库连接池 | 应用日志大量 getConnection timeout |
连接池太小或慢 SQL 占着连接不放 |
| 线程池饱和 | 接口 RT 突然增大,但 CPU 不高 | 线程都在等下游响应,池子耗尽 |
| Redis 热 Key | 某台 Redis 节点 CPU 100%,其他节点空闲 | 单个 Key 的 QPS 过高(如秒杀商品库存) |
| JVM Full GC | 周期性 STW,接口 RT 毛刺 | 堆内存不够或大对象频繁晋升 |
| 网卡打满 | 所有接口都慢,但 CPU/内存正常 | 带宽瓶颈,需要升级网卡或压缩 |
| 锁竞争 | 增加机器 QPS 不涨 | synchronized 或分布式锁成为瓶颈 |
四、分层优化:每一层都有它的武器
优化不是加缓存那么简单。真正的优化是从上到下,每一层都有不同的策略。
4.1 接入层优化
接入层是流量的第一道关口,这里的优化目标是:快速过滤无效请求,保护后端。
(1)连接优化
- 长连接:对高频调用场景,用 HTTP/2 或 gRPC 的长连接替代短连接,减少 TCP 握手和 TLS 开销
- 连接池:后端服务之间使用连接池复用,避免频繁建连/断连
- Linux 内核参数调优:
(2)限流
限流不是"不让用户访问",而是"让系统在能力范围内服务尽可能多的用户"。
| 限流算法 | 原理 | 适用场景 |
|---|---|---|
| 固定窗口 | 每秒/每分钟固定 N 个请求 | 简单,但边界突刺问题 |
| 滑动窗口 | 统计过去 N 秒的请求数 | 平滑,Redis + Lua 实现 |
| 漏桶 | 固定速率消费 | 保护下游,但可能丢弃突发流量 |
| 令牌桶 | 固定速率放令牌,突发可取 | 允许一定突发,更灵活 |
| 滑动日志 | 记录每次请求时间戳 | 最精确,但内存开销大 |
生产实践:Sentinel 的滑动窗口 + 令牌桶组合,单机 QPS 限流误差 < 1%。
(3)静态化与 CDN
- 商品详情页中 80% 的内容是静态的(图片、CSS、JS、商品描述)
- 把静态资源推到 CDN,动态数据用 Ajax 异步加载
- 页面整体做 CDN 缓存(边缘节点),回源频率降到最低
4.2 应用层优化
(1)线程模型调优
Tomcat 默认 200 线程,但"线程多 ≠ 吞吐高":
最优线程数 ≈ CPU 核心数 × (1 + 等待时间/计算时间)
如果服务是 IO 密集型(等待时间远大于计算时间),线程数可以设大一些;如果是 CPU 密集型,线程数接近 CPU 核心数即可。
(2)异步化
同步模型:Request → 查DB(100ms) → 调RPC(50ms) → Response = 150ms/请求
异步模型:Request → CompletableFuture.allOf(查DB, 调RPC) → Response = 100ms/请求
关键收益不是单请求变快,而是线程利用率提升——同样 200 个线程能处理更多请求。
(3)本地缓存 + 多级缓存
请求 → 本地缓存(Caffeine) → 分布式缓存(Redis) → 数据库
- 本地缓存(Caffeine):微秒级响应,但容量有限,多机一致性差
- 分布式缓存(Redis):毫秒级响应,多机共享,但有网络开销
- 数据库:最终兜底
缓存更新策略:
| 策略 | 做法 | 优缺点 |
|---|---|---|
| Cache Aside | 读:先查缓存,miss 读 DB 并回填;写:先写 DB,再删缓存 | 最常用,但可能有短暂不一致 |
| Read/Write Through | 缓存层代理读写 DB | 一致性好,但实现复杂 |
| Write Behind | 先写缓存,异步刷 DB | 写入快,但可能丢数据 |
(4)请求合并与批处理
- 把 N 个单独的查询合并成 1 个批量查询
- 比如:
getUserById(1),getUserById(2),getUserById(3)→getUserByIds([1,2,3]) - 减少了 N-1 次网络往返
4.3 缓存层优化
(1)Redis 热 Key 问题
秒杀场景下,单个商品的库存 Key 可能被几十万 QPS 访问,打爆单台 Redis。
解决方案:
- 本地缓存前置:在应用层用 Caffeine 缓存热点数据,只定期从 Redis 刷新
- 读写分离:热点 Key 的读请求分散到多个从节点
- Key 拆分:把
stock:item_123拆成stock:item_123_0~stock:item_123_9,随机路由 - Redis Cluster:利用多分片分散压力(但热点 Key 仍在同一个 slot)
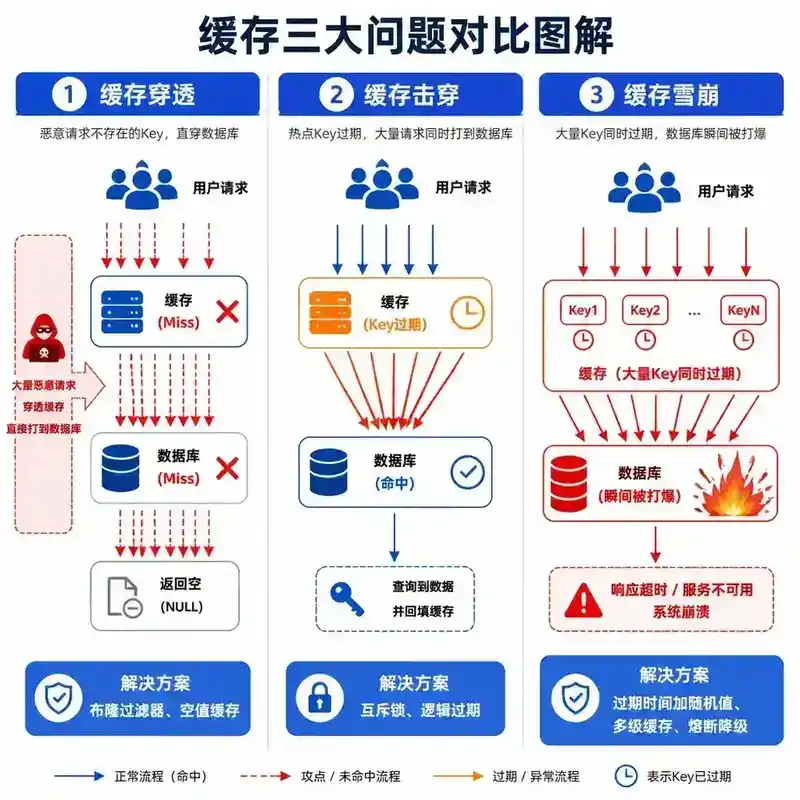
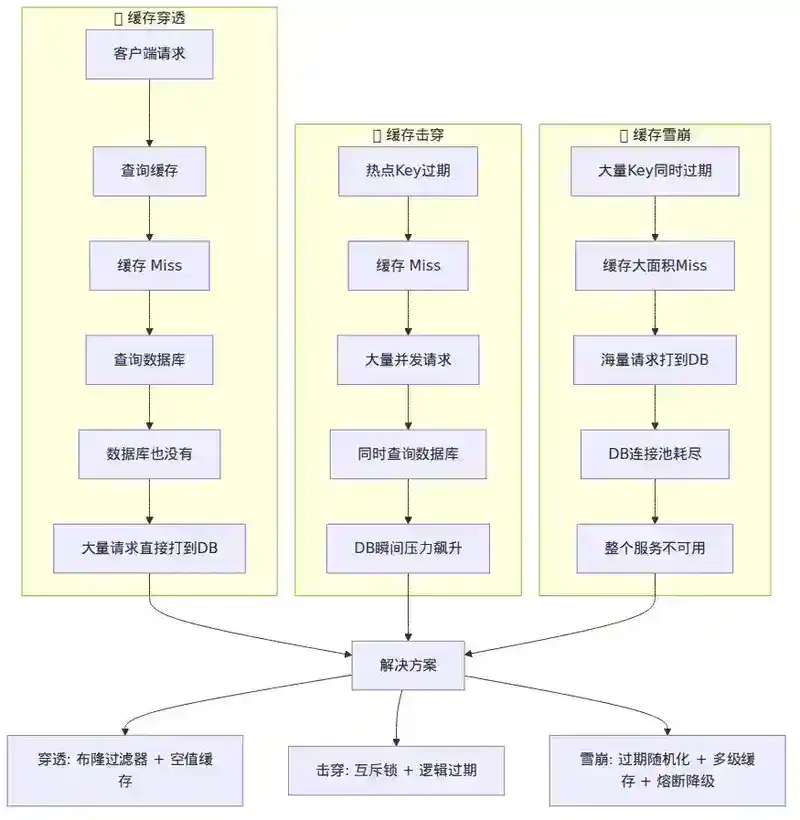
(2)缓存穿透、击穿、雪崩
| 问题 | 现象 | 解决方案 |
|---|---|---|
| 穿透 | 查不存在的数据,缓存和 DB 都没有 | 布隆过滤器、空值缓存 |
| 击穿 | 热点 Key 过期,大量请求打到 DB | 互斥锁、逻辑过期、永不过期 |
| 雪崩 | 大量 Key 同时过期,DB 瞬间被打爆 | 过期时间加随机值、多级缓存、熔断降级 |
(3)缓存一致性
不要追求"强一致性"——缓存和 DB 的最终一致性是工程上可以接受的。如果要强一致,直接用 DB,别用缓存。
4.4 数据层优化
(1)读写分离
写 → Master
读 → Slave1, Slave2, Slave3
- 一主多从,写走主库,读走从库
- 注意主从延迟:关键业务(如扣库存后的查库存)必须走主库
(2)分库分表
当单表数据量超过 2000 万行或单库 QPS 超过 2000 时,需要考虑分库分表:
分库分表 = 垂直拆分 × 水平拆分
- 垂直拆分:按业务域拆(用户库、订单库、商品库)
- 水平拆分:按分片键拆(user_id % 64)
分片键选择是最关键的决策——选错了改起来代价巨大:
- 选访问频率最高的字段做分片键(如
user_id) - 尽量避免跨分片查询
- 如果需要按多个维度查询,考虑数据异构(如用 ES 做多维度索引)
(3)SQL 优化
- 覆盖索引:
SELECT id, name FROM user WHERE age > 18→ 建(age, id, name)联合索引 - 避免
SELECT *:只查需要的列,减少 IO 和网络传输 - 分批处理:
LIMIT 10000, 1000→ 用WHERE id > last_id LIMIT 1000替代 - 连接池配置:HikariCP 默认 10 连接,按需调整,但不要超过
max_connections / 服务实例数
(4)NoSQL 分流
- 商品搜索 → Elasticsearch(倒排索引)
- 商品详情 → MongoDB(文档模型,灵活 Schema)
- 时序数据 → TDengine / InfluxDB
- 计数服务 → Redis(原子操作)
五、容量冗余:为黑天鹅留出安全边际
容量冗余不是浪费,是保险。
5.1 容量规划
目标容量 = 预估峰值 QPS × 冗余系数
- 冗余系数通常取 1.5~3 倍(取决于业务重要性和弹性能力)
- 对于双十一这种确定性大促:提前 1~2 个月扩容,按预估峰值的 3 倍准备
- 对于突发热点事件(微博热搜、突发事件):依赖弹性伸缩
5.2 弹性伸缩
(1)Kubernetes HPA
# 基于 CPU 的自动伸缩
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
spec:
  minReplicas: 5
  maxReplicas: 100
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
关键注意事项:
- 伸缩不是瞬间完成的——从触发到新 Pod 就绪需要 1~3 分钟
- 需要预留足够的缓冲容量来覆盖这段"伸缩窗口"
- 缩容要谨慎——避免"抖动"(刚扩容又缩容,反复横跳)
(2)提前扩容 vs 被动伸缩
| 策略 | 做法 | 适用 |
|---|---|---|
| 定时扩容 | 大促前手动扩容 | 可预知的流量高峰 |
| 预测式扩容 | 基于历史数据的 AI 预测 | 有规律的流量模式 |
| 响应式伸缩 | 基于实时指标的 HPA | 不可预知的流量变化 |
5.3 降级与熔断
当流量超过系统容量时,与其让整个系统崩溃,不如有策略地放弃。
降级策略:
| 降级等级 | 措施 | 示例 |
|---|---|---|
| 一级(非核心) | 关闭推荐、排行榜、评论 | 用户仍可下单 |
| 二级(弱依赖) | 关闭个性化、广告 | 返回默认数据 |
| 三级(核心) | 限流排队、验证码 | "前方拥挤,请稍后再试" |
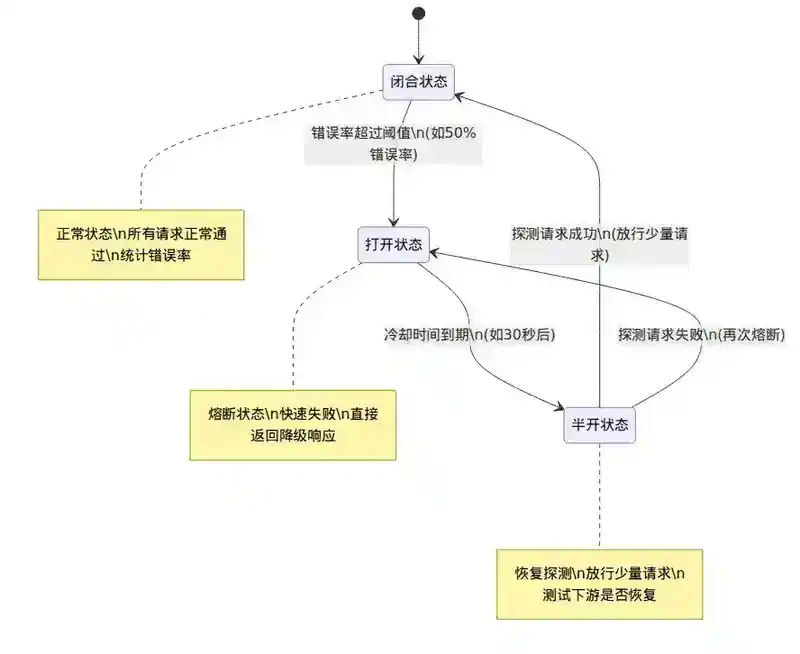
熔断机制:
闭合 → (错误率>阈值) → 打开 → (冷却时间到) → 半开 → (探测成功) → 闭合
Sentinel / Hystrix / Resilience4j 的熔断器模式:
- 错误率达到阈值(如 50%)→ 熔断器打开,快速失败
- 冷却时间后 → 半开状态,放行少量请求探测
- 探测成功 → 关闭熔断器,恢复正常
5.4 隔离策略
物理隔离:秒杀系统独立部署,不和普通交易混在一起
逻辑隔离:
- 线程池隔离:不同业务用不同线程池
- 信号量隔离:限制并发调用数
- 集群隔离:给核心服务分配独立集群
数据隔离:
- 秒杀的库存数据独立存储(Redis),不和普通商品库存混在一起
- 秒杀订单先写队列,异步落库,不和普通订单抢数据库连接
六、实战案例:秒杀系统设计全景
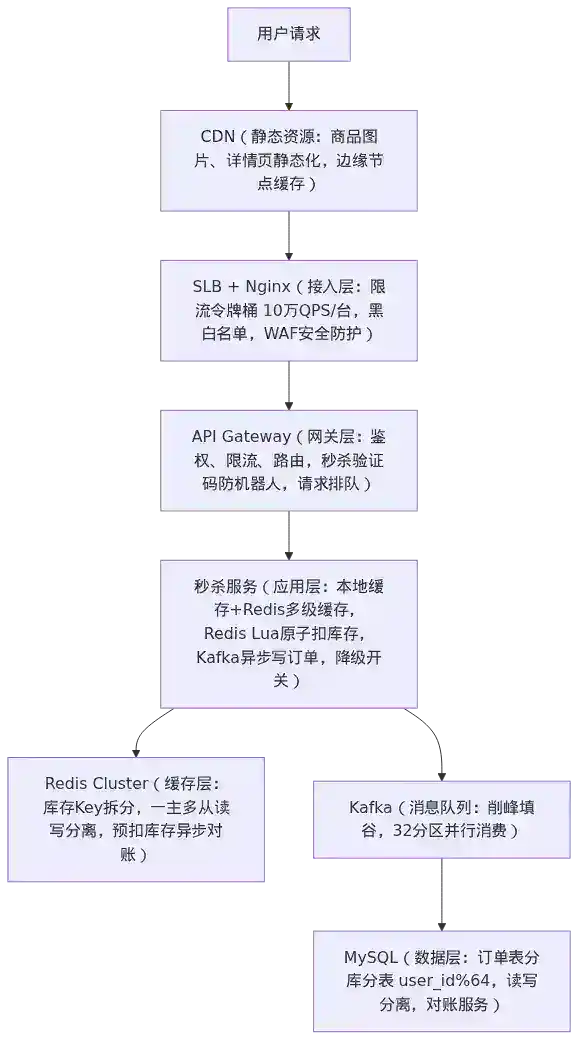
把前面的方法论串起来,设计一个千万级秒杀系统:
用户请求
    │
    ▼
┌──────────────────────────────────────┐
│  CDN (静态资源)                        │
│  - 商品图片、详情页静态化               │
│  - 边缘节点缓存,回源率 < 5%            │
└──────────────────────────────────────┘
    │
    ▼
┌──────────────────────────────────────┐
│  SLB + Nginx (接入层)                  │
│  - 限流:令牌桶,10万 QPS/台            │
│  - 黑白名单、WAF 安全防护               │
│  - 静态请求直接返回,动态请求透传        │
└──────────────────────────────────────┘
    │ (动态请求)
    ▼
┌──────────────────────────────────────┐
│  API Gateway (网关层)                  │
│  - 鉴权、限流、路由                     │
│  - 秒杀验证码(防机器人)                │
│  - 请求排队:超过阈值入队列,返回排队号   │
└──────────────────────────────────────┘
    │
    ▼
┌──────────────────────────────────────┐
│  秒杀服务 (应用层)                      │
│  - 本地缓存 + Redis 多级缓存            │
│  - 库存扣减:Redis Lua 原子操作         │
│  - 订单异步:写入 Kafka,异步落库       │
│  - 降级开关:动态调整限流阈值            │
└──────────────────────────────────────┘
    │
    ▼
┌──────────────────────────────────────┐
│  Redis Cluster (缓存层)                │
│  - 库存 Key 拆分,避免热点              │
│  - 一主多从,读写分离                   │
│  - 预扣库存,异步对账                   │
└──────────────────────────────────────┘
    │
    ▼
┌──────────────────────────────────────┐
│  Kafka (消息队列)                      │
│  - 削峰填谷,订单异步处理               │
│  - 32 分区,并行消费                    │
└──────────────────────────────────────┘
    │
    ▼
┌──────────────────────────────────────┐
│  MySQL (数据层)                        │
│  - 订单表分库分表 (user_id % 64)       │
│  - 读写分离                             │
│  - 对账服务:Redis 库存 vs DB 库存      │
└──────────────────────────────────────┘
核心流程:
- 用户点击"抢购" → 经过验证码校验(防机器人)
- 请求进入排队队列,超出阈值直接返回"已售罄"
- 秒杀服务执行
Redis Lua 脚本:if stock > 0 then stock--; return 1 else return 0 - 扣减成功后,发送 Kafka 消息(包含用户 ID、商品 ID、时间戳)
- 订单服务消费 Kafka 消息,写入 MySQL
- 前端轮询获取结果
关键数字:
- 接入层:10 台 Nginx,每台 10 万 QPS → 总计 100 万 QPS
- 秒杀服务:50 个 Pod,每台 2000 QPS → 总计 10 万 QPS(经过限流和排队,实际穿透到后端的只有这么多)
- Redis:3 主 3 从 Cluster,单节点 10 万 QPS
- Kafka:32 分区,每分区 10 MB/s 写入
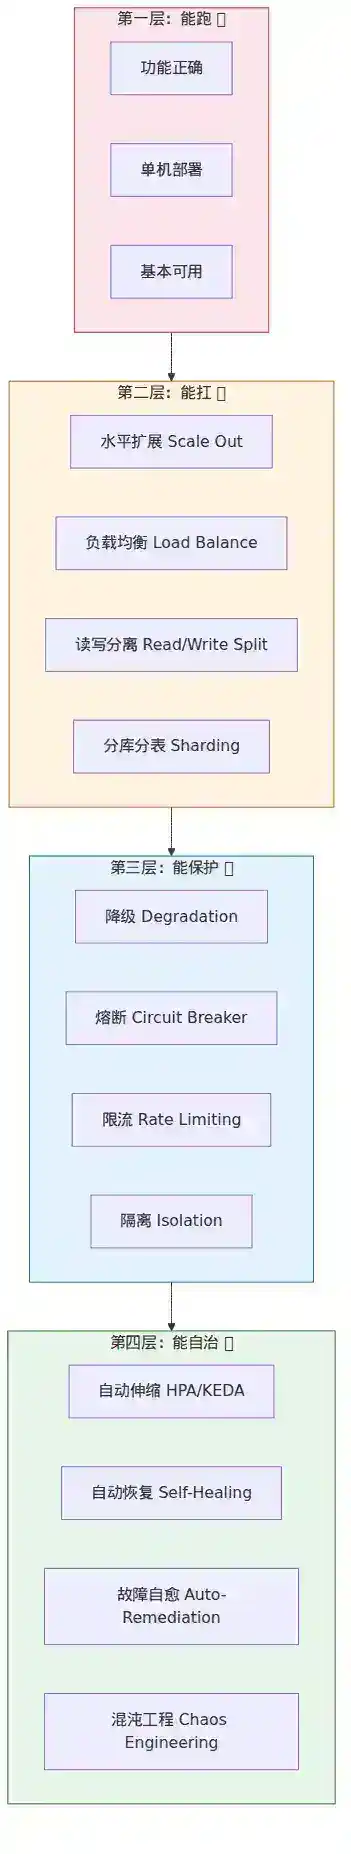
七、总结:高并发设计的四个层次
第一层:能跑     → 功能正确,单机能跑通
第二层:能扛     → 加机器能线性扩展,没有单点瓶颈
第三层:能保护   → 有降级、熔断、限流,流量过载不会雪崩
第四层:能自治   → 自动伸缩、自动恢复、故障自愈
大多数团队停留在第一层和第二层之间。真正的架构师需要把系统带到第三层甚至第四层。
记住这四句话:
- 先算账,再动手:流量估算不是走过场,它决定了整个架构的选型
- 瓶颈在哪,优化在哪:不要凭感觉优化,要用压测和监控数据说话
- 分层思考,逐层击破:接入层、应用层、缓存层、数据层——每一层都有专门的技术武器
- 永远留有余量:容量冗余和降级熔断是最后的保险,关键时刻能救命
八、面试官视角提问
以下问题从面试官视角出发,考察你是否真正理解了高并发设计的本质,而非死记硬背。
Q1:如果让你设计一个支持 1 亿 DAU 的短视频 App 的点赞系统,你会怎么估算流量?请一步步算出来。
点击查看思路
1 亿 DAU,假设每人每天点赞 20 次,活跃时间 12 小时:
- 平均 QPS = 1亿 × 20 ÷ 43200 ≈ 46,296
- 峰值系数取 5,峰值 QPS ≈ 23 万
- 点赞是写操作,需要关注 TPS(写 QPS),这里峰值写 TPS ≈ 23 万
- 存储:一条点赞记录约 100 字节,日增量 = 1亿 × 20 × 100B ≈ 200 GB/天
- 显然不能直接写 MySQL → 需要 Redis 计数 + Kafka 异步落库
Q2:你的系统压测 QPS 到了 5000 就上不去了,加机器也不涨,可能是什么原因?怎么排查?
点击查看思路
加机器 QPS 不涨,说明瓶颈不在应用层,可能在下游:
- 数据库连接池耗尽:所有服务实例共享同一个数据库连接池,pool 满了,加应用实例没用
- 分布式锁竞争:所有请求都抢同一把锁,增加机器只是增加了更多等待者
- Redis 热 Key:所有请求都打到同一个 Redis 节点
- 网卡打满:带宽成为瓶颈
排查思路:先看监控(各层资源使用率)→ 再看线程 Dump(线程卡在哪)→ 逐层压测(隔离上下游,找到瓶颈层)
Q3:Redis 热 Key 问题,你说可以用 Key 拆分解决。但拆分后库存一致性怎么保证?如果用户拆分的 Key 已经没库存了,但另一个 Key 还有,怎么办?
点击查看思路
Key 拆分确实会引入一致性问题:
- 方案一:预分配库存,把 1 万件商品均分到 10 个 Key 各 1000 件。每个用户随机路由到一个 Key。如果某个 Key 库存耗尽,重试另一个 Key。但用户体验差。
- 方案二:两级扣减。第一级用拆分 Key 做快速扣减,第二级用一个"总库存 Key"做最终校验。如果总库存没了,回滚第一级扣减。复杂度高但一致性好。
- 方案三:Redis Cluster + 代理层,不拆分 Key,而是在代理层做请求合并。N 个并发请求合并成 1 个 Redis 操作。但代理层本身可能成为瓶颈。
- 实际上,秒杀场景下单 Key 用 Redis Lua 原子操作,10 万 QPS 以内单机 Redis 扛得住。真正要解决的是要不要用 Redis 直接扣库存,还是用其他方案(如内存队列)。
Q4:缓存雪崩的"过期时间加随机值"方案有什么问题?生产环境遇到过因为加随机值导致的问题吗?
点击查看思路
加随机值的副作用:
- 缓存不一致窗口被拉大:本来 10 分钟过期,加了随机值可能变成 15 分钟。过期时间越长,脏数据的窗口越大。
- 部分缓存"过期太早":随机值可能让某些缓存提前过期,导致局部击穿。
- 不适合强时效性数据:如果业务要求缓存必须 5 分钟刷新一次,加随机值会破坏这个约束。
更好的做法:逻辑过期。缓存值里存一个逻辑过期时间,不过期则直接返回;如果发现逻辑过期了,返回旧值的同时,异步开一个线程去更新缓存。这样不会出现"缓存突然没了"的情况。
Q5:你设计了一个分库分表方案,按 user_id 分 64 个库。现在运营要出一个报表:"所有今天下单的用户,按订单金额排序"。这个查询怎么实现?
点击查看思路
这是一个典型的"分库分表后非分片键查询"的问题:
- 数据异构:通过 Canal 监听 MySQL binlog,把订单数据同步到 Elasticsearch。报表查询走 ES。
- 离线数仓:订单数据 T+1 同步到 Hive/ClickHouse,报表走数仓查询。
- 中间表:在另外一个非分库的 MySQL 实例中维护一张"今日订单汇总表",下单时双写。
- 如果必须实时且不能引入新组件:64 个库全查 → 在应用层聚合排序 → 性能很差,不推荐。
面试官想听的是:你理解分库分表的代价,知道跨分片查询需要额外的基础设施,而不是硬查。
下一篇预告:194|高可用设计:冗余、故障转移、无单点、超时、降级和恢复