阅读时间:约 45 分钟 难度:高级 前置知识:面向对象设计、SOLID 原则、DDD(领域驱动设计)基础
一、架构演进:从"大泥球"到分层
1.1 无序的起点:大泥球架构
在缺乏架构约束的系统中,代码的组织方式往往演变成"大泥球"(Big Ball of Mud)——所有模块之间互相引用,没有任何依赖规则。一个典型的表象是:Controller 直接调用 DAO,Service 层形同虚设,工具类散落各处,业务逻辑渗透到表现层。
这种架构的代价是显而易见的:
- 修改成本高:改一个字段需要追踪所有调用链,不知道影响范围
- 测试困难:业务逻辑与基础设施耦合,无法独立测试
- 团队协作冲突:多人同时修改同一个模块,理解成本极高
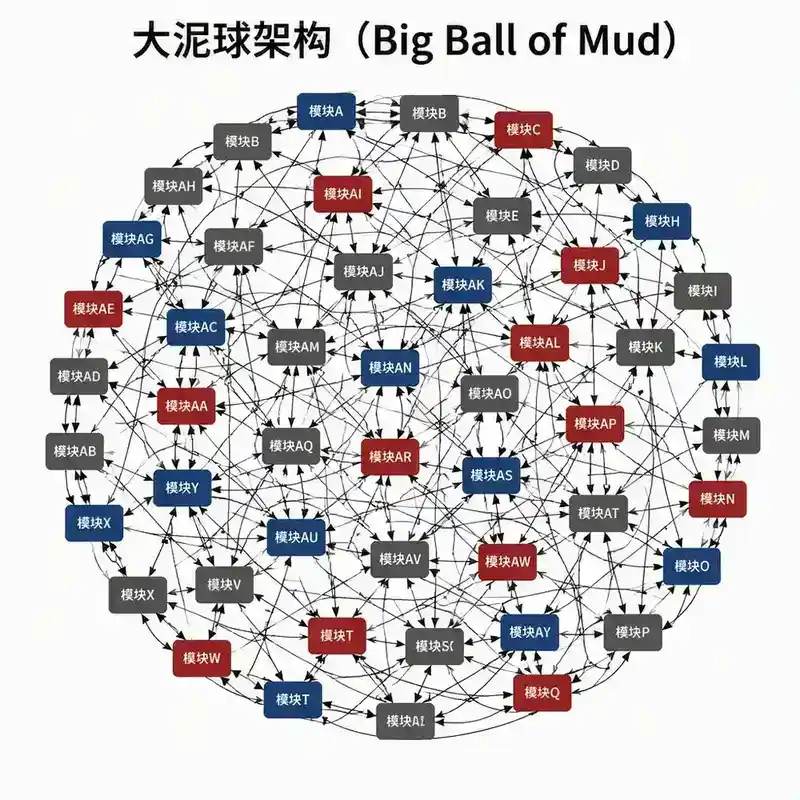
▲ 图1:大泥球架构示意图——所有模块互相引用,无依赖方向约束,修改一处影响全局
1.2 分层架构的诞生
分层架构(Layered Architecture)是对大泥球的第一道防线。它的核心思想是将系统按职责划分为若干层,每层只依赖下层,不允许反向依赖。
最经典的四层架构:
| 层 | 职责 | 示例 |
|---|---|---|
| 表现层(Presentation) | 处理用户交互,协议转换 | Controller、REST Endpoint、RPC Facade |
| 应用层(Application) | 协调领域对象完成用例,事务管理 | ApplicationService、UseCase |
| 领域层(Domain) | 核心业务逻辑,领域模型 | Entity、ValueObject、DomainService、Repository 接口 |
| 基础设施层(Infrastructure) | 技术实现,I/O 操作 | RepositoryImpl、数据库访问、消息队列、外部 API 调用 |
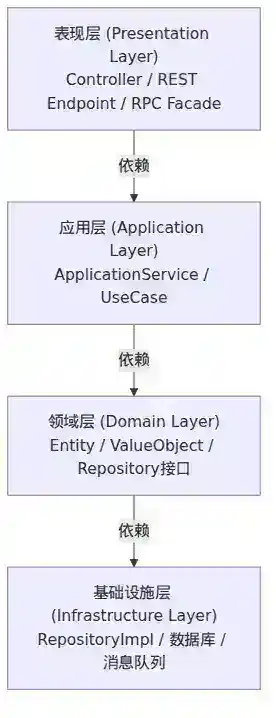
▲ 图2:经典四层架构——自上而下的依赖方向:表现层→应用层→领域层→基础设施层
依赖规则:上层可以依赖下层,下层绝不能依赖上层。在 Java 项目中,这意味着:
domain包不能import任何application或infrastructure包中的类application包不能import``infrastructure包中的类(通过接口反转)
二、分层架构的依赖方向:核心原则
2.1 依赖倒置原则(DIP)在分层中的应用
传统分层架构的一个致命缺陷是:领域层依赖基础设施层。领域层需要调用 Repository 来持久化数据,如果直接依赖 JdbcOrderRepository,领域层就与数据库技术绑定了。
解决方案是依赖倒置原则(Dependency Inversion Principle, DIP):
高层模块不应依赖低层模块,两者都应依赖抽象。抽象不应依赖细节,细节应依赖抽象。
在分层架构中落地 DIP 就是:在领域层定义接口,在基础设施层实现接口。
// ===== 领域层:定义接口 =====
// 文件:domain/repository/OrderRepository.java
package com.example.domain.repository;

import com.example.domain.model.Order;

public interface OrderRepository {
    Order findById(String orderId);
    void save(Order order);
}

// ===== 领域层:使用接口 =====
// 文件:domain/service/OrderService.java
package com.example.domain.service;

import com.example.domain.model.Order;
import com.example.domain.repository.OrderRepository;

public class OrderService {
    private final OrderRepository orderRepository;

    // 依赖注入——只需依赖接口,不关心实现
    public OrderService(OrderRepository orderRepository) {
        this.orderRepository = orderRepository;
    }

    public void placeOrder(Order order) {
        // 领域逻辑...
        orderRepository.save(order);
    }
}

// ===== 基础设施层:实现接口 =====
// 文件:infrastructure/persistence/JdbcOrderRepository.java
package com.example.infrastructure.persistence;

import com.example.domain.model.Order;
import com.example.domain.repository.OrderRepository; // 依赖"倒过来了"
import org.springframework.jdbc.core.JdbcTemplate;

public class JdbcOrderRepository implements OrderRepository {
    private final JdbcTemplate jdbcTemplate;

    @Override
    public Order findById(String orderId) {
        // JDBC 实现细节...
    }

    @Override
    public void save(Order order) {
        // JDBC 实现细节...
    }
}
关键点在于:JdbcOrderRepository 在 infrastructure 包中,但它 import 了 domain 包的接口。依赖箭头从基础设施指向了领域层——这就是"倒置"的含义。
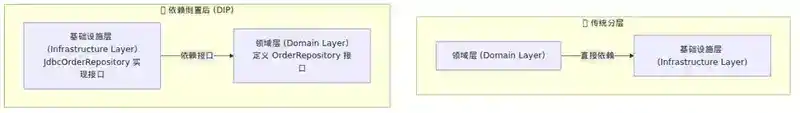
▲ 图3:依赖倒置前后对比——传统分层领域层依赖基础设施层 vs DIP 后基础设施层依赖领域层接口
2.2 依赖方向的可视化校验
一个实用的检查方法:画出项目的包依赖图,确认所有箭头都指向领域层。
# 使用 JDepend 或 ArchUnit 进行依赖检查
# ArchUnit 示例——领域层不应依赖基础设施层
ArchRule domainRule = classes()
    .that().resideInAPackage("..domain..")
    .should().onlyDependOnClassesThat()
    .resideInAnyPackage(
        "..domain..",      // 自身
        "java..",          // JDK
        "jakarta.."        // 标准 API
    );
三、六边形架构(端口与适配器):分层架构的进化
3.1 分层架构的局限
传统分层架构在简单场景下工作良好,但面对复杂业务时暴露出几个问题:
- 层间耦合过度:应用层和领域层之间没有明确的边界,业务逻辑容易泄漏到应用层
- 基础设施依赖不干净:虽然用了 DIP,但开发者仍然容易在领域层直接引入 Spring 注解、
@Transactional等框架依赖 - 外部交互不统一:HTTP、消息队列、定时任务等外部驱动方式与内部逻辑的交互方式各不相同
六边形架构(Hexagonal Architecture),也叫端口与适配器架构(Ports & Adapters),由 Alistair Cockburn 在 2005 年提出,是对分层架构的精炼和强化。
3.2 核心概念:端口与适配器
六边形架构的精髓在于:将业务逻辑放在中心,所有外部交互都通过端口(Port)和适配器(Adapter)接入。
| 概念 | 定义 | 类比 |
|---|---|---|
| 领域模型(Domain) | 系统的核心,纯业务逻辑,不依赖任何外部技术 | 手机的操作系统 |
| 端口(Port) | 领域模型对外暴露的接口,定义"我能做什么" | 手机的 USB-C 接口规范 |
| 主适配器(Driving Adapter) | 主动调用领域模型的适配器,如 REST Controller、CLI | 充电器、鼠标 |
| 从适配器(Driven Adapter) | 被领域模型调用的适配器,如 Repository 实现、消息队列 | 充电线另一端的电源插座 |
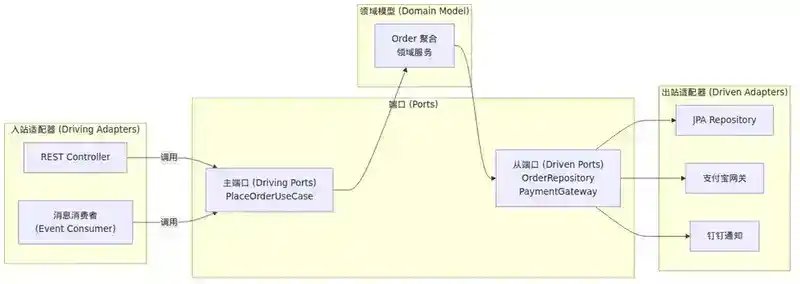
▲ 图4:六边形架构示意图——中心是领域模型,六边形的每边代表一个端口,外部适配器通过端口与领域交互
3.3 六边形架构的代码结构
一个典型的六边形架构项目结构如下:
com.example.order/
├── domain/                          # 领域核心(不依赖任何框架)
│   ├── model/
│   │   ├── Order.java               # 聚合根
│   │   ├── OrderItem.java           # 实体
│   │   ├── Money.java               # 值对象
│   │   └── OrderStatus.java         # 枚举
│   ├── service/
│   │   └── OrderService.java        # 领域服务
│   ├── port/
│   │   ├── driving/                 # 主端口——谁来驱动我
│   │   │   └── PlaceOrderUseCase.java
│   │   └── driven/                  # 从端口——我需要什么
│   │       ├── OrderRepository.java
│   │       ├── PaymentGateway.java
│   │       └── NotificationService.java
│   └── exception/
│       └── InsufficientStockException.java
│
├── application/                     # 应用层(用例编排)
│   └── service/
│       └── PlaceOrderService.java   # 实现 PlaceOrderUseCase
│
├── adapter/                         # 适配器层
│   ├── in/                          # 入站适配器(Driving Adapter)
│   │   ├── web/
│   │   │   └── OrderController.java
│   │   └── consumer/
│   │       └── OrderEventConsumer.java
│   └── out/                         # 出站适配器(Driven Adapter)
│       ├── persistence/
│       │   ├── JpaOrderRepository.java
│       │   └── OrderEntity.java     # JPA 实体(与领域模型分离)
│       ├── payment/
│       │   └── AlipayGateway.java
│       └── notification/
│           └── DingTalkNotificationService.java
│
└── config/                          # 依赖注入配置
    └── BeanConfiguration.java
关键在于:领域模型是纯 Java 对象,没有任何 Spring、JPA、Jackson 等框架注解。
3.4 领域模型与持久化模型的分离
六边形架构的一个重要实践是领域模型与持久化模型(ORM 实体)分离。很多人会直接在领域对象上加 @Entity、@Table 等 JPA 注解,但这让领域模型耦合了持久化框架。
// ===== 领域模型(纯 POJO,无框架注解)=====
package com.example.order.domain.model;

public class Order {
    private OrderId id;
    private CustomerId customerId;
    private Money totalAmount;
    private OrderStatus status;
    private List<OrderItem> items;

    // 业务方法——不关心如何持久化
    public void pay(PaymentDetail payment) {
        if (this.status != OrderStatus.PENDING) {
            throw new IllegalStateException("订单状态不允许支付");
        }
        this.status = OrderStatus.PAID;
        // 发布领域事件
        this.domainEvents.add(new OrderPaidEvent(this.id, payment));
    }
}

// ===== 持久化模型(JPA 实体,仅在基础设施层)=====
package com.example.order.adapter.out.persistence;

@Entity
@Table(name = "orders")
public class OrderEntity {
    @Id
    private String id;
    private String customerId;
    private BigDecimal totalAmount;

    @Enumerated(EnumType.STRING)
    private OrderStatusEntity status;

    // 工厂方法:领域模型 → 持久化模型
    public static OrderEntity from(Order order) {
        OrderEntity entity = new OrderEntity();
        entity.id = order.getId().getValue();
        entity.customerId = order.getCustomerId().getValue();
        entity.totalAmount = order.getTotalAmount().getValue();
        entity.status = OrderStatusEntity.valueOf(order.getStatus().name());
        return entity;
    }

    // 转换方法:持久化模型 → 领域模型
    public Order toDomain() {
        return Order.reconstitute(
            new OrderId(this.id),
            new CustomerId(this.customerId),
            new Money(this.totalAmount),
            OrderStatus.valueOf(this.status.name())
        );
    }
}
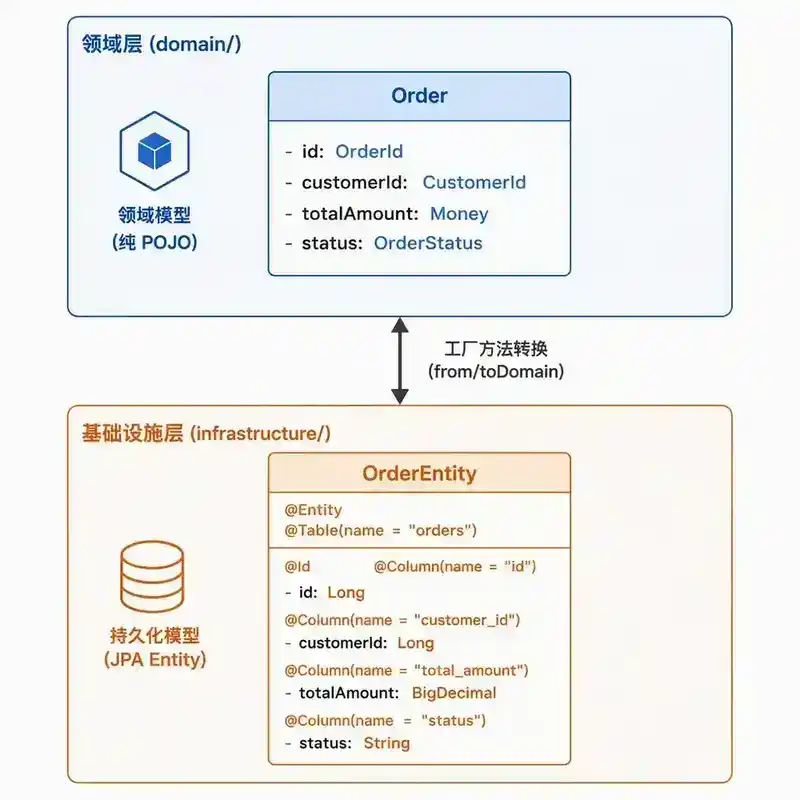
▲ 图5:领域模型与持久化模型分离——领域层纯 POJO,基础设施层有 JPA 实体,Repository 实现负责转换
四、领域隔离:保证业务逻辑的纯洁性
4.1 领域隔离的三层防线
领域隔离的根本目的是确保核心业务逻辑不受任何外部技术细节的污染。这需要三层防线:
第一层:包级隔离
domain包中的类不 import 任何框架类- 使用 ArchUnit 等工具在 CI 中自动化检查
第二层:接口隔离
- 领域层只定义接口(Port),不定义实现
- 所有外部依赖都是接口,而不是具体类
第三层:数据隔离
- 领域模型与 ORM 实体分离
- 领域模型不包含序列化注解
- 数据传输对象(DTO)与领域对象分离
4.2 DDD 战术模式在六边形架构中的位置
六边形架构天然适合 DDD 的战术模式落地:
| DDD 战术模式 | 在六边形架构中的位置 |
|---|---|
| 聚合(Aggregate) | domain/model/——核心业务对象 |
| 实体(Entity) | domain/model/——有唯一标识的对象 |
| 值对象(Value Object) | domain/model/——无标识的不可变对象 |
| 领域服务(Domain Service) | domain/service/——无状态的领域逻辑 |
| 仓储接口(Repository) | domain/port/driven/——从端口 |
| 领域事件(Domain Event) | domain/event/——领域内发生的事实 |
| 应用服务(Application Service) | application/——用例编排 |
| 工厂(Factory) | domain/ 或 application/——复杂对象的创建 |
4.3 一个完整的业务流程走查
以"用户下单"为例,看请求如何在六边形架构中流转:
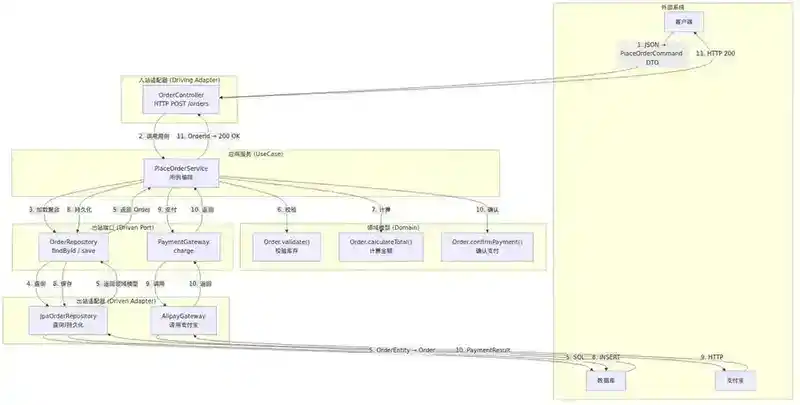
▲ 图6:用户下单请求在六边形架构中的完整流转——从 HTTP 请求到数据库写入,经过适配器、应用服务、领域服务、端口
步骤详解:
- 入站适配器(OrderController) 接收 HTTP POST 请求,将 JSON 反序列化为
PlaceOrderCommandDTO - 应用服务(PlaceOrderService) 从 Repository 加载聚合,调用领域方法,保存聚合
- 领域服务(OrderService) 执行核心业务逻辑:校验库存、计算金额、应用优惠券
- 出站端口(OrderRepository) 定义持久化接口——领域层只知道"我需要保存订单",不知道保存到哪里
- 出站适配器(JpaOrderRepository) 实现持久化接口,将领域模型转为 JPA 实体,写入数据库
// 应用服务——编排用例
public class PlaceOrderService implements PlaceOrderUseCase {
    private final OrderRepository orderRepository;
    private final InventoryService inventoryService;
    private final PaymentGateway paymentGateway;

    @Transactional
    public OrderId execute(PlaceOrderCommand command) {
        // 1. 加载聚合
        Order order = Order.create(command.getCustomerId(), command.getItems());

        // 2. 调用领域逻辑
        order.validate(inventoryService);
        order.calculateTotal();

        // 3. 持久化
        orderRepository.save(order);

        // 4. 调用外部服务
        PaymentResult result = paymentGateway.charge(order.getTotalAmount());
        order.confirmPayment(result);
        orderRepository.save(order);

        return order.getId();
    }
}
五、分层架构 vs 六边形架构:对比与选型
5.1 核心差异
| 维度 | 传统分层架构 | 六边形架构 |
|---|---|---|
| 组织方式 | 按技术层次(表现层、业务层、持久层) | 按业务领域 + 端口适配器 |
| 依赖方向 | 上层依赖下层,通过 DIP 反转 | 全部依赖指向领域中心 |
| 领域纯洁度 | 领域层可能混入框架依赖 | 领域层严格零框架依赖 |
| 可测试性 | 好(依赖注入后) | 极好(领域模型可纯单元测试) |
| 替换成本 | 中等(需改基础设施层) | 低(换适配器即可) |
| 学习成本 | 低 | 中高 |
| 适用场景 | 中小型项目、CRUD 为主 | 复杂业务、领域逻辑密集、长生命周期项目 |
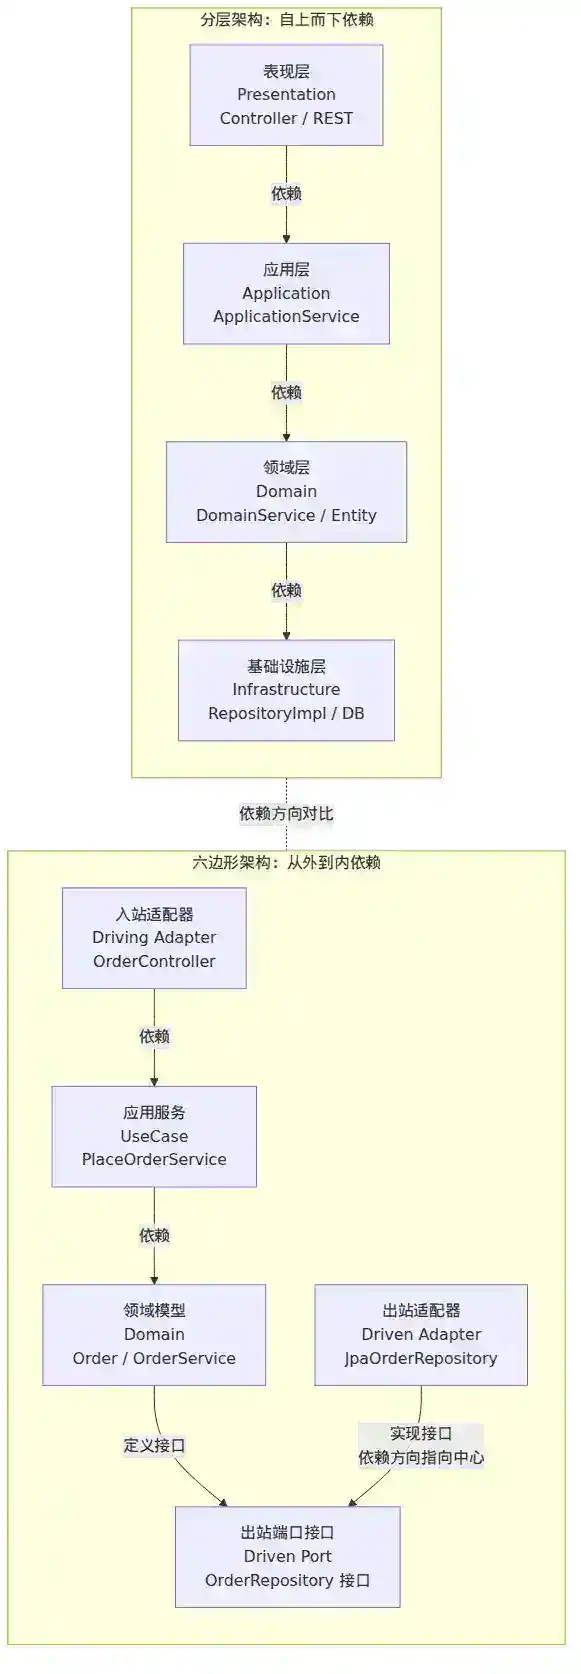
▲ 图7:分层架构与六边形架构的依赖方向对比——分层是"自上而下",六边形是"从外到内"
5.2 何时选择分层架构
分层架构仍然是最主流的架构模式,在以下场景中完全够用:
- 业务逻辑简单,以 CRUD 为主
- 团队规模较小(3-5 人)
- 项目生命周期短,不需要频繁变更技术栈
- 团队对 DDD 不熟悉,需要渐进式学习
5.3 何时选择六边形架构
六边形架构的价值在以下场景中得到充分体现:
- 复杂业务规则:电商促销引擎、保险理赔、金融风控等需要大量领域逻辑的系统
- 多终端接入:同一套业务逻辑需要同时服务 Web、移动端、开放 API、消息队列
- 技术栈频繁变更:需要从 MySQL 迁移到 PostgreSQL,从 REST 切换到 gRPC
- 长生命周期系统:预计维护 5 年以上的核心业务系统
5.4 渐进式迁移:从分层到六边形
不必一步到位。一个务实的迁移路径是:
- 第一步:在现有分层架构中引入 DIP,将 Repository 接口提到领域层
- 第二步:将领域模型与 ORM 实体分离,确保领域层无框架注解
- 第三步:引入明确的端口(Port)概念,将入站和出站接口分目录管理
- 第四步:引入适配器(Adapter)概念,将 controller 和 repository 实现统一到 adapter 层
六、常见陷阱与反模式
6.1 陷阱一:领域模型贫血
表象:领域对象只有 getter/setter,所有业务逻辑都写在 Service 里。
// 反模式:贫血模型
public class Order {
    private String id;
    private OrderStatus status;
    // 只有 getter/setter ...
}

// 业务逻辑"泄漏"到 Service 中
public class OrderService {
    public void pay(Order order) {
        if (order.getStatus() != OrderStatus.PENDING) { ... }
        order.setStatus(OrderStatus.PAID);
    }
}
修复:将业务逻辑内聚到领域对象中。
// 充血模型
public class Order {
    public void pay() {
        if (this.status != OrderStatus.PENDING) {
            throw new OrderStateException("...");
        }
        this.status = OrderStatus.PAID;
    }
}
6.2 陷阱二:领域层混入框架依赖
表象:domain 包中出现了 @Service、@Autowired、@Transactional 等 Spring 注解。
修复:框架注解只出现在 application 和 adapter 层,domain 层保持纯 Java。
6.3 陷阱三:过度设计——为简单 CRUD 引入六边形架构
如果一个模块只有"增删改查"操作,没有复杂业务规则,引入六边形架构反而增加了不必要的抽象层。对于简单的 CRUD 模块,传统的三层架构甚至两层架构(Controller → Repository)都完全够用。
6.4 陷阱四:适配器层过于厚重
表象:适配器层包含了大量业务判断逻辑。
修复:适配器应该只做"协议转换"——将外部格式转为领域对象,将领域对象转为外部格式。任何业务判断都应该在领域层或应用层。
七、工程实践:ArchUnit 保障架构约束
架构设计好之后,如何保证不会被后来者破坏?答案是架构单元测试。
@Test
public void domainLayerShouldNotDependOnInfrastructure() {
    JavaClasses classes = new ClassFileImporter()
        .importPackages("com.example.order");

    ArchRule rule = classes()
        .that().resideInAPackage("..domain..")
        .should().onlyDependOnClassesThat()
        .resideInAnyPackage(
            "..domain..",
            "java..",
            "jakarta.inject.."
        );

    rule.check(classes);
}

@Test
public void domainModelShouldNotHaveFrameworkAnnotations() {
    JavaClasses classes = new ClassFileImporter()
        .importPackages("com.example.order.domain.model");

    ArchRule rule = noClasses()
        .should().beAnnotatedWith(Entity.class)
        .orShould().beAnnotatedWith(Table.class);

    rule.check(classes);
}
将这些测试集成到 CI 流水线中,每次提交都会自动检查架构约束。
八、总结
分层架构和六边形架构并不是非此即彼的替代关系,而是递进式演进的关系:
- 分层架构解决了"代码组织"的问题——按职责分层,定义了依赖方向
- 六边形架构解决了"领域隔离"的问题——将业务逻辑与所有外部依赖彻底解耦
两者的共同核心是依赖方向:业务逻辑永远在中心,外部依赖永远指向中心。这个原则无论在哪种架构下都是不变的。
一句话总结:分层架构告诉你"代码应该放在哪",六边形架构告诉你"业务逻辑应该有多独立"。
面试官视角:高频追问
以下问题不从文章内容直接复述,而是从面试官视角考察你对架构思想的理解深度和实战经验。
Q1:你说分层架构的依赖方向是"上层依赖下层",但六边形架构是"所有依赖指向领域中心"。这两个似乎矛盾,你怎么理解?
参考答案:不矛盾,只是视角不同。分层架构的"上层依赖下层"描述的是技术分层的依赖关系;六边形架构的"所有依赖指向领域中心"描述的是业务与技术的关系。在分层架构中,通过 DIP,基础设施层的实现类实际上也依赖了领域层的接口——这与六边形架构是一致的。两者都在表达同一个核心原则:业务逻辑不应该依赖技术细节。
Q2:如果团队只有 3 个人,业务也很简单,你还会引入六边形架构吗?
参考答案:不会。架构选择是成本与收益的权衡。六边形架构的核心收益是"领域隔离"和"技术替换成本低",但如果业务简单(主要是 CRUD),这两个收益几乎为零,而付出的代价(额外的抽象层、类数量增加、新人理解成本)是实实在在的。我会用分层架构 + DIP 做好基本的依赖管理,等业务复杂度增长到需要领域隔离时再做演进。
Q3:你在项目中实际落地过六边形架构吗?有没有遇到什么坑?
参考答案思路:考察实战经验。常见的坑包括——领域模型与 ORM 实体分离带来的对象转换代码量增加(可以用 MapStruct 缓解);团队对 DDD 理解不足导致的"为抽象而抽象";简单的查询操作被过度封装(CQRS 可以配合解决——查询直接走适配器,不走领域模型);以及包结构设计不当导致的循环依赖(需要提前规划好端口和适配器的边界)。
Q4:六边形架构中,一个 UseCase(用例)应该对应一个端口还是一个应用服务?
参考答案:一个用例对应一个端口。端口是"我能做什么"的契约,每个用例都应该有独立的端口接口。应用服务是端口的实现,但一个应用服务可以实现多个端口(如果这些用例有共享的编排逻辑)。更推荐的做法是一个端口一个实现类,这样可以保持单一职责,也方便做权限控制和 AOP 切面。
Q5:六边形架构和 Clean Architecture(整洁架构)是什么关系?
参考答案:六边形架构(2005年,Alistair Cockburn)和整洁架构(2012年,Robert C. Martin)本质上是同一个思想的不同表述。两者的核心都是"依赖规则"——内层不依赖外层。整洁架构更强调"实体"(Enterprise Business Rules)和"用例"(Application Business Rules)的分层,而六边形架构更强调端口和适配器的概念。在实际项目中,两者可以融合使用——用六边形架构定义端口和适配器的边界,用整洁架构的分层概念组织领域模型和应用服务。
Q6:你如何说服团队 Leader 从分层架构迁移到六边形架构?
参考答案:不要谈"架构先进性",要谈"业务价值"和"可衡量的成本"。我需要准备三个论据:1)当前架构下,修改一个业务规则需要改几个模块?改一处代码的回归测试范围有多大?(量化当前的问题)2)列出最近半年因为技术耦合导致的故障或延期(用事实说话)3)提出渐进式迁移方案,而不是一次性重写——比如先从一个最复杂的模块开始试点,用 2 周做 POC,用数据说话。如果 Leader 仍然不同意,那就尊重决策,但可以在新模块中尝试更好的架构实践。