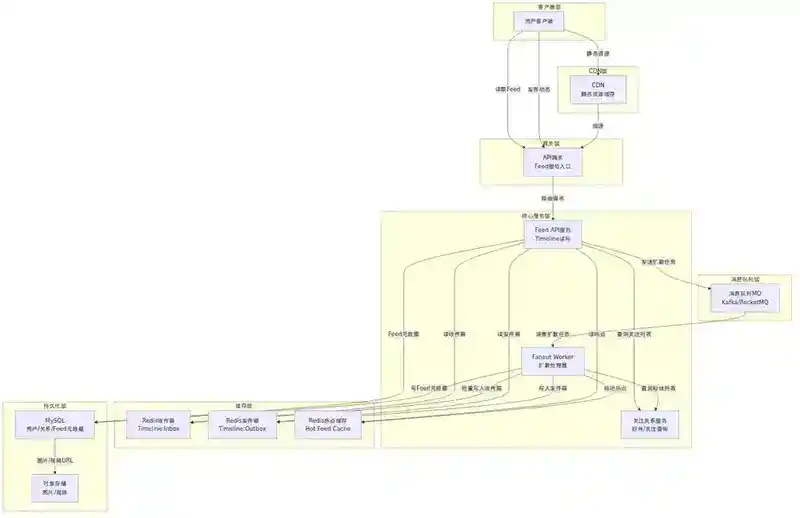
阅读时间:约 40–50 分钟 | 难度:中高级 | 分类:13 架构设计与系统设计
一、什么是Feed流
Feed流(信息流)是社交产品最核心的功能之一。打开微信朋友圈、刷微博、看抖音推荐、浏览知乎首页——这些"一刷就有新内容"的体验,背后都是Feed流系统在支撑。
定义:Feed流是一个按时间线聚合、动态更新、由用户关注关系驱动的内容分发系统。它把海量生产者产生的动态,实时、有序地推送给消费者。
Feed流的核心矛盾可以归结为三个维度:
- 时效性:用户发布内容后,关注者能多快看到?
- 一致性:不同用户看到的同一用户时间线是否一致?用户自己看到的是否完整?
- 成本:存储和计算资源是否可控?大V发一条动态要扩散到千万粉丝,CPU和带宽扛得住吗?
这三个维度相互制约,不存在完美的通用方案,只能根据业务场景做权衡。
二、Push模型:写时扩散
2.1 核心思想
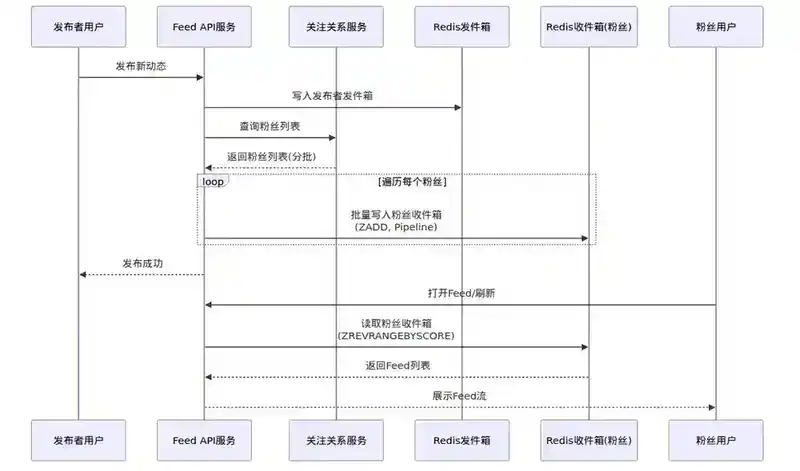
Push模型也叫Fanout on Write。当用户发布一条动态时,系统立即把这条动态"推"到所有粉丝的收件箱(Timeline收件箱)中。
用户A发动态
    ↓
查询A的所有粉丝(可能成百上千万)
    ↓
遍历每个粉丝的Timeline收件箱,写入这条动态
    ↓
粉丝打开Feed → 直接从自己的收件箱读取,无需计算
2.2 优点
- 读取极快:粉丝打开Feed时只需读自己的收件箱,O(1)复杂度
- 实现简单:逻辑清晰,写扩散,读聚合
- 实时性好:发布后粉丝几乎立即就能看到
2.3 缺点
- 写放大严重:大V发一条动态,需要写入千万粉丝的收件箱。假设大V有1000万粉丝,每条动态产生1000万次写入
- 存储浪费:每个粉丝都存一份动态副本,总存储量 = 动态数 × 粉丝数
- 延迟问题:大V发布到所有粉丝扩散完成可能需要几十秒甚至几分钟
- 僵尸粉浪费:大量不活跃粉丝的收件箱也在浪费存储和写入资源
2.4 适用场景
- 粉丝数普遍较少的场景(如微信朋友圈,好友上限5000)
- 对实时性要求极高的场景
- 用户活跃度高的社区
三、Pull模型:读时聚合
3.1 核心思想
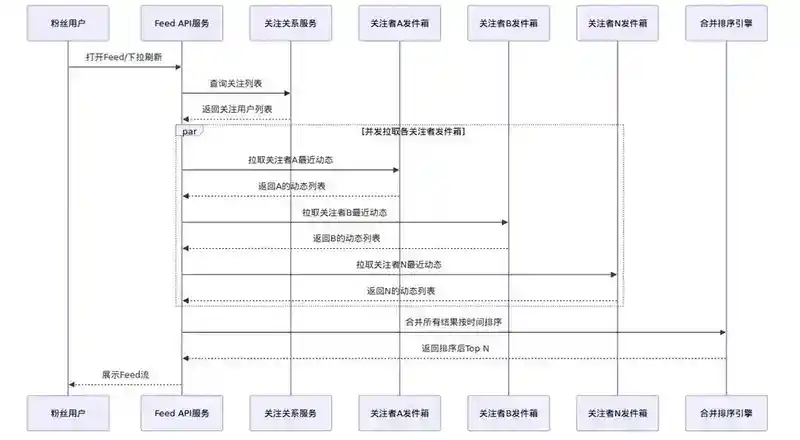
Pull模型也叫Fanout on Read。用户发布动态后,只存到自己的发件箱(Outbox)。粉丝打开Feed时,系统实时查询所有关注者的发件箱,合并排序后返回。
用户B打开Feed
    ↓
查询B关注的所有用户列表
    ↓
并发查询每个关注用户的发件箱(最近N条动态)
    ↓
合并所有结果,按时间排序
    ↓
返回前N条给B
3.2 优点
- 写操作简单:发布时只写一次,无论粉丝多少
- 存储节省:只存一份动态(发件箱),不需要为每个粉丝复制
- 没有写扩散:大V发布毫无压力
3.3 缺点
- 读延迟高:每次打开Feed都要查询所有关注者,假设关注500人,就要查500次
- 计算开销大:合并排序是CPU密集型操作
- 关注数越多越慢:复杂度随关注数线性增长,虽然用户的关注数通常有限(几百到几千),但IO开销仍然可观
- 热点问题:如果大量用户关注了同一个大V,大V的发件箱会成为读热点
3.4 适用场景
- 用户关注数较少的场景
- 大V/明星用户多的平台(如微博)
- 对实时性要求不极致但需要控制成本的场景
四、推拉结合模型:行业最佳实践
4.1 核心思路
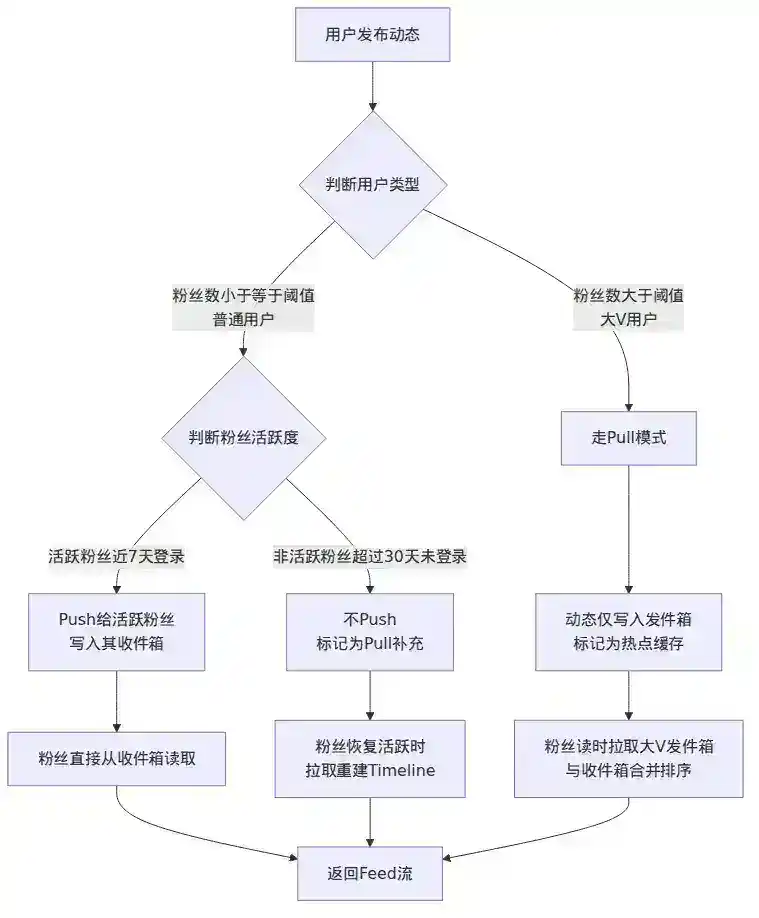
纯Push和纯Pull的缺陷都很明显,实际工程中几乎都采用推拉结合(Push-Pull Hybrid)模型。核心思想是:根据用户类型和活跃度,动态选择Push还是Pull。
4.2 分类策略
对大V用户(粉丝 > 阈值):Pull
- 大V发动态只存到自己的发件箱
- 粉丝读Feed时需要拉取大V的发件箱
- 大V的发件箱需要做热点缓存保护
对普通用户(粉丝 ≤ 阈值):Push
- 普通用户发动态,扩散写入所有粉丝的收件箱
- 粉丝直接读收件箱,无需拉取
对活跃用户:Push
- 活跃用户(如近7天登录)的关注者发布动态时,仍Push到他们的收件箱
- 保证活跃用户的读取体验
对非活跃用户:Pull
- 非活跃用户(如超过30天未登录)的收件箱不再写入
- 用户恢复活跃时,首次拉取重建
4.3 微信朋友圈的实践
微信朋友圈采用的是典型的推拉结合模型:
- 好友上限5000,普通用户的Push开销可控
- 朋友圈内容过期快(24小时内的内容为主),收件箱定期清理
- 对于"不常看"的朋友,用户可设置不推送,减少扩散
4.4 Twitter的实践
Twitter(早期)采用的是纯Pull模型,但后来也引入了推拉结合:
- 大多数用户的Tweet推送到粉丝Timeline(Push)
- 大V(如名人)的Tweet不推送,粉丝读时拉取(Pull)
- 引入了Timeline Cache作为中间层,缓存预聚合好的Timeline
五、Timeline存储设计
5.1 数据结构选择
Timeline的存储需要满足:
- 按时间排序
- 支持分页(按时间游标)
- 支持高并发读写
- 可以增量更新
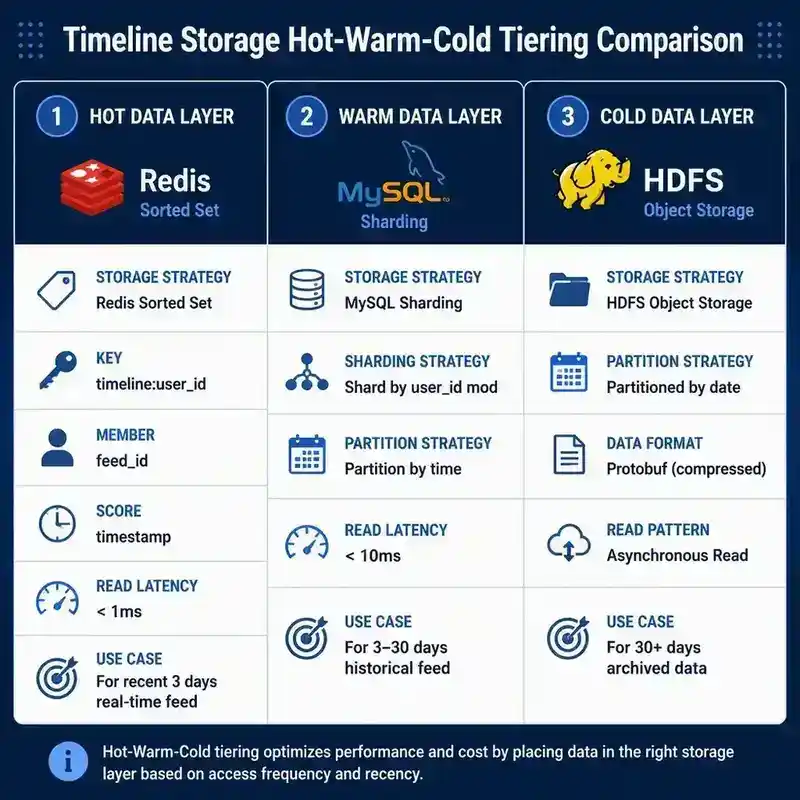
Redis Sorted Set是最常用的实现:
Key: timeline:{user_id}
Member: {feed_id}
Score: {timestamp}
- 按时间排序天然支持(Score排序)
- 分页用
ZREVRANGEBYSCORE按时间游标翻页 - 写入用
ZADD,O(log N) - 可以设置过期时间或定期清理旧数据
5.2 存储分层
典型的Timeline存储采用冷热分层:
| 层级 | 存储 | 数据范围 | 延迟 |
|---|---|---|---|
| 热数据 | Redis | 最近3天的Feed | < 1ms |
| 温数据 | SSD/MySQL | 3天~30天 | < 10ms |
| 冷数据 | HDFS/对象存储 | 30天以上 | 异步 |
5.3 收件箱容量控制
每个用户的收件箱不能无限增长。常见策略:
- 固定条数上限:每个收件箱最多保留最近1000条,超出后淘汰
- 时间窗口:只保留最近30天的Feed
- 惰性清理:用户登录时触发清理,删除过期Feed
六、粉丝/关注扩散(Fanout)机制
6.1 扩散流程
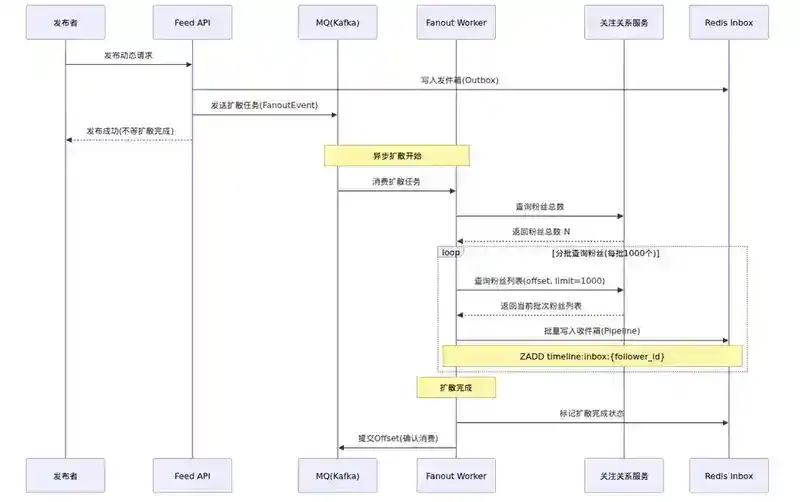
Fanout是一个异步+批量的过程。当用户发布动态后,扩散不是同步完成的,而是通过消息队列异步处理。
发布动态 → 写入发件箱 → 发送扩散消息到MQ
                              ↓
                       Fanout Worker消费
                              ↓
                    查询粉丝列表(分批)
                              ↓
                    批量写入粉丝收件箱
6.2 分批处理
大V的粉丝可能有千万级,不能一次性全部扩散。通常会:
- 分批查询粉丝:每次查询1000个粉丝
- 批量写入:使用Pipeline批量写入Redis,减少网络往返
- 限流控制:控制扩散速率,避免打爆Redis
- 异步化:扩散任务异步排队执行,用户不等待
6.3 在线扩散 vs 离线扩散
- 在线扩散:粉丝在线时实时推送(通过长连接WebSocket)
- 离线扩散:粉丝不在线时写入收件箱,下次登录时读取
对于在线用户,可以结合Push通知和WebSocket实现实时推送,让新内容"冒出来"。
七、热点缓存策略
7.1 热点Feed的定义
热点Feed是指被大量用户同时访问的Feed,通常来自:
- 大V发布的动态
- 热门话题/事件相关的动态
- 被大量转发/点赞的爆款内容
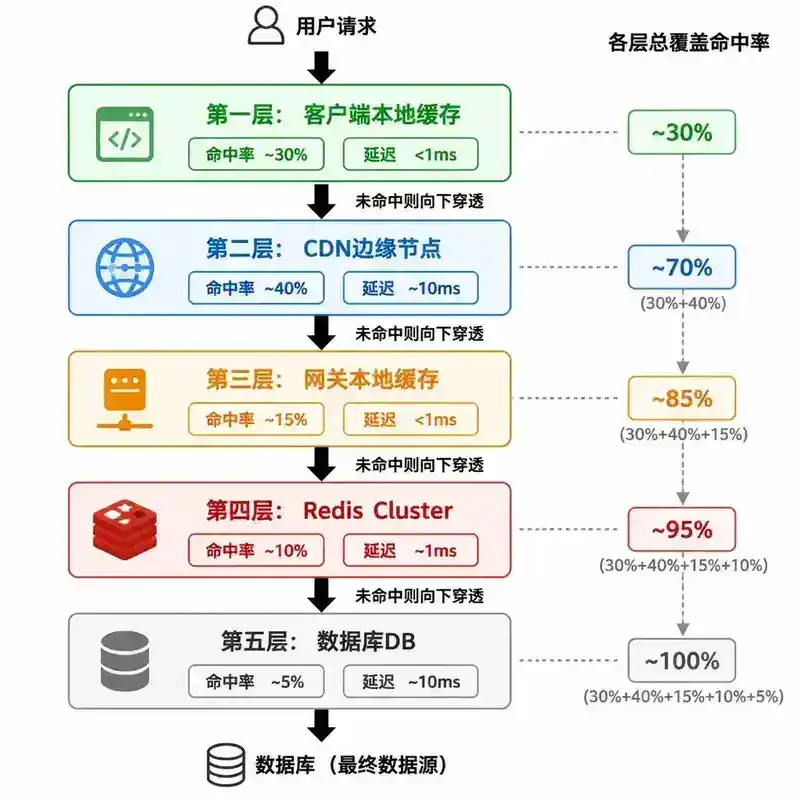
7.2 多级缓存架构
客户端
  ↓
CDN(静态资源缓存)
  ↓
Nginx/网关层(本地缓存,LRU,1-5分钟过期)
  ↓
分布式缓存(Redis Cluster)
  ↓
数据库(MySQL/NoSQL)
7.3 热点识别
- 基于时间窗口计数:统计最近N分钟内Feed被访问次数,超过阈值标记为热点
- 基于预测:大V发布时直接标记为潜在热点
- 基于用户行为:转发、点赞、评论数快速增长时触发
7.4 热点缓存策略
- 本地缓存 + 分布式缓存:热点Feed在网关层做本地缓存(Caffeine),减少Redis访问
- 主动预热:大V发布后,主动将内容加载到缓存中
- 缓存副本:极端热点Feed可以复制多份到多个Redis节点,分散读压力
八、一致性设计
8.1 最终一致性
Feed流系统通常接受最终一致性而非强一致性。原因:
- Fanout是异步的,存在扩散延迟
- 不同用户看到新内容的延迟可以不同
- 用户可接受的延迟在秒级
8.2 常见一致性问题
问题1:刚发布的内容自己看不到
- 解决:发布后立即写入自己的发件箱,读取时合并自己的发件箱
问题2:删除/修改后粉丝仍看到旧内容
- 解决:删除时发一条"删除事件",异步清理所有粉丝收件箱中的该Feed
问题3:关注关系变更后的不一致
- 关注后:新关注者的收件箱中缺失被关注者的历史内容——Pull补充
- 取关后:取关者收件箱中仍残留被关注者的内容——惰性清理
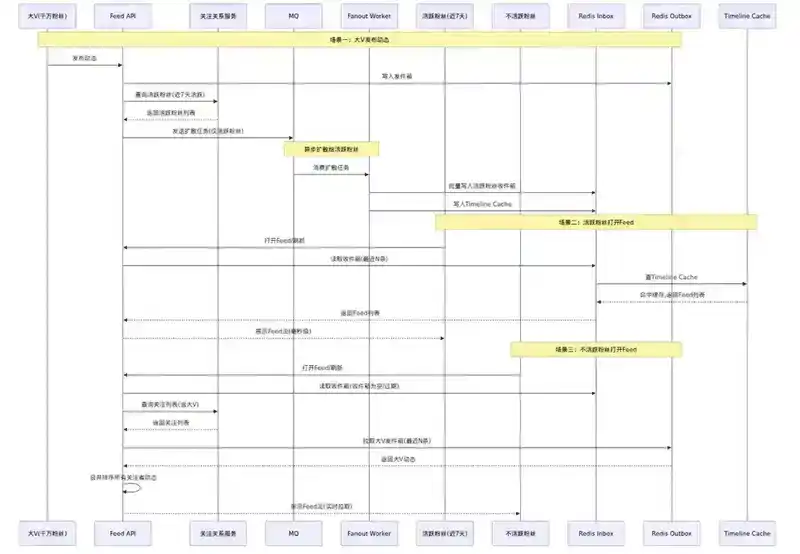
图8:推拉结合模型下大V发布和粉丝读取的完整时序图
九、性能优化实践
9.1 读优化
- 预聚合:非高峰期,对活跃用户预先聚合好Timeline
- 分页游标:用时间戳+feed_id作为游标,避免OFFSET
- 只读需要的字段:列表页只返回摘要,详情页再加载完整内容
9.2 写优化
- 批量写入:Redis Pipeline一次写入多条
- 异步扩散:通过MQ解耦发布和扩散
- 选择性扩散:只扩散给活跃用户
9.3 存储优化
- 冷热分离:热数据在Redis,冷数据在MySQL/HDFS
- 压缩:Feed内容使用protobuf/msgpack压缩存储
- 定期清理:过期Feed自动淘汰
十、面试追问
以下问题从面试官视角出发,检验对Feed流系统设计的深层理解。
Q1:大V发布一条动态,在推拉结合模型下,整个流程是怎样的?
参考答案:大V发布动态 → 写入自己的发件箱(只写一份)→ 不触发Fanout到粉丝收件箱 → 系统将大V发件箱标记为热点缓存 → 粉丝打开Feed时 → 拉取关注列表 → 对普通用户走Push收件箱(已扩散好的)→ 对大V走Pull拉取(从热点缓存读)→ 合并排序返回。
Q2:假设Feed流采用Redis Sorted Set存储,score用时间戳,当两个Feed时间戳完全相同时会发生什么?如何保证排序唯一?
参考答案:Redis Sorted Set中score相同时按member的字典序排序。时间戳相同可能导致排序不稳定。解决方案:使用复合score,如 timestamp * 1000 + sequence_id,或者使用 timestamp 作为score,feed_id 作为member保证唯一性。
Q3:推拉结合模型中,如何确定Push/Pull的阈值?阈值设多少合适?
参考答案:阈值取决于系统的写入能力和存储成本。核心考量:普通用户Push一条产生的写入数 = 粉丝数。如果粉丝数 > 1000,Push写入成本开始显著,可以考虑走Pull。但阈值不是绝对的——需要结合粉丝活跃度:如果1000粉丝中只有10个活跃,Push成本仍然很低。更好的做法是 Push给活跃粉丝,Pull给非活跃粉丝。
Q4:Feed流系统中,如果你关注了1000个人,每次打开Feed要拉取1000个发件箱,怎么做性能优化?
参考答案:① 只拉取近期活跃的关注者发件箱(超过7天不活跃的跳过);② 设置超时,超过200ms的超时查询直接丢弃,牺牲完整性换延迟;③ 使用预聚合:非高峰期提前计算好Timeline缓存;④ 使用Timeline缓存:把最近聚合好的Timeline直接缓存,增量更新;⑤ 对关注者发件箱做并发查询,但限制并发数(如线程池大小=50),分批拉取。
Q5:如果Feed流中混入了广告/推荐内容,如何设计插入策略?
参考答案:广告和推荐内容不通过Fanout扩散,而是单独维护一个广告/推荐内容池。读取Timeline时,按固定频率(如每10条Feed插入1条广告)将广告混排进Feed流。混排逻辑在API层完成,对底层Timeline存储透明。广告的排序结合竞价(eCPM)和Feed流位置价值(越靠前越贵)。
Q6:如何设计一个支持"按热度排序"和"按时间排序"两种模式的Feed流?
参考答案:维护两套Timeline:① 时间线Timeline(Redis Sorted Set,score=时间戳);② 热度线Timeline(Redis Sorted Set,score=热度分)。热度分可以用公式计算(如 点赞数*3 + 评论数*5 + 分享数*10 - 时间衰减因子)。热度分需要定时更新,可以用离线计算 + 定时刷新缓存的方式。用户切换排序模式时,切换读取的Timeline Key即可。