阅读时间:约 40-50 分钟 | 适用方向:Java 技术专家 / 架构师 / 分布式系统设计
目录
- 问题定义:什么是高可用
- 可用性度量:从 99.9% 到 99.999%
- 冗余设计:主备、多活、N+1 冗余
- 故障检测:心跳、健康检查与超时
- 故障转移:自动切换、选举与脑裂防护
- 无单点设计:消除 SPOF 的系统性方法
- 超时控制:连接超时、请求超时、超时传播
- 降级设计:优雅降级、功能降级与熔断
- 恢复机制:自动恢复、手动恢复与数据恢复
- 高可用架构实战:从单机房到多活
- 常见陷阱与故障案例
- 面试官提问
1. 问题定义:什么是高可用
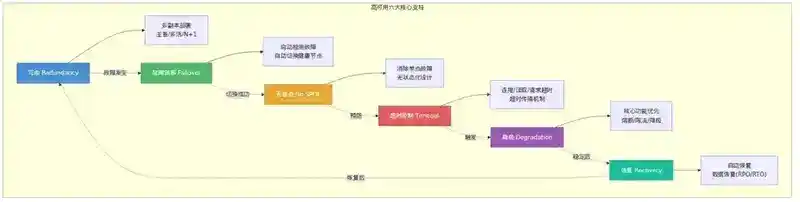
高可用(High Availability, HA) 是指系统在面对部分组件故障时,仍能持续对外提供服务的能力。它的核心目标不是"不出故障",而是"出了故障用户无感知或感知极小"。
核心公式:
可用性 = MTTF / (MTTF + MTTR)
| 术语 | 含义 |
|---|---|
| MTTF(Mean Time To Failure) | 平均无故障时间 |
| MTTR(Mean Time To Repair) | 平均修复时间 |
从这个公式可以看出,提高可用性有两条路:延长 MTTF(减少故障发生) 和 缩短 MTTR(加快故障恢复)。在实际工程中,缩短 MTTR 往往比延长 MTTF 更可控、更经济——因为故障不可避免,但恢复速度可以优化。
高可用 ≠ 高可靠:可靠性关注的是"不出错",可用性关注的是"能用"。一个系统可能每次请求都返回错误信息(不可靠),但只要它返回了响应,它就是"可用"的。当然,实际工程中我们两者都追求。
高可用的核心支柱:
- 冗余(Redundancy):多副本,一个挂了另一个顶上
- 故障转移(Failover):自动检测并切换到健康副本
- 无单点(No SPOF):任何组件故障不影响整体服务
- 超时控制(Timeout):不无限等待,快速失败
- 降级(Degradation):核心功能优先,非核心功能可牺牲
- 恢复(Recovery):故障后快速回到正常状态
2. 可用性度量:从 99.9% 到 99.999%
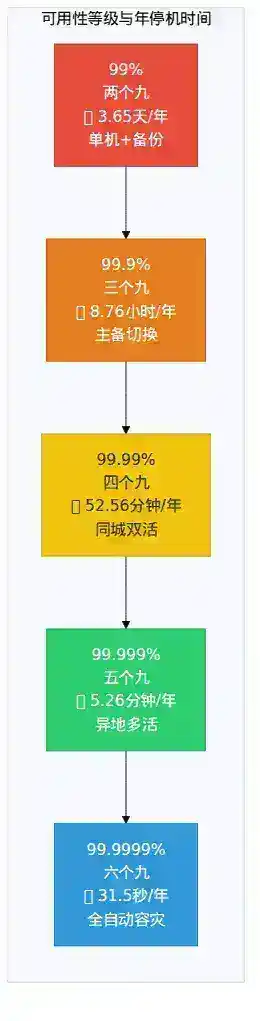
2.1 九个九的标准
| 可用性 | 俗称 | 年停机时间 | 典型架构 |
|---|---|---|---|
| 99% | 两个九 | 3.65 天 | 单机 + 备份 |
| 99.9% | 三个九 | 8.76 小时 | 主备切换 |
| 99.99% | 四个九 | 52.56 分钟 | 同城双活 |
| 99.999% | 五个九 | 5.26 分钟 | 异地多活 |
| 99.9999% | 六个九 | 31.5 秒 | 全自动容灾 |
为什么每提高一个九,成本呈指数级增长? 因为每增加一个九,你需要消除的故障模式就更多——从硬件故障到网络分区,从人为误操作到软件 Bug,从机房断电到地震洪水。每个九的背后都是巨大的基础设施投入、自动化工程和运维能力。
2.2 SLA、SLO 与 SLI
- SLI(Service Level Indicator):服务等级指标,如请求成功率、P99 延迟
- SLO(Service Level Objective):服务等级目标,如"99.9% 的请求在 200ms 内完成"
- SLA(Service Level Agreement):服务等级协议,违反后有赔偿条款
关键区别:SLO 是内部目标,SLA 是对外承诺。SLO 应比 SLA 更严格,留出缓冲空间。
2.3 错误预算
错误预算 = 1 - SLO。例如 SLO 是 99.9%,则错误预算为 0.1%。
错误预算的工程价值:
- 当错误预算充足时,可以大胆发布新版本
- 当错误预算耗尽时,冻结发布,优先修复稳定性问题
- 这是 Google SRE 的核心实践之一
3. 冗余设计:主备、多活、N+1 冗余
3.1 冗余的本质
冗余就是用资源的冗余换取故障时的容错能力。冗余不是简单的"多放几台机器",而是一个需要精心设计的系统工程。
3.2 冗余模式
(1)主备模式(Active-Passive)
- 一个主节点提供服务,一个或多个备节点待命
- 备节点不处理请求,只同步数据
- 主节点故障时,备节点接管
- 优点:简单,数据一致性好
- 缺点:资源利用率低(备节点闲置),切换有窗口
(2)主主模式(Active-Active)
- 多个节点同时提供服务
- 需要解决数据冲突和一致性
- 优点:资源利用率高,无切换窗口
- 缺点:数据一致性复杂,需要冲突解决机制
(3)N+1 冗余
- N 个节点满足业务需求,额外 1 个节点做冗余
- 任意一个节点故障,系统仍能满足 N 个节点的能力
- 常用于应用服务器、缓存集群
(4)2N 冗余
- 两套完全独立的系统,互为主备
- 成本最高,可靠性也最高
- 常用于核心数据库、支付系统
3.3 冗余的代价
- 硬件成本:直接的资源翻倍
- 同步成本:数据同步消耗网络和 CPU
- 一致性成本:CAP 理论告诉我们,分区时要在一致性和可用性间取舍
- 运维复杂度:更多节点意味着更复杂的运维
4. 故障检测:心跳、健康检查与超时
故障检测是高可用的眼睛——你必须在用户感知到故障之前,先发现故障。
4.1 心跳机制
心跳是分布式系统中最基础的故障检测手段:
- 固定频率心跳:每隔 T 秒发送一次心跳
- 超时判定:连续 N 次心跳未收到,判定节点故障
- φ 失败检测器:基于心跳间隔的动态概率模型,自适应网络抖动
心跳设计的陷阱:
- 心跳间隔太短 → 网络开销大,误判多
- 心跳间隔太长 → 故障发现慢,恢复慢
- 心跳和业务流量走同一通道 → 网络拥塞时心跳也丢,产生误判
4.2 健康检查
健康检查比心跳更全面,不仅检查"是否活着",还检查"是否健康":
| 检查类型 | 检查内容 | 示例 |
|---|---|---|
| Liveness | 进程是否存活 | 端口是否监听 |
| Readiness | 是否准备好接收流量 | 依赖服务是否就绪 |
| Startup | 是否启动完成 | 预热是否完成 |
Kubernetes 中的三种探针就是这三种健康检查的典型实现。
4.3 故障检测的工程实践
- 多级检测:进程级 → 机器级 → 服务级 → 业务级
- 去中心化检测:不要依赖单一检测节点,避免检测节点本身成为单点
- 假阳性处理:网络抖动导致的心跳丢失不应直接触发切换,需要多次确认
5. 故障转移:自动切换、选举与脑裂防护
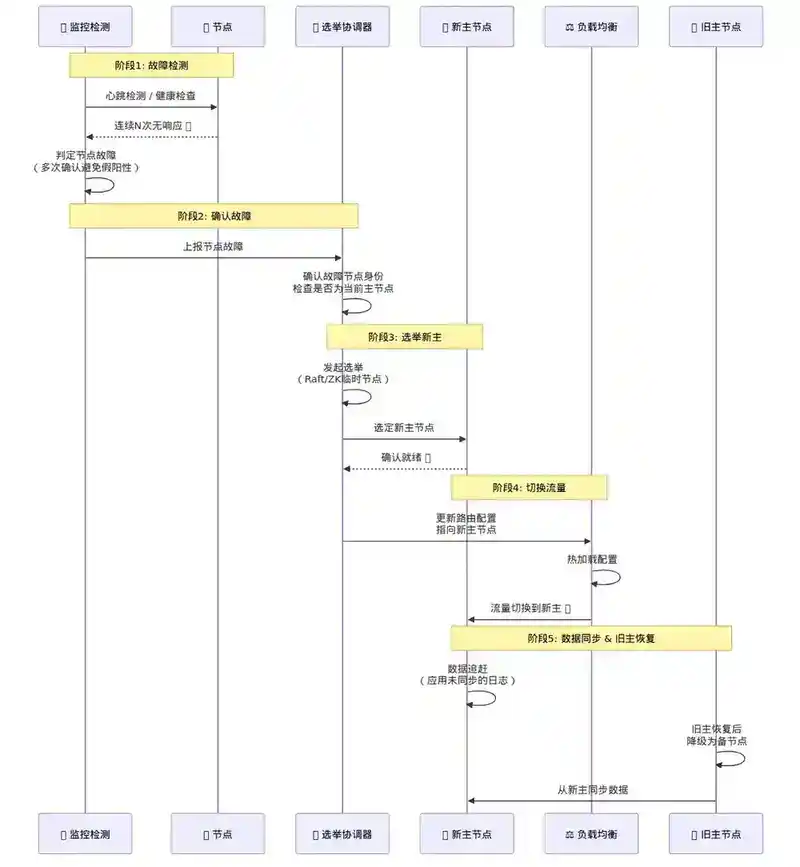
5.1 故障转移的基本流程
故障检测 → 确认故障 → 选择新主 → 切换流量 → 数据同步 → 旧主恢复
每一步都有陷阱:
- 确认故障:如何区分"真挂"和"网络慢"?
- 选择新主:谁来做决定?多个候选者如何协调?
- 切换流量:如何保证流量不丢失?
- 数据同步:新主的数据是最新的吗?
- 旧主恢复:旧主回来后如何避免数据冲突?
5.2 选举机制
分布式系统中,选举是确定"谁做主"的核心机制:
(1)Bully 算法
- 节点 ID 最大的当选
- 简单但不够可靠
(2)Raft 选举
- 基于任期(Term)的选举
- 候选人请求投票,获得多数票则成为 Leader
- 随机选举超时避免活锁
(3)基于外部协调器的选举
- 使用 ZooKeeper/etcd 的临时顺序节点
- 序号最小的节点为 Leader
- Watch 机制实现自动切换
5.3 脑裂问题
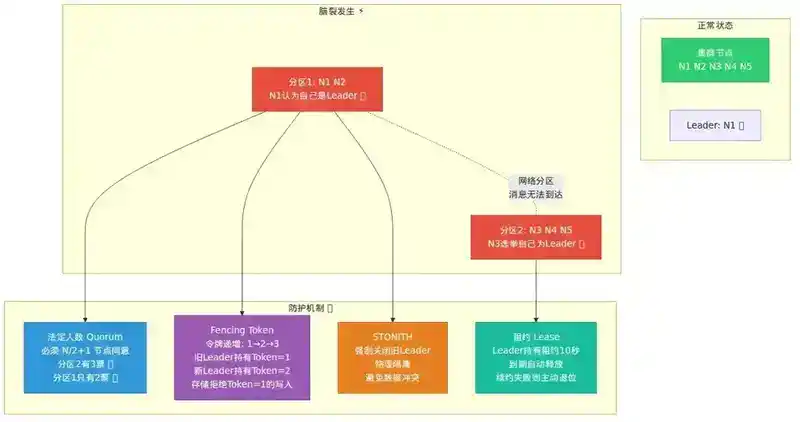
脑裂(Split-Brain) 是分布式系统中最危险的故障模式之一:网络分区导致集群分裂成多个子集群,每个子集群都认为自己是"主",对外提供服务,产生数据冲突。
防护手段:
| 手段 | 原理 | 典型实现 |
|---|---|---|
| Quorum(法定人数) | 必须获得多数节点同意才能成为主 | Raft、ZAB |
| Fencing Token | 每次切换递增一个单调递增的令牌 | 分布式锁的 fencing |
| STONITH | 强制关闭旧主,物理隔离 | Shoot The Other Node In The Head |
| 租约(Lease) | 主节点持有租约,到期自动释放 | etcd Lease |
6. 无单点设计:消除 SPOF 的系统性方法
6.1 什么是 SPOF
单点故障(Single Point of Failure, SPOF) 是指系统中某个组件一旦故障,整个系统就无法提供服务。
6.2 常见单点
| 层级 | 单点 | 消除方案 |
|---|---|---|
| DNS | 单一 DNS 服务商 | 多 DNS 服务商 |
| 负载均衡 | 单台 LB | LB 集群 + VIP 漂移 |
| 应用服务器 | 单台应用 | 多实例 + 无状态 |
| 缓存 | 单节点 Redis | Redis Cluster / Sentinel |
| 数据库 | 单库 | 主从 / 集群 / 分库 |
| 消息队列 | 单节点 MQ | 集群部署 |
| 配置中心 | 单节点 | 集群 + 本地缓存 |
| 机房 | 单机房 | 多机房 / 多活 |
| 网络 | 单链路 | 双链路 / 多运营商 |
6.3 消除 SPOF 的系统方法
第一步:画出系统架构图,标注每个组件。
第二步:逐个问自己:"如果这个组件挂了,系统还能提供服务吗?"
第三步:对于每个 SPOF,设计冗余方案。优先从低成本、高收益的开始。
"无状态化"是消除 SPOF 最有效的手段:将有状态的数据下沉到专门的存储层(数据库、缓存),让应用层完全无状态,这样应用层可以任意扩缩容,任何实例挂了流量自动切到其他实例。
7. 超时控制:连接超时、请求超时、超时传播
7.1 超时的重要性
超时是分布式系统中最容易被忽视但最关键的保护机制。没有超时保护的系统,一个慢依赖可以拖垮整个调用链。
超时设得太长:资源被长时间占用,故障扩散 超时设得太短:正常请求被误杀,可用性反而下降
7.2 超时类型
| 超时类型 | 作用 | 典型值 |
|---|---|---|
| 连接超时(Connect Timeout) | 建立 TCP 连接的最大等待时间 | 200ms - 1s |
| 读取超时(Read Timeout) | 等待响应的最大时间 | 1s - 30s |
| 请求超时(Request Timeout) | 整个请求的生命周期 | 调用方设置 |
| 空闲超时(Idle Timeout) | 连接空闲多久后关闭 | 几分钟到几小时 |
7.3 超时传播(Deadline Propagation)
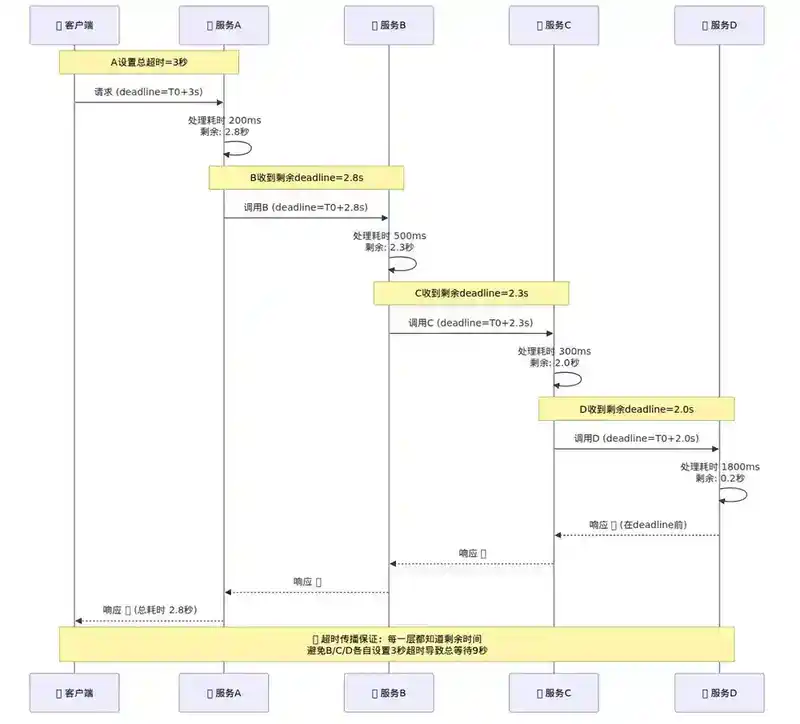
在微服务调用链中,如果服务 A 调用服务 B,服务 B 调用服务 C,A 设置了 3 秒超时,那么 B 调用 C 时应该使用剩余的可用时间,而不是重新设置一个 3 秒超时。
A 设置 3 秒超时 → 调用 B
   B 收到请求,已过去 200ms → 剩余 2.8 秒
   B 调用 C,设置超时 = 2.8 秒
      C 收到请求,已过去 500ms → 剩余 2.3 秒
      C 调用 D,设置超时 = 2.3 秒
gRPC 的 deadline 机制就是超时传播的标准实现。
7.4 超时与重试的配合
超时和重试是一对矛盾体:超时太短触发大量重试,加重系统负担;超时太长又影响用户体验。实践中需要:
- 设置合理的超时时间(基于 P99 延迟)
- 使用指数退避重试
- 设置最大重试次数
- 引入抖动(Jitter)避免惊群效应
8. 降级设计:优雅降级、功能降级与熔断
8.1 降级的本质
降级(Degradation)是在系统部分功能不可用时,主动牺牲非核心功能,保障核心功能的策略。这是一种"有损服务"的取舍——不是所有功能都同等重要。
8.2 降级策略
(1)功能降级
| 场景 | 降级策略 |
|---|---|
| 推荐服务不可用 | 返回默认推荐列表 |
| 评论服务不可用 | 隐藏评论区,不阻塞主流程 |
| 搜索服务响应慢 | 返回缓存结果 |
| 图片服务不可用 | 显示占位图 |
(2)质量降级
- 降低图片分辨率
- 减少返回的数据量
- 关闭非核心的实时计算
(3)读降级
- 从主库读降级为从库读
- 从实时数据降级为缓存数据
- 从精确结果降级为近似结果
8.3 降级的开关设计
降级需要可控,不能"自动降级之后恢复不了":
- 手动降级开关:配置中心控制,运维可手动切换
- 自动降级触发:基于错误率、延迟、资源使用率自动触发
- 降级恢复:故障恢复后自动或手动恢复降级功能
- 降级分级:L1(非核心功能)→ L2(次要功能)→ L3(核心功能的部分特性)
8.4 熔断器(Circuit Breaker)
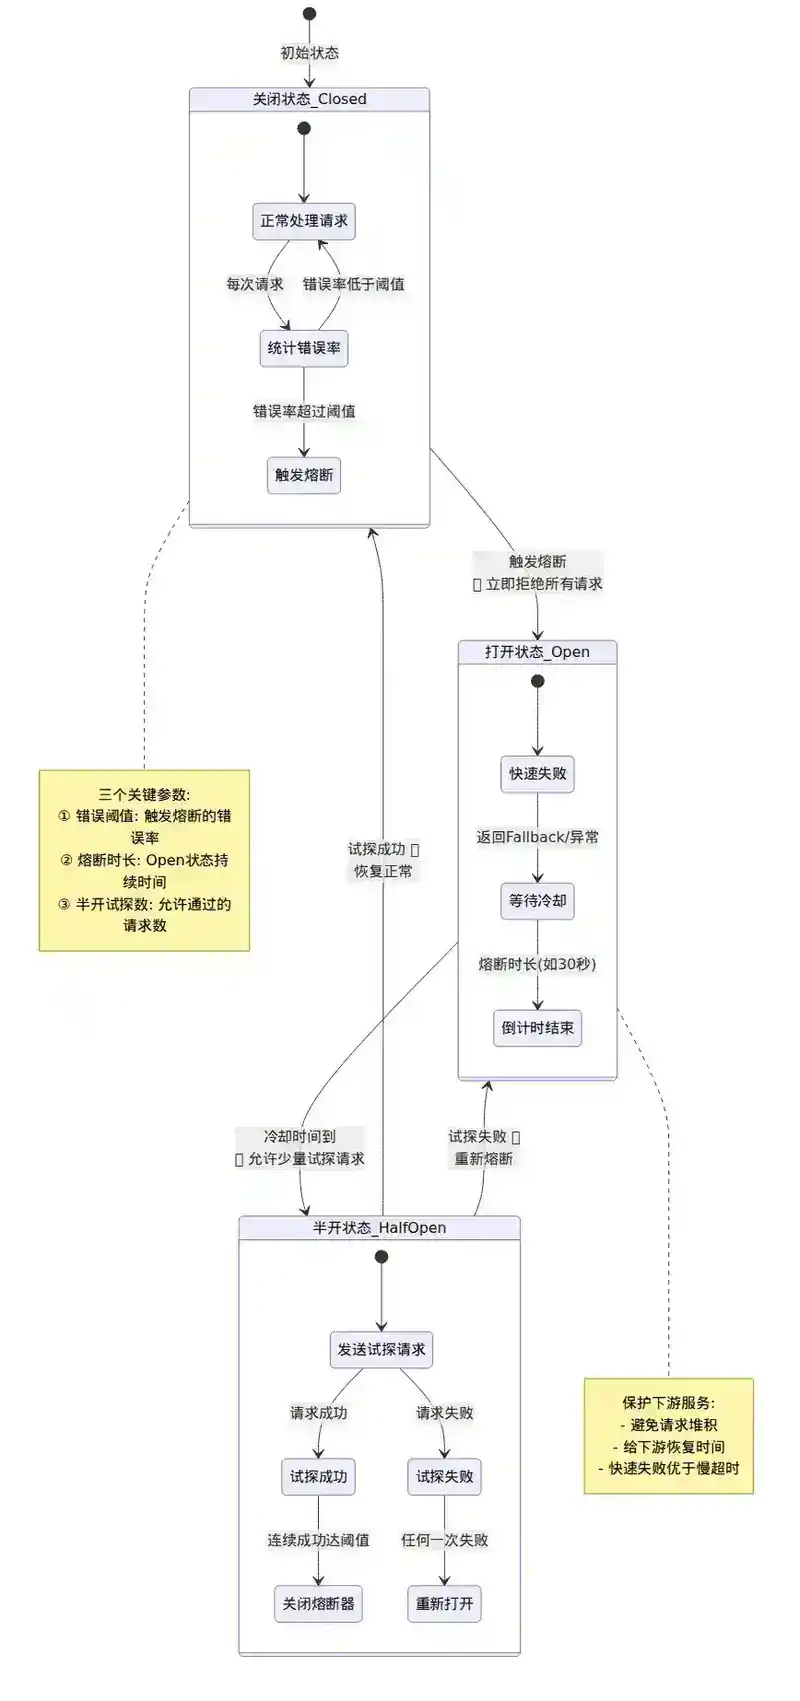
熔断是降级的一种自动化实现:
关闭状态(Closed)→ 错误率超过阈值 → 打开状态(Open)
打开状态(Open)→ 等待一段时间 → 半开状态(Half-Open)
半开状态(Half-Open)→ 试探请求成功 → 关闭状态(Closed)
半开状态(Half-Open)→ 试探请求失败 → 打开状态(Open)
三个关键参数:
- 错误阈值:触发熔断的错误率或错误数
- 熔断时长:熔断状态持续多久后进入半开
- 半开试探数:半开状态允许通过的请求数
9. 恢复机制:自动恢复、手动恢复与数据恢复
9.1 恢复的目标
恢复不是"把系统修好",而是在最短时间内把服务恢复到可用状态。根因分析可以等系统恢复之后再做。
9.2 自动恢复机制
| 机制 | 恢复时间 | 适用场景 |
|---|---|---|
| 进程重启 | 秒级 | 进程 Crash |
| 容器重启 | 秒级 | 容器异常退出 |
| 实例替换 | 分钟级 | 机器故障 |
| 故障转移 | 秒-分钟级 | 主节点故障 |
| 自动扩容 | 分钟级 | 流量突增 |
| 数据回滚 | 分钟-小时级 | 数据错误 |
| 机房切换 | 分钟级 | 机房故障 |
9.3 Kubernetes 的自愈能力
Kubernetes 内置了完善的自愈机制:
- Pod 重启:liveness 探针失败 → kubelet 重启容器
- 节点故障:node controller 检测到节点不可达 → 在其他节点重建 Pod
- 副本保持:ReplicaSet 持续确保指定数量的 Pod 在运行
9.4 数据恢复的挑战
数据恢复是恢复中最复杂的部分:
- 数据一致性:恢复后的数据是否与故障前一致?
- 数据丢失量:RPO(Recovery Point Objective)= 能容忍丢失多少数据?
- 恢复时间:RTO(Recovery Time Objective)= 多快能恢复?
RPO vs RTO:
- RPO = 0:不能丢任何数据 → 需要同步复制
- RTO = 30 秒:30 秒内必须恢复 → 需要自动故障转移
- 更低的 RPO 和 RTO 意味着更高的成本
10. 高可用架构实战:从单机房到多活
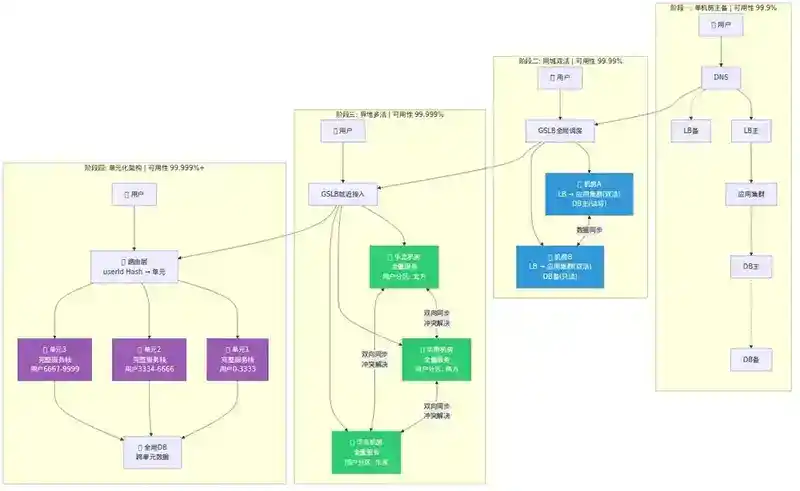
10.1 第一阶段:单机房主备
[用户] → [DNS] → [LB 主] → [应用集群] → [DB 主]
                       ↓                    ↓
                  [LB 备]              [DB 备]
- 可用性级别:99.9%
- 故障转移时间:分钟级
- 单点:DNS、LB 主备切换、DB 主备切换
10.2 第二阶段:同城双活
[用户] → [GSLB] → [机房 A: LB → 应用集群 → DB 主] ←→ [机房 B: LB → 应用集群 → DB 备]
- 可用性级别:99.99%
- 应用层双活,数据库主备
- 机房 A 故障时,机房 B 的数据库需要提升为主
10.3 第三阶段:异地多活
[北方用户] → [GSLB] → [华北机房: 全量服务]
[南方用户] → [GSLB] → [华南机房: 全量服务]
         ↓
[数据同步] ← 双向复制 / 消息队列
- 可用性级别:99.999%
- 每个机房都是全量服务
- 核心挑战:数据冲突解决、流量调度、全局 ID
10.4 单元化架构
单元化是异地多活的一种高级形式:
[用户 ID 路由] → [单元 1: 完整服务链路]  → [全局 DB]
              → [单元 2: 完整服务链路]  → [全局 DB]
              → [单元 N: 完整服务链路]  → [全局 DB]
- 每个单元是一个完整的、自包含的服务栈
- 用户通过 ID 哈希路由到固定单元
- 单元内闭环,减少跨单元调用
- 故障隔离:一个单元故障只影响该单元的用户
11. 常见陷阱与故障案例
陷阱 1:伪冗余
一个典型的伪冗余场景:主备数据库部署在同一台物理机上,或者共享同一个电源。物理机故障时,主备一起挂。
教训:冗余必须考虑故障域隔离——物理机、机架、电源、网络交换机、机房。
陷阱 2:故障转移不测试
很多团队的故障转移只是"配置了",从来没真正测试过。等到真正故障时,发现切换脚本有 Bug、数据不一致、DNS 没生效。
教训:定期进行故障演练(Chaos Engineering),在可控环境中验证故障转移流程。
陷阱 3:超时不合理
"超时设长一点就不容易超时了"——这是最常见也最危险的误解。长超时意味着:线程池被占满、连接池耗尽、级联故障扩散。
教训:超时应该基于 P99 延迟设置,通常设为 P99 * 2,并配合超时传播。
陷阱 4:降级逻辑不验证
降级开关配了,但降级逻辑从来没执行过。故障时降级开关打开,才发现降级代码有 Bug,反而引发更严重的问题。
教训:降级逻辑必须经过测试和演练,确保降级后系统行为符合预期。
故障案例:某电商大促的级联故障
推荐服务响应变慢(依赖的算法服务超时)
→ 调用推荐服务的商品详情页线程池占满
→ 商品详情页不可用
→ 用户无法下单
→ 整个交易链路瘫痪
根因:推荐服务没有设置合理的超时和熔断,商品详情页没有对推荐服务做降级。
修复:推荐服务增加超时和熔断,商品详情页对推荐服务做降级(返回默认推荐)。
12. 面试官提问
以下问题从面试官视角出发,考察对高可用设计的深度理解和实际工程经验。
Q1:你们系统现在是什么级别的可用性?如果需要从 99.9% 提升到 99.99%,你会怎么规划?
参考答案:
从 99.9%(年停机 8.76 小时)提升到 99.99%(年停机 52.56 分钟),核心是把"人工恢复"变成"自动恢复",同时消除关键路径上的单点。
具体规划分四步:
第一步:消除基础设施单点。 应用服务器做多实例无状态部署,数据库从单主升级为主从+自动切换(如 MySQL MHA/Orchestrator),负载均衡从单台 LB 升级为 LB 集群(Keepalived + VIP 漂移或云 LB)。
第二步:建立自动化故障转移。 应用层通过健康检查 + 自动摘流实现秒级切换;数据层配置自动主从切换,切换时间控制在 30 秒内;DNS 层面配置多解析 + 健康检查,实现入口层自动容灾。
第三步:引入降级和熔断。 核心链路逐个梳理依赖,对非强依赖做降级开关;引入熔断器(如 Hystrix/Sentinel/Resilience4j),防止慢依赖拖垮主链路;建立降级预案和演练机制。
第四步:建立度量体系。 定义 SLI/SLO,建立错误预算机制;搭建全链路监控和告警;定期做故障演练(Chaos Engineering),验证切换流程的有效性。
关键认知:从 99.9% 到 99.99% 不是加机器能解决的,本质是运维自动化 + 架构改造 + 组织能力的提升。
Q2:假设你们的数据库主库宕机,描述一下从故障发生到服务恢复的完整时间线,每个环节分别需要多少时间?哪些环节可以优化?
参考答案:
一个典型的自动故障转移时间线(以 MySQL + MHA/Orchestrator 为例):
| 阶段 | 时间 | 操作 |
|---|---|---|
| 故障检测 | 3-30s | 监控系统通过心跳检测到主库不可达,连续 N 次确认后触发告警 |
| 确认故障 | 0-5s | 从多个检测点交叉验证,排除网络抖动假阳性 |
| 选主 | 1-5s | 从所有从库中选出数据最新的作为新主 |
| 数据补齐 | 0-30s | 如果旧主有已提交但未同步到从库的 binlog,尝试补齐(取决于网络和日志量) |
| 切换拓扑 | 1-5s | 修改其他从库的复制源指向新主,更新 VIP/Proxy 指向新主 |
| 应用层感知 | 1-30s | 连接池重建连接,DNS/VIP 生效 |
| 业务恢复 | 总计 30s-120s | 服务完全恢复 |
可优化的环节:
- 故障检测:从 30s 优化到 3-5s,使用更激进的心跳策略(但要配合假阳性过滤)
- 数据补齐:使用半同步复制(semi-sync replication)可减少甚至消除这个阶段
- 应用层感知:连接池配置合理的超时和重试策略,避免长时间等待失效连接;使用数据库 Proxy(如 ProxySQL)可以做到对应用透明的切换
- DNS/VIP:如果使用 DNS 做切换,TTL 设为 30s 以内
最容易忽视的优化点:切换后的预热。新主库刚接管时 Buffer Pool 是冷的,查询性能会骤降,需要提前做预热或使用从库的热 Buffer Pool 迁移。
Q3:Raft 协议中,如果网络分区导致一个节点被隔离,它发现自己不再是 Leader 后还能继续响应读请求吗?为什么?
参考答案:
不能。 被隔离的旧 Leader 一旦发现自己不再能收到多数派的响应(心跳超时),会立即降级为 Follower,停止响应所有读写请求。
原因在于 Raft 的安全性保证——Leader Completeness Property(领导人完全特性):一旦一个日志条目被提交(被多数派确认),所有后续的 Leader 都会包含这个条目。如果旧 Leader 在网络分区后继续响应读请求,它可能返回过期的数据,因为新的 Leader 可能已经提交了它不知道的日志条目。
具体来说:
- 网络分区后,被隔离的旧 Leader 无法收到多数派的 AppendEntries 响应
- 选举超时到期后,旧 Leader 变成 Follower(不再认为自己有 Leader 身份)
- 此时客户端如果向旧 Leader 发请求,旧 Leader 会拒绝(返回 "not leader" 错误)
- 客户端需要重定向到新的 Leader
延伸问题:Raft 允许 Leader 从本地状态读取吗?是的,Raft 允许 Leader 在确认自己仍然是 Leader 后(通过 heartbeat 确认自己仍能和多数派通信)从本地读取,但这只适用于正常运行的 Leader,不适用于被网络分区隔离的情况。
Q4:你们系统的超时时间是怎么设置的?有没有遇到过因为超时设置不合理导致的问题?
参考答案:
超时设置的方法论:
- 基于 P99 延迟设置:超时 = P99 延迟 × 2 ~ 3。例如某依赖的 P99 延迟是 200ms,超时设为 500ms。
- 区分连接超时和读取超时:连接超时通常设 200ms-1s(建连很快),读取超时基于业务延迟。
- 超时传播:在微服务调用链中,下游的超时必须小于上游的剩余时间。使用 gRPC deadline 或自定义 trace header 传递 deadline。
- 分级设置:核心链路的超时可以适当放宽,非核心链路收紧。
常见问题案例:
- 问题 1:超时与重试的叠加效应。 一同事把超时从 3s 改成 1s,"优化"响应速度。结果 1s 内没返回的请求全部超时+重试,下游收到 3 倍请求,直接被打挂。教训:缩短超时必须同时减少重试次数或增加退避。
- 问题 2:连接池超时设得太长。 数据库连接池的
connectionTimeout设了 30s,当数据库慢查询占满连接时,新请求排队 30s 才超时,整个线程池耗尽。教训:获取连接的超时应远小于请求超时(通常 200ms-1s)。 - 问题 3:没有超时传播。 服务 A 设 5s 超时,内部调用 B(3s 超时),B 调用 C(3s 超时)。某次 C 变慢,A 等 5s 超时,但 B 的线程已经被 C 占满 3s 才释放,导致 B 的线程池快速耗尽。教训:必须做超时传播,B 调用 C 的超时 = A 剩余时间 - 自身处理时间。
Q5:设计一个秒杀系统的降级方案:当流量远超预期时,哪些功能可以降级?降级的优先级怎么排?
参考答案:
秒杀场景的降级核心原则:保障交易闭环(下单→支付),其他都可以牺牲。
降级优先级(从高到低,越靠前越先降级):
L1 — 立即降级(非核心功能,不影响交易):
- 推荐/猜你喜欢 → 返回静态缓存列表
- 商品评论/评分 → 隐藏模块
- 浏览历史/足迹 → 关闭记录
- 营销弹窗/优惠券推荐 → 全部关闭
- 实时数据大屏 → 关闭或降低刷新频率
L2 — 流量过大时降级(提升性能):
- 商品详情页 → 静态化,CDN 缓存,去掉动态库存查询
- 购物车 → 限制购物车商品数量,关闭非核心计算
- 用户画像/个性化 → 使用默认策略
- 日志 → 采样或异步批量写入,关闭 DEBUG 日志
L3 — 极端情况降级(保障核心链路):
- 验证码 → 关闭或降低难度
- 风控 → 切换到轻量级规则引擎
- 库存扣减 → 从实时扣减改为异步扣减(有超卖风险,需权衡)
不可降级(核心功能):
- 用户登录/鉴权
- 下单(创建订单)
- 支付
- 库存扣减(至少保证最终一致性)
技术实现:
- 配置中心集中管理降级开关,支持一键降级和一键恢复
- 客户端也做降级:前端隐藏不可用模块,而非等待接口超时
- 降级后要有监控:确认降级生效,且核心链路 RT 回到正常范围
Q6:为什么 Kubernetes 的 etcd 集群推荐使用奇数个节点(3 或 5)?如果是偶数个节点会有什么问题?
参考答案:
核心原因:Quorum(法定人数)机制。
etcd 使用 Raft 共识算法,写操作需要获得 多数派(majority) 节点的同意才算提交。多数派 = N/2 + 1(向下取整后加 1)。
| 节点数 | 多数派 | 容忍故障数 | 效率 |
|---|---|---|---|
| 1 | 1 | 0 | — |
| 2 | 2 | 0 | 浪费 |
| 3 | 2 | 1 | 最优 |
| 4 | 3 | 1 | 浪费 |
| 5 | 3 | 2 | 推荐 |
| 6 | 4 | 2 | 浪费 |
| 7 | 4 | 3 | 规模大 |
偶数节点的问题:
以 4 节点为例——容忍故障数仍然是 1(和 3 节点一样),但多了一台机器的成本、网络开销和运维复杂度。4 节点集群的写操作延迟略高于 3 节点(因为需要 3 个节点确认而非 2 个),但可用性没有提升。
更关键的是,4 节点在某些网络分区场景下反而更脆弱:如果分区成 2+2,没有一方达到多数派(3),集群完全不可用。而 3 节点分区成 2+1 时,2 节点那方可以继续工作。
工程建议: 生产环境推荐 3 节点或 5 节点。3 节点足以应对大多数场景,5 节点在需要更高容错(容忍 2 台故障)时使用。超过 7 节点反而会因为 Raft 日志复制的开销降低写性能。
Q7:你们系统中有没有"伪冗余"的情况?比如看起来有备份,但实际共享了某个故障域?
参考答案:
这道题考察的是对故障域(Failure Domain)的理解。伪冗余的典型场景:
场景 1:同物理机部署。 主备数据库部署在同一台物理机的不同虚拟机上,物理机宕机 → 主备一起挂。正确做法:主备必须在不同物理机,甚至不同机架。
场景 2:同机架/同电源。 两台服务器做了主备,但插在同一个 PDU(电源分配单元)上。PDU 故障 → 两台一起断电。正确做法:关键服务的主备跨机架、跨电源部署。
场景 3:同交换机。 主备节点连在同一台交换机上,交换机故障 → 主备同时断网。正确做法:网络双上联,主备连接不同交换机。
场景 4:云服务的"伪多 AZ"。 在云平台上,两个可用区(AZ)可能在同一个物理园区内,共享电力、冷却等基础设施。遇到区域性灾害(如断电、火灾)时两个 AZ 可能同时受影响。正确做法:了解云厂商的 AZ 物理隔离程度,关键业务考虑跨 Region 部署。
场景 5:同配置中心。 主备集群的切换逻辑依赖同一个配置中心(如 ZooKeeper),配置中心本身挂了 → 主备切换机制失效。正确做法:切换逻辑要有本地兜底,不能完全依赖外部协调器。
场景 6:同发布系统。 主备环境通过同一套 CI/CD 发布,发布系统推送了有 Bug 的版本 → 主备环境同时受影响。正确做法:灰度发布,先发备环境验证,再发主环境(或反过来)。
自查方法: 画一张故障域树,从物理机 → 机架 → 电源 → 交换机 → 机房 → 城市 → 国家,逐层检查每个关键组件的主备是否落在不同故障域上。
Q8:CAP 理论中,高可用设计在遇到网络分区时,如何在 C 和 A 之间做取舍?举例说明。
参考答案:
CAP 理论的核心:当网络分区(Partition)发生时,你必须在一致性(Consistency)和可用性(Availability)之间做选择。没有分区时,C 和 A 可以兼得。
选择 CP(一致性优先)的场景:
- 金融交易系统:宁可暂时不可用,也不能出现账户余额不一致。例如银行转账,网络分区后如果两个机房各处理了一半转账,恢复后余额对不上是灾难性的。
- 库存扣减:秒杀场景,宁可告诉用户"系统繁忙",也不能超卖。
- 分布式锁:ZooKeeper/etcd 的锁服务,分区时宁可锁不可用,也不能两个客户端同时获得锁。
选择 AP(可用性优先)的场景:
- 社交媒体的点赞数:短暂的不一致(一条朋友圈显示 100 赞,另一个用户看到 99 赞)完全可接受,但服务不可用不可接受。
- CDN 内容分发:节点间内容短暂不一致(某个节点上的图片还是旧版本)可以接受,因为最终会同步。
- DNS 解析:DNS 天然是 AP 系统,各地 DNS 缓存可能不一致,但最终会收敛。
工程中的实际取舍——不是二选一:
实际系统很少做绝对的 C 或 A 选择,而是在同一个系统中对不同数据做不同选择:
- 支付宝转账:金额走 CP(强一致),转账附言走 AP(最终一致)
- 电商订单:订单状态走 CP,商品浏览记录走 AP
- 实时性要求高的用 CP,实时性要求低的用 AP
BASE 理论就是 AP 系统的实践指导:Basically Available(基本可用)、Soft state(软状态)、Eventually consistent(最终一致)。
下一篇:195|可扩展架构:无状态化、水平扩展、分片、异步化和热点治理