一、问题定义与背景
你打开手机,一条微信消息弹出来,几乎和你朋友按下发送键的同时出现在你屏幕上。你下单后,物流状态更新通知几秒内就推送到通知栏。你关注的直播间,主播开播提醒从未迟到——这些场景背后,都是同一套系统在支撑:实时消息推送系统。
1.1 推送 vs 轮询 vs 长轮询
这三个概念常被混淆,但它们的本质区别在于"谁来发起请求":
| 方案 | 机制 | 实时性 | 资源消耗 | 适用场景 |
|---|---|---|---|---|
| 短轮询 | 客户端定时发起 HTTP 请求 | 取决于轮询间隔 | 高(大量无效请求) | 对实时性要求不高的场景 |
| 长轮询 | 客户端发起请求,服务端 hold 住直到有数据 | 较好 | 中(减少无效请求) | 兼容性要求高的场景 |
| 长连接推送 | 建立 TCP 长连接,服务端主动推送 | 实时 | 低(一次连接持续复用) | 高实时性、高并发场景 |
核心区别:轮询是客户端"拉",长连接推送是服务端"推"。从"拉"到"推"的转变,本质上是信息传递模型的根本性变革——从请求-响应模型变为事件驱动模型。
1.2 核心挑战
设计一个生产级的实时推送系统,需要面对四个核心挑战:
- 海量连接:千万级同时在线,每台服务器维持数十万 TCP 连接,对操作系统内核参数、内存管理、网络模型都是极限考验。
- 低延迟:消息从发送到送达以毫秒计。IM 场景要求 P99 < 200ms,高并发活动场景(如直播弹幕)要求 P99 < 100ms。
- 高送达率:消息不能丢、不能重复、不能乱序。要覆盖在线推送、离线补推、厂商通道降级三条路径,送达率目标 99.99% 以上。
- 资源成本:海量连接意味着巨大的服务器、带宽和存储成本,需要在架构上做好取舍。
二、长连接技术选型
2.1 WebSocket 协议
WebSocket 是实时推送领域最主流的方案。它的核心优势在于全双工通信——服务端和客户端可以随时互发消息,且只需要一次 HTTP 握手。
握手过程:
客户端发起一个 HTTP Upgrade 请求:
GET /chat HTTP/1.1
Host: server.example.com
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Key: dGhlIHNhbXBsZSBub25jZQ==
Sec-WebSocket-Version: 13
服务端响应 101 Switching Protocols:
HTTP/1.1 101 Switching Protocols
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Accept: s3pPLMBiTxaQ9lYG6hP4hK8=
握手完成后,TCP 连接升级为 WebSocket 连接,后续数据以帧(Frame)的形式传输。WebSocket 帧格式非常紧凑,每个帧只有 2-14 字节的头开销,远小于 HTTP 请求头。
关键技术细节:
- Ping/Pong 帧:WebSocket 协议内置心跳机制,服务端发送 Ping 帧,客户端回复 Pong 帧。这与应用层心跳是互补的——协议层心跳检测连接是否存活,应用层心跳检测业务逻辑是否正常。
- Close 帧:优雅关闭连接,携带关闭码和原因描述,便于问题排查。
- 掩码(Mask):客户端到服务端的帧必须掩码,防止缓存投毒攻击。服务端到客户端的帧不需要掩码。
- 分片(Fragmentation):支持大消息分片传输,每片都是一个独立的帧。
WebSocket 的局限性:
- 不支持 HTTP/2 的多路复用(HTTP/2 下每个 WebSocket 占用一个独立 TCP 连接)
- 需要客户端和服务端都支持 WebSocket,部分老旧代理/CDN 不兼容
- 移动端在弱网环境下频繁重连开销较大
▲ 图1:WebSocket 协议握手与帧格式示意
2.2 SSE(Server-Sent Events)
SSE 是 W3C 标准,基于 HTTP 协议实现服务端到客户端的单向数据推送。
// 客户端代码
const eventSource = new EventSource('/api/events');
eventSource.onmessage = (event) => {
  console.log('收到消息:', event.data);
};
SSE 的优势:
- 基于 HTTP,兼容所有 HTTP 代理和 CDN
- 自动重连机制(EventSource API 内置,断线后自动重连,Last-Event-ID 机制保证消息不丢)
- 协议简洁,浏览器原生支持,无需引入第三方库
SSE 的局限:
- 仅支持服务端到客户端的单向推送,客户端发送消息需要另开 HTTP 请求
- 浏览器限制:同一个域名下最多 6 个 SSE 连接(HTTP/1.1 限制,HTTP/2 下无此限制)
- 不支持二进制数据(仅支持 UTF-8 文本)
2.3 长轮询(Long Polling)
长轮询是兼容性最佳的方案。客户端发起 HTTP 请求,服务端如果没有数据就 hold 住连接不返回,直到有数据或超时。
客户端 → 服务端:GET /poll?seq=100
服务端:(等待新消息...)
服务端 → 客户端:200 OK { messages: [...] }
客户端 → 服务端:GET /poll?seq=105
长轮询的适用场景:
- 作为 WebSocket 不可用时的降级方案
- 浏览器兼容性要求极高的场景(如 IE 9)
- 防火墙/代理限制 WebSocket 的企业内网
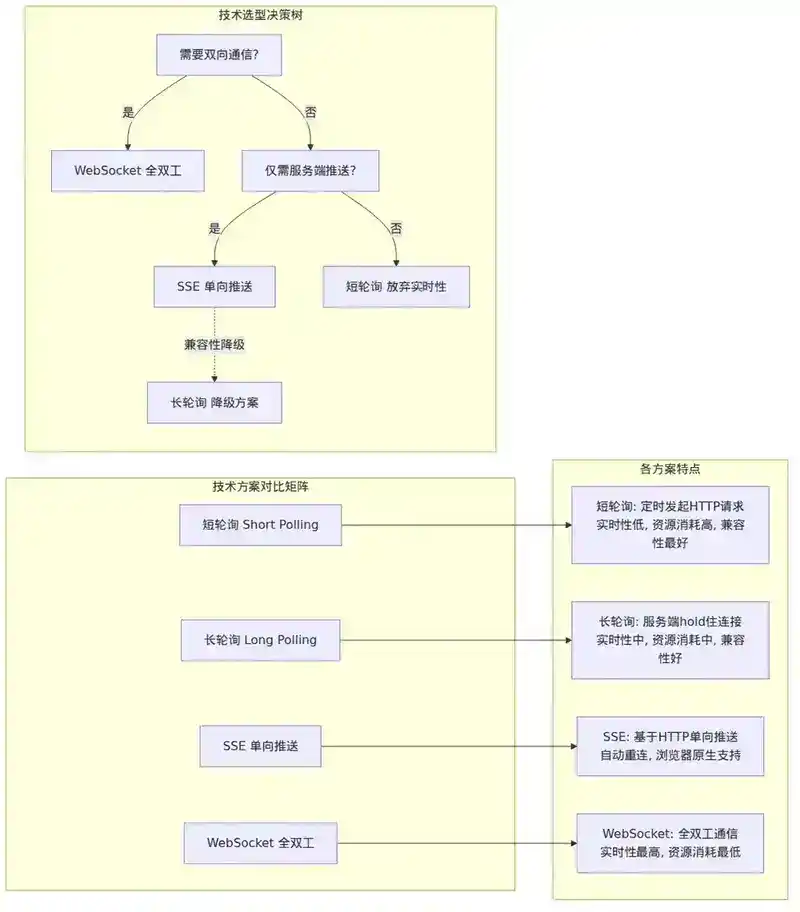
2.4 技术选型决策树
是否需要双向通信?
├── 是 → WebSocket
│   └── 移动端 → WebSocket + 厂商通道(APNs/FCM)保活
└── 否 → 只需要服务端推送?
    ├── 是 → SSE(Web 端首选)
    │   └── 兼容性要求高 → 长轮询
    └── 否 → 短轮询(放弃实时性)
2.5 移动端长连接的保活策略
移动端长连接面临独特的挑战:系统为了省电会杀死后台进程、切断网络连接。Android 厂商(华为、小米、OPPO/vivo)的后台限制各不相同,iOS 的 VoIP 推送机制也已收紧。
Android 保活策略:
- 前台服务(Foreground Service):在通知栏显示常驻通知,提升进程优先级
- 双进程守护:两个进程互相监听,一方被杀另一方拉起(Android 8.0+ 已基本失效)
- JobScheduler / WorkManager:利用系统定时任务周期性拉活
- 厂商通道兜底:核心消息走华为/小米/OPPO 等厂商通道保证送达
- Socket 心跳:自适应心跳间隔,WiFi 下 4-5 分钟,4G 下 5-15 分钟
iOS 保活策略:
- APNs 推送:主要依赖 APNs(Apple Push Notification service),应用在后台时消息通过 APNs 推送
- VoIP Push(已被限制):iOS 13+ 收紧 VoIP 推送,仅限通话类应用
- Background Modes:有限的后台运行时间,通常 30 秒左右
- App 前台时:建立 WebSocket 长连接,App 进入后台后切换到 APNs
三、连接管理核心架构
3.1 连接生命周期
一个长连接从建立到销毁,经历以下阶段:
[客户端]                          [服务端]
   |                                |
   |--- TCP 三次握手 -------------->|
   |--- WebSocket 握手 ------------>|
   |<-- 101 Switching Protocols ----|
   |--- 认证消息(Token)---------->|
   |<-- 认证成功 / 失败 ------------|
   |--- Ping/Pong 心跳 <---------->|
   |--- 业务消息 <---------------->|
   |--- Close 帧 ----------------->|
   |--- TCP 四次挥手 -------------->|
关键设计要点:
- 认证阶段:连接建立后首条消息必须是认证消息,携带 Token 或签名。未认证的连接不分配任何业务资源,超时未认证直接断开。
- 心跳维持:双向心跳。服务端定期发送 Ping,客户端回复 Pong。客户端也定期发送心跳,服务端检测心跳超时则断开连接。
- 重连时 Session 恢复:客户端断线重连时携带上次的 Session ID,服务端恢复连接上下文,避免重新认证和订阅重建。
- 销毁:优雅关闭时发送 Close 帧,通知对端。异常断开时由心跳超时检测。
▲ 图2:连接生命周期状态转换图
3.2 连接路由层
当系统有多个长连接网关节点时,客户端需要连接到正确的节点:
                       ┌──────────────┐
                       │   DNS / LVS  │
                       └──────┬───────┘
                              │
              ┌───────────────┼───────────────┐
              │               │               │
        ┌─────▼─────┐  ┌─────▼─────┐  ┌─────▼─────┐
        │ Gateway-1 │  │ Gateway-2 │  │ Gateway-3 │
        │ WebSocket │  │ WebSocket │  │ WebSocket │
        └───────────┘  └───────────┘  └───────────┘
              │               │               │
              └───────────────┼───────────────┘
                              │
                    ┌─────────▼─────────┐
                    │   消息路由服务     │
                    └───────────────────┘
路由策略:
- 随机路由:客户端随机连接一个网关节点。优点是简单,缺点是消息路由时需要查找目标用户所在的网关节点。
- 一致性哈希路由:按用户 ID 哈希到固定节点。优点是消息路由简单(同节点内直接推送),缺点是节点故障时大量用户重连。
- 混合路由:客户端随机连接,服务端维护"用户 → 网关节点"的映射表(存 Redis)。消息路由时查表找到目标节点。这是生产环境最常见的方案。
▲ 图3:连接路由层架构:网关集群与消息路由
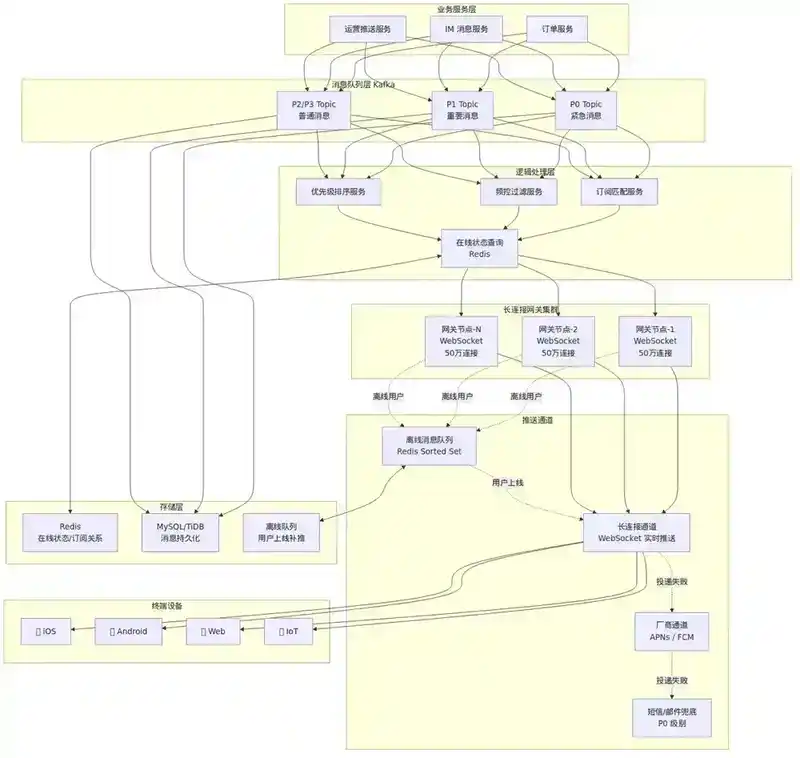
3.3 连接状态机
          ┌──────┐
          │ INIT │ 初始状态
          └──┬───┘
             │ TCP 连接建立
          ┌──▼──────┐
          │CONNECTED│ 已连接,等待认证
          └──┬──────┘
             │ 认证成功
          ┌──▼──────────┐
          │AUTHENTICATED│ 已认证,可订阅
          └──┬──────────┘
             │ 订阅完成
          ┌──▼──────┐
          │  ACTIVE │ 活跃状态,可收发消息
          └──┬──────┘
             │ 心跳超时 / 主动断开
          ┌──▼──────────┐
          │ DISCONNECTED│ 已断开,等待清理
          └──┬──────────┘
             │ 资源回收
          ┌──▼──────┐
          │  CLOSED │ 终态
          └─────────┘
▲ 图4:连接状态机设计
3.4 心跳机制设计
心跳是长连接的生命线,设计不当会导致连接假死或资源浪费。
自适应心跳:
# 伪代码:自适应心跳算法
def adaptive_heartbeat(last_rtt_ms):
    if last_rtt_ms < 200:
        return min(300_000, heartbeat_interval_ms * 2)  # 网络好,逐步延长
    elif last_rtt_ms > 1000:
        return max(30_000, heartbeat_interval_ms / 2)    # 网络差,缩短检查
    else:
        return heartbeat_interval_ms                      # 保持当前间隔
关键参数:
- WiFi 环境:心跳间隔 4-5 分钟
- 4G/5G 环境:心跳间隔 5-15 分钟(NAT 超时通常 10-15 分钟)
- 心跳超时判定:连续 N 次(通常 3 次)未收到心跳响应,判定连接断开
- 心跳最小间隔:不低于 30 秒,避免功耗和带宽浪费
3.5 单机连接数瓶颈
一台 Linux 服务器能维持多少 TCP 长连接?
| 瓶颈 | 默认值 | 优化后 | 说明 |
|---|---|---|---|
| 文件描述符 | 1024 (ulimit -n) | 1000000+ | 每个连接占用一个 fd |
| 端口范围 | 32768-60999 | 可调整 | 仅影响客户端出站连接 |
| 内存 | 每个连接 ~4KB(内核)+ ~10KB(应用层) | 100万连接 ≈ 14GB | 需调优 JVM 堆外内存 |
| CPU | 取决于消息吞吐 | 需压测 | epoll 模型下空闲连接 CPU 开销极低 |
生产环境经验值:一台 16C/32G 的服务器,使用 Netty + epoll 模型,可稳定维持 50-80 万 WebSocket 长连接。
四、订阅管理模型
4.1 订阅模型设计
订阅模型决定了消息如何路由到正确的用户。常见的订阅模型有三层:
用户层:user:1001
  ├── Topic 订阅:topic:order_update(订单状态变更)
  ├── Topic 订阅:topic:system_notice(系统通知)
  ├── Tag 订阅:topic:order_update + tag:refund(仅退款类订单)
  └── 条件订阅:price < 100 AND category = 'electronics'
Topic 订阅:最基础的模式,类似 Kafka 的消息主题。用户订阅一个 Topic,该 Topic 下的所有消息推送给他。
Tag 订阅:在 Topic 基础上的二级过滤。例如用户订阅 topic:order_update 但只关心 tag:refund,减少不必要的推送。
条件订阅:最灵活的方案,支持基于消息内容的表达式过滤。实现成本高,通常用规则引擎(如 CEL、Aviator)解析。
▲ 图5:订阅模型三层结构:Topic / Tag / 条件订阅
4.2 订阅关系存储
// 内存中的订阅关系结构
ConcurrentHashMap<String, Set<Long>> topicToUsers = new ConcurrentHashMap<>();
// topic:order_update → {user1, user2, user3}

ConcurrentHashMap<Long, Connection> userIdToConnection = new ConcurrentHashMap<>();
// user1 → WebSocket Connection Object
两层存储架构:
- 内存(一级缓存):网关节点本地内存,存储本节点连接用户的订阅关系,订阅匹配时直接查内存,延迟 < 1ms
- Redis(二级持久化):全局订阅关系,用户断线重连到其他节点时从 Redis 恢复订阅关系
4.3 用户多端登录
一个用户可能在手机、电脑、平板同时在线,消息如何分发?
user:1001
├── device:mobile_abc  → Gateway-1 (WebSocket)
├── device:pc_xyz      → Gateway-2 (WebSocket)
└── device:pad_def     → Gateway-1 (APNs 离线)
多端消息同步策略:
- 所有设备都能收到同一消息(默认行为,适合 IM 场景)
- 按设备优先级分发(如手机优先推送,PC 仅展示)
- 最后活跃设备策略(只推送到最近活跃的设备,节省资源)
4.4 在线状态管理
在线状态是推送系统的基础能力,不能错判在线/离线,否则消息要么漏推要么无效推送。
// 在线状态存储(Redis)
user:1001:online_status = {
    "status": "online",
    "last_heartbeat": 1694076800000,
    "gateway_node": "gateway-1",
    "devices": ["mobile_abc", "pc_xyz"]
}
状态变更触发:
- 连接建立 → 状态变更为 online
- 心跳超时 → 状态变更为 offline
- 主动登出 → 状态变更为 offline
- 优雅关闭 → 状态变更为 offline
一致性保障:在线状态由网关节点负责维护,Redis 作为全局状态存储。网关节点故障时,通过 Redis 的 TTL 机制自动清除过期状态。
五、分级推送策略
5.1 消息优先级分级
不是所有推送都同等重要。一条 IM 消息和一条运营活动推送,对用户的价值不同,对系统资源的要求也不同。
| 优先级 | 场景 | 延迟要求 | 送达率要求 | 通道 |
|---|---|---|---|---|
| P0 紧急 | 安全告警、支付确认 | < 1s | 99.999% | 全通道(长连接 + 厂商 + 短信) |
| P1 重要 | IM 消息、订单状态 | < 2s | 99.99% | 长连接 + 厂商通道 |
| P2 普通 | 系统通知、评论回复 | < 10s | 99.9% | 长连接 + 厂商通道(降频) |
| P3 静默 | 运营推送、活动通知 | < 30s | 99% | 厂商通道(静默推送) |
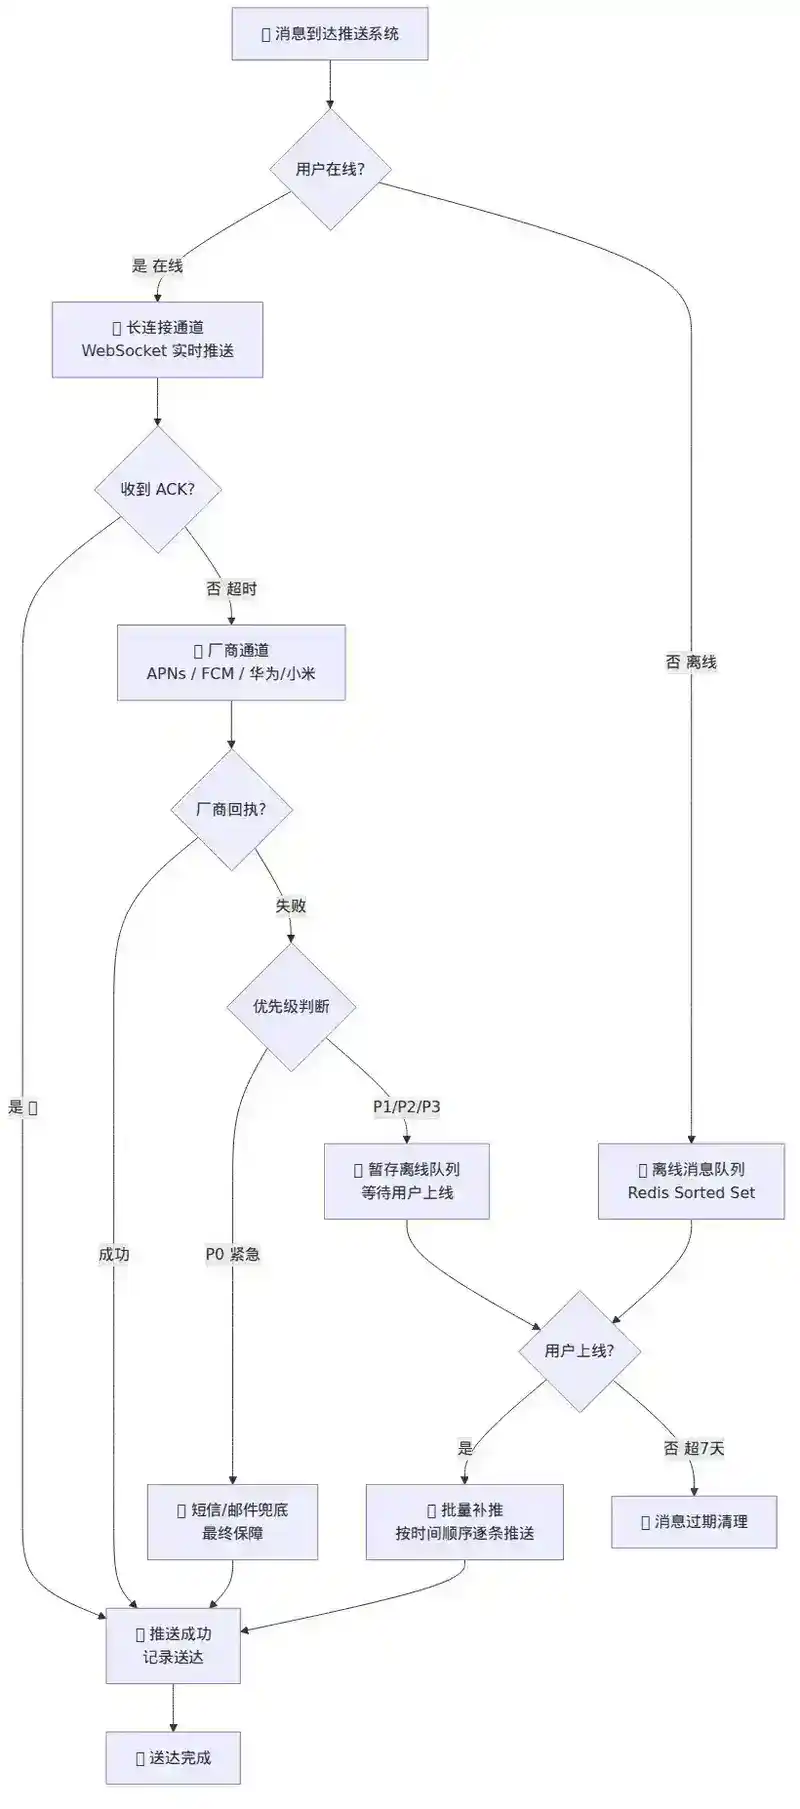
5.2 多通道推送策略
消息到达
    │
    ▼
┌──────────────┐  在线?  ┌──────────────┐
│ 长连接通道    │◄────────│  消息路由     │
│ (WebSocket)  │   yes   │              │
└──────┬───────┘         └──────┬───────┘
       │ 投递失败               │ 离线
       ▼                        ▼
┌──────────────┐         ┌──────────────┐
│ 厂商通道      │         │ 离线消息队列  │
│ (APNs/FCM)   │         │ (RocketMQ)   │
└──────┬───────┘         └──────┬───────┘
       │ 投递失败               │ 用户上线
       ▼                        ▼
┌──────────────┐         ┌──────────────┐
│ 短信/邮件兜底 │         │ 补推消息      │
│ (P0 级别)    │         │              │
└──────────────┘         └──────────────┘
通道选择策略:
- 优先尝试长连接通道(成本最低、延迟最低)
- 长连接投递失败(Ack 超时)或用户离线,走厂商通道(APNs/FCM)
- 厂商通道投递失败,P0 级别消息走短信/邮件
- 用户长时间离线,消息存入离线队列,用户上线后补推
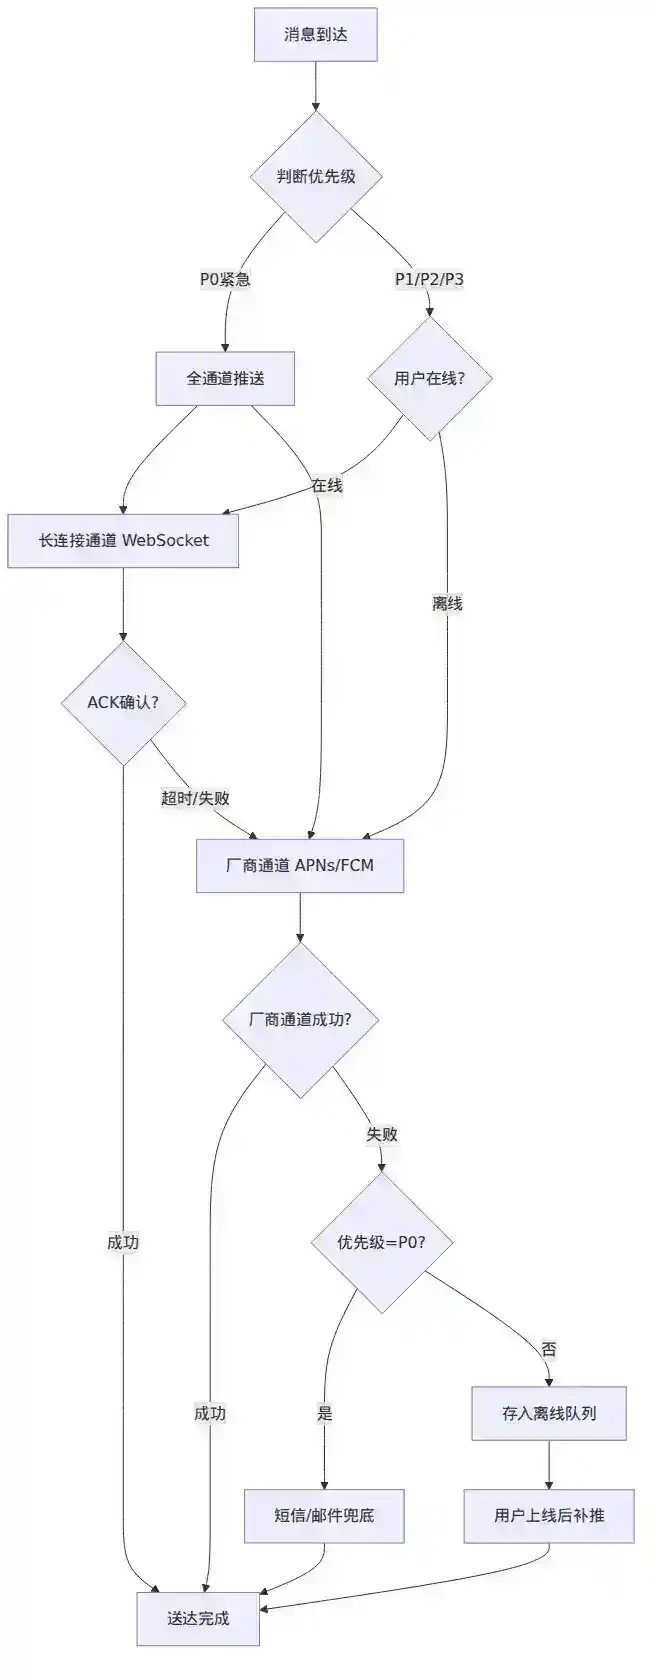
▲ 图6:多通道推送降级策略流程
5.3 频控与防打扰
推送多了用户会关通知,推送少了用户会错过重要消息。频控是用户体验的命门。
// 用户级频控配置
user_frequency_control:
  max_per_hour: 10          // 每小时最多推送 10 条
  max_per_day: 50           // 每天最多推送 50 条
  quiet_hours: "22:00-08:00" // 免打扰时段
  priority_whitelist: [P0, P1] // 白名单优先级不受频控限制
分级频控策略:
- 全局频控:整个系统维度,防止广播风暴
- 用户级频控:单用户维度,保护用户体验
- Topic 级频控:单个主题维度,防止某个 Topic 滥用
- 免打扰时段:夜间只推送 P0/P1 级别消息
六、送达率保障体系
6.1 送达的定义
"送达"不是"发送",两者的区别决定了系统的可靠性设计:
| 指标 | 定义 | 计算方法 |
|---|---|---|
| 到达率 | 消息到达设备 | 设备收到 ACK 数 / 总发送数 |
| 展示率 | 消息展示在通知栏 | 通知栏展示数 / 总发送数 |
| 点击率 | 用户点击了通知 | 点击数 / 展示数 |
推送系统关注的"送达率"通常指到达率(即消息到达设备),目标 99.99% 以上。
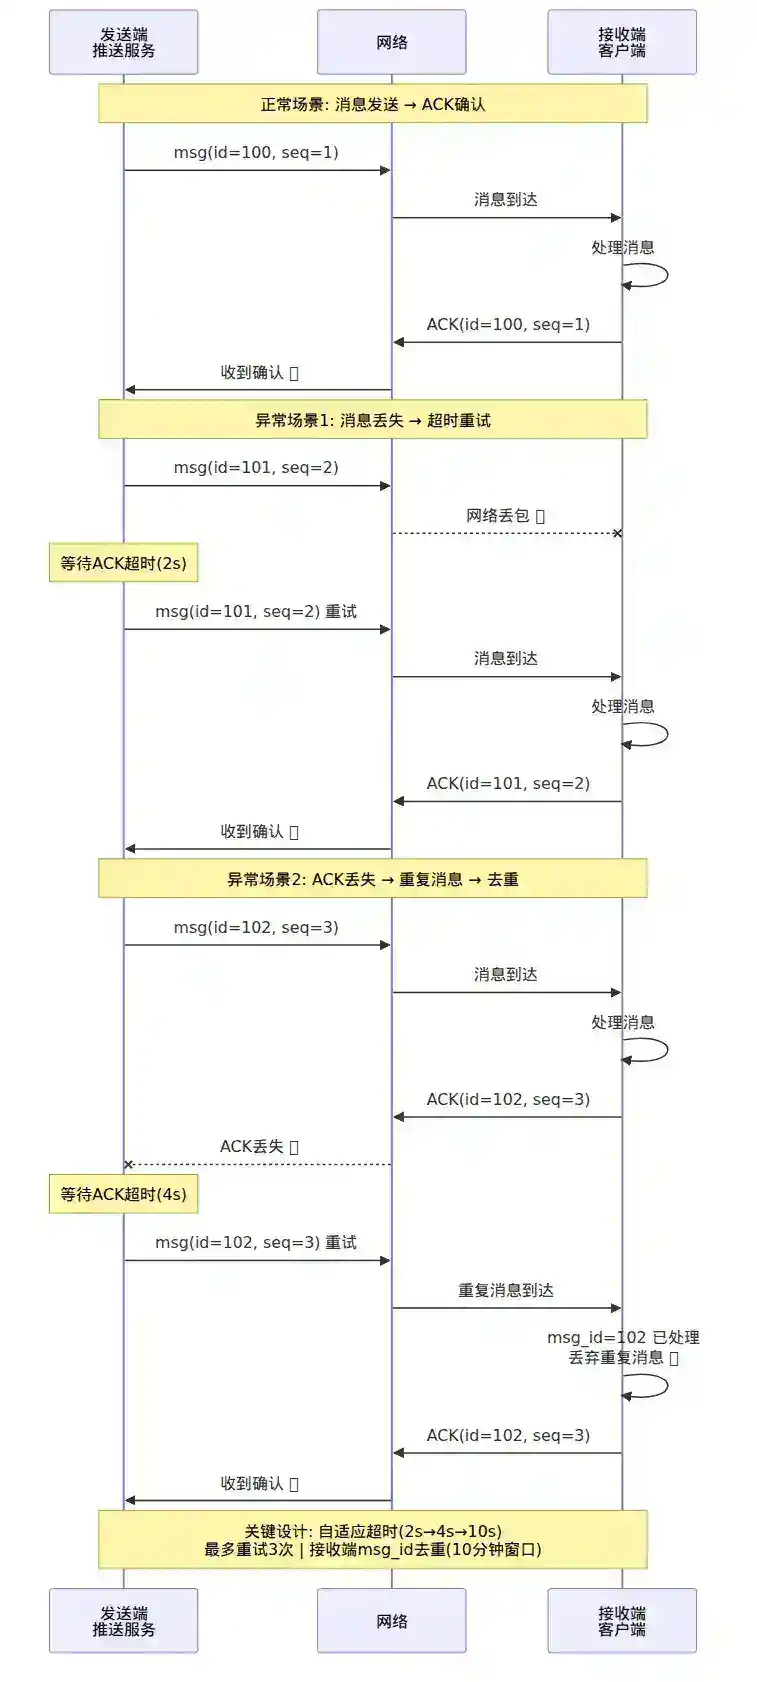
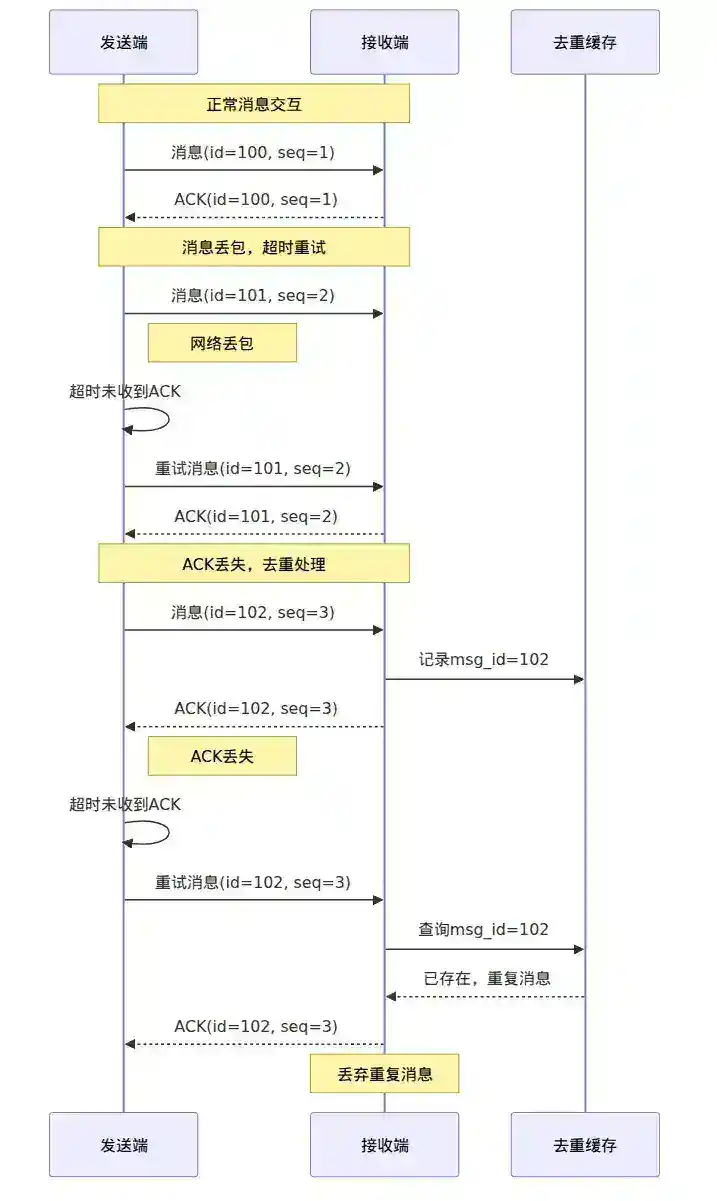
6.2 消息确认机制(ACK 模型)
发送端                          接收端
  │                               │
  │─── msg(id=100, seq=1) ───────►│
  │                               │ 收到,处理
  │◄── ACK(id=100, seq=1) ────────│
  │                               │
  │─── msg(id=101, seq=2) ───────►│ (网络丢包)
  │                               │
  │ 超时未收到 ACK,重试            │
  │─── msg(id=101, seq=2) ───────►│
  │                               │ 收到
  │◄── ACK(id=101, seq=2) ────────│
  │                               │
  │─── msg(id=102, seq=3) ───────►│
  │                               │ 收到(但 ACK 丢失)
  │◄── ACK(id=102, seq=3) ─── X ──│
  │                               │
  │ 超时,重试                      │
  │─── msg(id=102, seq=3) ───────►│
  │                               │ 重复消息!去重处理
  │◄── ACK(id=102, seq=3) ────────│
ACK 超时重试的三个关键设计:
- 超时时间:自适应 RTT,初始 2 秒,逐步增加到 10 秒上限
- 最大重试次数:通常 3 次,超过后标记失败并走降级通道
- 去重:接收端用
msg_id去重,存储最近 10 分钟内已处理的消息 ID 集合
6.3 离线消息处理
用户离线期间的消息不能丢失,需要存储并在用户上线后补推。
离线消息队列设计:
┌─────────────────────────────────────────────────────┐
│ 用户离线消息队列(Redis Sorted Set)                  │
│ Key: offline_msg:user:1001                           │
│ Score: timestamp(消息产生时间)                      │
│ Member: msg_id(消息 ID)                            │
│                                                      │
│ msg_id 对应的消息体存在 Redis Hash 或消息队列中       │
│ Hash Key: offline_msg_body:user:1001                 │
│ Field: msg_id, Value: 消息体 JSON                     │
└─────────────────────────────────────────────────────┘
补推策略:
- 用户上线后,拉取离线消息队列中时间戳 > 上次离线时间的消息
- 按时间顺序逐条推送,每条等待 ACK 后推送下一条
- 消息有效期:超过 7 天的离线消息自动清理,不再推送
- 消息数量限制:单用户最多保留 1000 条离线消息,超出部分丢弃旧消息
6.4 厂商通道可靠性保障
APNs 和 FCM 是移动端推送的最后保障,但它们的可靠性也需要监控:
- APNs 回执处理:APNs 返回 410(设备 token 失效)时,标记该设备 token 为无效,后续不再推送
- FCM 错误码处理:NOT_REGISTERED(卸载)、INVALID_ARGUMENT(参数错误)、UNAVAILABLE(服务不可用)
- 到达率监控:对比发送数 vs 实际到达数,到达率 < 95% 时告警
- 多通道并发:P0/P1 消息可同时走长连接和厂商通道,以先到达的为准
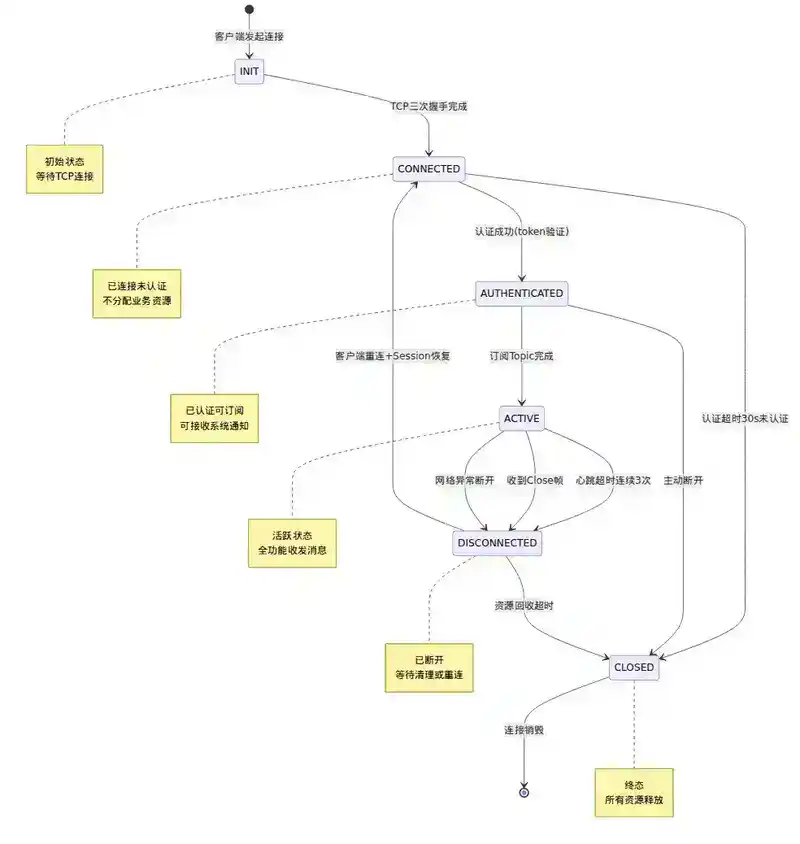
七、系统架构设计
7.1 整体架构
                        ┌─────────────────┐
                        │   业务服务        │
                        │ (订单/IM/运营)    │
                        └────────┬────────┘
                                 │ 发送消息
                                 ▼
                        ┌─────────────────┐
                        │   消息队列        │
                        │   (Kafka)        │
                        └────────┬────────┘
                                 │
                    ┌────────────┼────────────┐
                    ▼            ▼            ▼
              ┌──────────┐ ┌──────────┐ ┌──────────┐
              │ 逻辑层-1  │ │ 逻辑层-2  │ │ 逻辑层-N  │
              │ 订阅匹配  │ │ 订阅匹配  │ │ 订阅匹配  │
              │ 频控过滤  │ │ 频控过滤  │ │ 频控过滤  │
              │ 优先级排序│ │ 优先级排序│ │ 优先级排序│
              └────┬─────┘ └────┬─────┘ └────┬─────┘
                   │            │            │
        ┌──────────┼────────────┼────────────┼──────────┐
        ▼          ▼            ▼            ▼          ▼
  ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐
  │网关节点-1│ │网关节点-2│ │网关节点-3│ │网关节点-N│
  │WebSocket │ │WebSocket │ │WebSocket │ │WebSocket │
  │长连接管理│ │长连接管理│ │长连接管理│ │长连接管理│
  └──────────┘ └──────────┘ └──────────┘ └──────────┘
        │          │            │            │
        └──────────┼────────────┼────────────┘
                   │            │
              ┌────▼────┐  ┌───▼──────┐
              │  Redis  │  │  MySQL/  │
              │ 在线状态│  │  TiDB   │
              │ 订阅关系│  │ 消息持久化│
              │ 离线队列│  │         │
              └─────────┘  └──────────┘
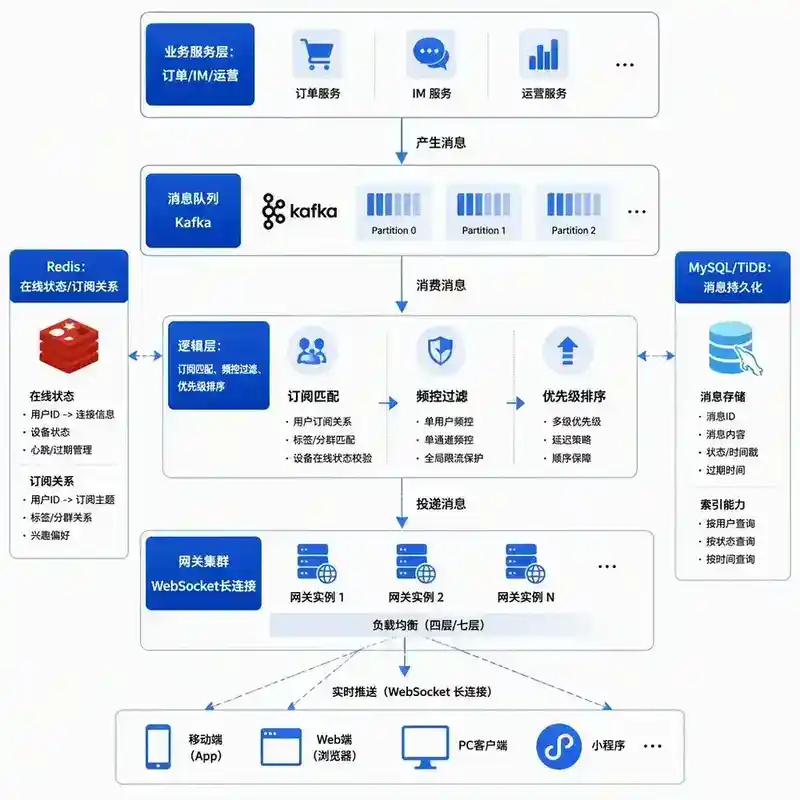
▲ 图7:推送系统整体架构图
7.2 核心数据流
消息推送全链路(从发送到送达):
- 业务服务发送消息 → Kafka Topic(按优先级分 Topic,P0 独立 Topic 保证优先消费)
- 逻辑层消费消息 → 查询 Redis 中的订阅关系 → 匹配目标用户列表
- 频控检查 → 过滤超出频控限制的用户 → 过滤免打扰时段用户
- 查询在线状态 → 在线用户:查 Redis 获取用户所在网关节点 → 路由到对应网关
- 网关推送 → 查找目标用户连接 → 发送消息 → 等待 ACK
- ACK 处理 → 收到 ACK 标记送达成功 → 超时未 ACK 走降级通道
- 离线处理 → 离线用户消息写入离线队列 → 用户上线后补推
▲ 图8:消息推送全链路数据流
7.3 消息去重
在分布式系统中,消息可能因网络重试、Kafka 重平衡等原因重复投递。去重是送达率保障的关键一环。
去重策略:
- 消息 ID 去重:每个消息携带全局唯一 ID(Snowflake),接收端在 Redis 中维护
msg_id → processed_time映射,TTL 为 10 分钟 - Bloom Filter 去重:在内存中使用 Bloom Filter 快速判断消息是否处理过,减少 Redis 查询
- 业务幂等:即使去重失败,业务逻辑也要保证幂等处理
八、性能优化与容量规划
8.1 连接数优化
操作系统层面:
# 文件描述符上限
ulimit -n 1000000

# TCP 相关内核参数
net.ipv4.tcp_tw_reuse = 1        # 复用 TIME_WAIT 连接
net.ipv4.tcp_max_syn_backlog = 8192
net.core.somaxconn = 8192
net.ipv4.ip_local_port_range = 1024 65535
应用层优化(Netty):
EventLoopGroup bossGroup = new NioEventLoopGroup(1);
EventLoopGroup workerGroup = new NioEventLoopGroup(
    Runtime.getRuntime().availableProcessors() * 2
);

ServerBootstrap bootstrap = new ServerBootstrap()
    .group(bossGroup, workerGroup)
    .channel(NioServerSocketChannel.class)
    .option(ChannelOption.SO_BACKLOG, 8192)
    .childOption(ChannelOption.SO_KEEPALIVE, true)
    .childOption(ChannelOption.TCP_NODELAY, true)
    .childOption(ChannelOption.SO_RCVBUF, 8192)
    .childOption(ChannelOption.SO_SNDBUF, 8192)
    .childHandler(new ChannelInitializer<SocketChannel>() {
        @Override
        protected void initChannel(SocketChannel ch) {
            // 空闲检测:读空闲 60s 触发心跳回调
            ch.pipeline().addLast(new IdleStateHandler(60, 0, 0));
            ch.pipeline().addLast(new WebSocketServerProtocolHandler("/ws"));
            ch.pipeline().addLast(new MessageHandler());
        }
    });
8.2 内存优化
- 对象池化:复用 ByteBuf 和 Message 对象,减少 GC 压力
- 堆外内存:Netty 默认使用堆外内存,避免 Java GC 影响
- 消息体压缩:对消息体使用 Snappy 或 LZ4 压缩,减少内存和带宽
- 连接数 × 单连接内存:100 万连接 × 10KB = 10GB 堆外内存,需合理配置 -XX:MaxDirectMemorySize
8.3 容量规划公式
峰值在线用户数 = DAU × 同时在线比例(通常 10-15%)
峰值消息 QPS = 峰值在线用户数 × 人均消息频率 × 峰值倍数(通常 2-3x)
单机承载连接数 = 50-80 万(取决于服务器配置和 Netty 调优)
网关节点数 = 峰值在线用户数 / 单机承载连接数 × 1.2(冗余系数)
带宽 = 峰值消息 QPS × 平均消息大小 × 8(bit)
九、故障处理与稳定性
9.1 常见故障与应对
| 故障场景 | 影响 | 应对策略 |
|---|---|---|
| 网关节点宕机 | 该节点所有用户断连 | 客户端自动重连到其他节点,Session 恢复 |
| 全部网关节不可用 | 所有用户断连 | 厂商通道兜底,告警升级 |
| Redis 不可用 | 在线状态/订阅关系丢失 | 网关本地缓存兜底,降级为广播模式 |
| Kafka 堆积 | 消息延迟增大 | 扩容消费者,降级非关键消息 |
| 消息风暴 | 推送延迟飙升 | 限流 + 优先级队列 + 丢弃低优先级消息 |
| 网络分区 | 部分用户无法连接 | 多机房部署,就近接入 |
9.2 监控告警体系
核心监控指标:
| 指标 | 告警阈值 | 严重程度 |
|---|---|---|
| 总连接数 | 下降 > 20%/5min | P1 |
| 长连接在线率 | < 90% | P2 |
| 消息推送延迟 P99 | > 500ms | P1 |
| 消息送达率 | < 99.9% | P0 |
| 长连接 ACK 超时率 | > 5% | P1 |
| 厂商通道到达率 | < 95% | P2 |
| 网关 CPU 使用率 | > 80% | P2 |
| 网关内存使用率 | > 85% | P1 |
| Kafka 消费延迟 | > 10000 条 | P2 |
9.3 灰度发布
推送系统的灰度发布需要特别小心,因为连接是有状态的:
- 比例切流:新版本先承载 1% → 5% → 20% → 100% 的流量
- 连接保持:已建立的连接不中断,新连接逐步切到新版本
- 回滚机制:发现问题后,新版本网关直接下线,已有连接断开后自动重连到旧版本
- 金丝雀观测:新版本上线后,对比新旧版本的核心指标(延迟、送达率、错误率),持续 30 分钟无异常再继续扩量
十、面试追问(面试官视角)
以下问题从面试官视角出发,考察候选人是否真正理解推送系统的设计权衡,而非死记硬背。
Q1:如果一台 WebSocket 网关宕机,上面的 50 万连接全部断开,50 万客户端同时重连,如何防止"重连风暴"打垮其他节点?
考察点:你是否考虑过灾难场景下的雪崩效应。
参考答案:
- 客户端重连必须加入随机退避(jitter):重连间隔 = base × 2^retry + random(0, 1000ms),而不是固定间隔
- 客户端 DNS 层面做就近接入 + 故障转移:宕机节点的域名解析指向其他可用节点
- 网关层做连接数限流:单节点达到连接数上限后拒绝新连接,客户端收到拒绝后自动换节点
- 服务端做渐进式恢复:新上线的节点逐步放开连接数限制,而不是一次性接受全部连接
Q2:你的系统有 1000 万在线用户,需要给所有人推送一条紧急通知,要求在 10 秒内完成。如何设计?
考察点:全量广播场景下的架构设计和性能优化。
参考答案:
- 不能逐条推送(1000 万 × 单次推送 1ms = 10000 秒)。需要并行推送:将用户分片,多协程/多线程并发推送
- 网关层做批量发送:同一网关节点上订阅同一 Topic 的用户,合并为一次广播
- 使用独立的专用通道:P0 全量推送不与普通消息共享通道,避免相互影响
- 预估:1000 个网关节点,每节点 1 万用户,每节点并发推送,延迟 < 1 秒
- 如果使用厂商通道(APNs/FCM 有 QPS 限制),需要提前申请提升配额
Q3:WebSocket 和 HTTP/2 的 Server Push 有什么区别?为什么实时推送通常选 WebSocket 而不是 HTTP/2 Push?
考察点:协议层面的深入理解,能否区分"能推送"和"适合推送"。
参考答案:
- HTTP/2 Server Push 是预加载机制,不是消息推送。它推送的是关联资源(如 CSS/JS),目的是减少客户端请求的往返时间
- HTTP/2 Push 的推送方向是服务端→客户端,但客户端无法主动发消息,是半双工
- HTTP/2 Push 的内容由服务端决定,客户端缺乏订阅/取消订阅的控制能力
- HTTP/2 Push 已被 Chrome 弃用(Chrome 106+ 不再支持),主要原因是使用率低、缓存机制复杂
- WebSocket 是全双工、双向、低开销的实时通信协议,专为实时推送设计
Q4:如何保证消息的严格顺序?比如用户 A 先发"你好"再发"再见",用户 B 收到的顺序不能颠倒。
考察点:分布式系统中顺序性的理解和工程权衡。
参考答案:
- 同一会话的消息路由到同一个 Kafka 分区(按会话 ID 哈希),保证分区内有序
- 消费者端单线程消费 + 单线程推送:同一会话的消息按顺序处理
- 接收端按序列号排序:维护一个
expected_seq,收到乱序消息时等待前面的消息到达 - 对于不需要严格顺序的 Topic(如系统通知),不过度设计,避免性能损失
- 关键权衡:顺序性 vs 吞吐量。严格顺序会限制并发度,在实际架构中,大部分场景只需要"分区有序"而非"全局有序"
Q5:你的系统如何检测"假在线"连接?即 TCP 连接还在但客户端实际已经无法接收消息(比如用户切到后台、网络切换)。
考察点:长连接状态管理的深度。
参考答案:
- 应用层心跳:定期发送 Ping,要求客户端回复 Pong。连续 3 次超时(各 30s)判定假死
- TCP Keep-Alive:操作系统层面检测,但默认间隔太长(2 小时),需调小到 60 秒
- 消息 ACK 超时:发送消息后长时间未收到 ACK,主动发送 Ping 探测
- 网络切换检测:移动端监听网络变化事件,WiFi → 4G 切换时主动断开旧连接、建立新连接
- 假死连接及时清理,释放网关资源,同时更新在线状态为离线
Q6:如果你的推送系统需要同时支持 Web、iOS、Android 三端,且 iOS 端 App 被杀后也要收到消息,你会怎么设计?
考察点:多端统一推送架构设计。
参考答案:
- Web 端:WebSocket 长连接为主,SSE 为降级方案
- Android 端:App 前台时 WebSocket 长连接,App 后台时走 FCM/厂商通道
- iOS 端:App 前台时 WebSocket 长连接,App 后台/被杀后走 APNs(VoIP Push 受限后,APNs 是唯一可靠的后台推送通道)
- 服务端统一推送接口,根据设备类型和在线状态自动选择推送通道
- 多端消息同步:同一用户的所有设备都能收到消息,通过
device_id区分设备 - 关键:消息体设计要兼容不同通道,APNs 只支持 JSON payload 且大小有限制(4KB),超长消息需要做裁剪或仅推送摘要
Q7:线上突然出现大量 WebSocket 连接断开又重连,推送延迟飙升到 5 秒以上。你如何排查?
考察点:线上故障排查的方法论和工具使用。
参考答案:
- 看监控:先看连接数、推送延迟、错误率、主机 CPU/内存/网络等基础指标,确认影响范围
- 定位时间点:找到异常开始的时间点,关联变更事件(发布、配置变更、网络变更)
- 分析网关日志:查看断开原因(心跳超时、主动关闭、网络错误),统计断开连接的分布
- 检查网络:是否是网络抖动导致大量心跳超时?检查丢包率、RTT
- 检查 GC:是否因 Full GC 导致 STW(Stop The World),大量连接心跳超时
- 检查 Kafka 消费:Kafka 消费是否堆积,消息是否积压
- 检查 Redis:Redis 响应是否变慢,影响在线状态查询
- 应急处理:如果是某台机器问题,先摘除流量;如果是全量问题,考虑扩容或回滚
Q8:假如你要设计一个"推送中台",同时服务 100 个业务线(IM、电商、直播、游戏等),每个业务线的推送需求不同。你如何设计隔离性?
考察点:多租户推送平台的架构设计。
参考答案:
- 物理隔离 + 逻辑隔离结合:核心 IM 业务独立集群,普通业务共享集群
- Topic 命名空间:每个业务线有独立的 Topic 前缀,如
im:message、shop:order、live:start - 资源配额:每个业务线配置 QPS 上限、存储上限、连接数上限
- 优先级保障:关键业务线(IM、支付)的消息优先级高于运营类推送
- 频控独立:每个业务线有独立的频控策略,互不影响
- 灰度发布:不同业务线可以独立升级,一个业务线的问题不影响其他业务线
- 监控分业务线:送达率、延迟、错误率等指标按业务线拆分,快速定位问题归属
本文覆盖了实时消息推送系统的核心设计要点:长连接技术选型、连接管理、订阅模型、分级推送、送达率保障、架构设计、性能优化和故障处理。推送系统看似简单——"不就是发个消息吗?"——但要做到千万级在线、毫秒级延迟、99.99% 送达率,需要深入理解网络协议、分布式系统和故障容错,在每一个环节都做好 trade-off。