考点 200|Java 技术专家 / 架构师面试高频考点 阅读时间:约 45 分钟
1. 问题定义:为什么需要 CQRS?
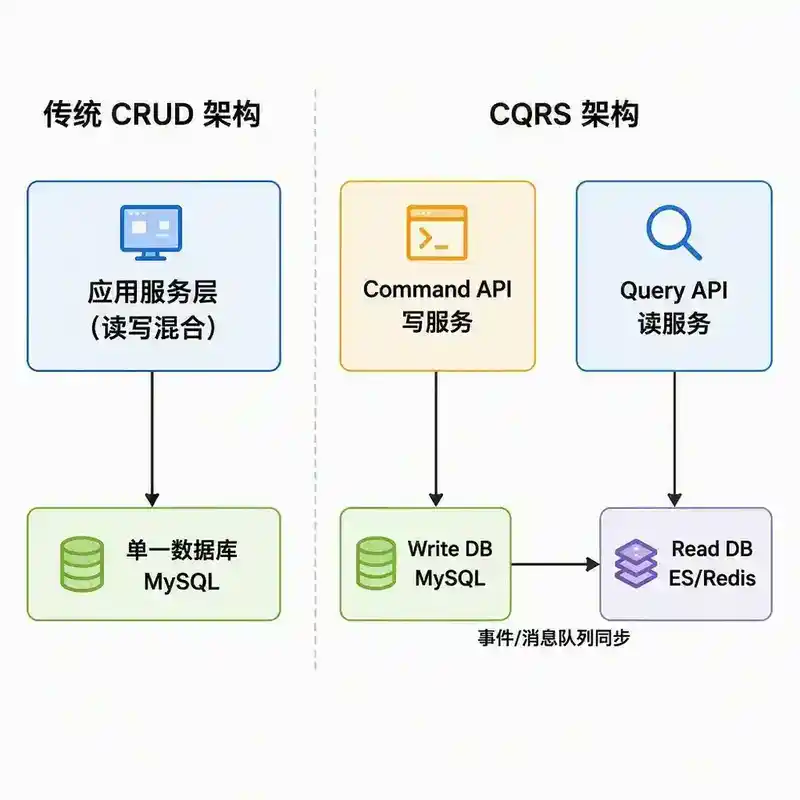
在一个典型的电商系统中,订单详情页既要展示订单的完整信息(商品、金额、物流、优惠券),又要处理用户的下单请求(扣库存、生成订单、扣款)。这两类操作对数据模型的要求截然不同:
- 写操作(Command):需要强一致性、完整的数据校验、业务规则验证,操作的是规范化的聚合数据。
- 读操作(Query):需要多表 JOIN、聚合计算、非规范化展示,追求的是响应速度和数据展示的灵活性。
传统的 CRUD 架构用一个统一的数据模型同时服务读和写,随着业务复杂度增长,这个模型会变得越来越臃肿——一面要满足写操作的规范化约束,一面又要支持读操作的各种 JOIN 和聚合。这种"一个模型服务所有场景"的设计,就是 CQRS 要解决的核心问题。
CQRS(Command Query Responsibility Segregation,命令查询职责分离) 是一种架构模式,它将系统的读操作和写操作分离到不同的模型中:命令模型负责处理写操作(增删改),查询模型负责处理读操作(查询)。两者使用不同的数据存储、不同的数据结构,甚至是不同的数据库。
核心思想:一个方法要么是执行命令(改变状态,不返回数据),要么是执行查询(返回数据,不改变状态),但不要两者兼做。
2. CQRS 的起源:CQS 原则
CQRS 并非凭空出现,它源于 Bertrand Meyer 在《面向对象软件构造》中提出的 CQS(Command-Query Separation) 原则:
- Command(命令):改变系统状态,不返回值(或返回 void/成功标识)。
- Query(查询):返回数据,不改变系统状态(无副作用)。
// CQS 原则示例
public interface OrderService {
    // Command:改变状态,返回 void
    void placeOrder(PlaceOrderCommand command);

    // Query:返回数据,无副作用
    OrderView getOrder(String orderId);
}
CQS 是方法级别的原则,而 CQRS 将这一原则扩展到架构级别:不仅方法分离,数据模型、数据存储、甚至服务都可以分离。
3. 核心架构:CQRS 的三种层次

CQRS 不是"全有或全无"的,可以根据实际需求选择不同的分离层次。
3.1 层次一:模型分离,共享数据库
这是最轻量级的 CQRS 实现。读写操作使用同一数据库,但使用不同的数据访问模型(ORM 映射层)。
┌──────────────┐     ┌──────────────┐
│  Command API  │     │   Query API  │
│  (写模型)      │     │  (读模型)     │
└──────┬───────┘     └──────┬───────┘
       │                    │
       ▼                    ▼
┌─────────────────────────────────────┐
│         共享数据库 (MySQL)           │
└─────────────────────────────────────┘
适用场景:业务复杂度中等,读写性能差异不大,希望降低代码耦合度。
Java 实现示例:
// 写模型:使用规范化的实体
@Entity
@Table(name = "orders")
public class Order {
    @Id
    private String orderId;
    private String userId;
    private OrderStatus status;
    private BigDecimal totalAmount;
    // 规范化字段,不含冗余
}

// 读模型:使用非规范化的 DTO / 视图
public class OrderDetailView {
    private String orderId;
    private String userName;      // 冗余:来自 user 表
    private String productName;   // 冗余:来自 product 表
    private BigDecimal totalAmount;
    private List<OrderItemView> items;
    // 专门为前端展示优化
}

// 读模型直接使用 SQL 视图或 JOIN 查询
@Repository
public class OrderQueryRepository {
    @Query("SELECT new com.example.view.OrderDetailView(" +
           "o.orderId, u.name, p.name, o.totalAmount) " +
           "FROM Order o JOIN User u ON o.userId = u.id " +
           "JOIN OrderItem oi ON o.orderId = oi.orderId " +
           "JOIN Product p ON oi.productId = p.id " +
           "WHERE o.orderId = :orderId")
    OrderDetailView findOrderDetail(@Param("orderId") String orderId);
}
3.2 层次二:模型分离 + 数据库分离
读写操作使用不同的数据库实例,甚至不同类型的数据库。写库使用 MySQL 保证事务一致性,读库使用 Elasticsearch 支持全文搜索,或使用 Redis 缓存热点数据。
┌──────────────┐     ┌──────────────┐
│  Command API  │     │   Query API  │
│  (写服务)      │     │  (读服务)     │
└──────┬───────┘     └──────┬───────┘
       │                    │
       ▼                    ▼
┌──────────────┐     ┌──────────────┐
│  Write DB    │────▶│  Read DB     │
│  (MySQL)     │ 同步 │  (ES/Redis)  │
└──────────────┘     └──────────────┘
适用场景:读写性能要求差异大,查询需要搜索、聚合等特殊能力。
3.3 层次三:CQRS + Event Sourcing

最完整的 CQRS 实现,结合事件溯源模式。命令产生事件,事件被持久化到事件存储中,查询模型通过消费事件来构建。
┌──────────────┐     ┌──────────────┐     ┌──────────────┐
│  Command API  │────▶│ Event Store  │────▶│  Event Bus   │
│  (写服务)      │     │  (事件存储)   │     │  (消息队列)   │
└──────────────┘     └──────────────┘     └──────┬───────┘
                                                 │
                    ┌────────────────────────────┘
                    ▼
            ┌──────────────┐
            │   Projector  │
            │  (事件投影器)  │
            └──────┬───────┘
                   │
                   ▼
            ┌──────────────┐     ┌──────────────┐
            │  Read DB     │◀────│   Query API  │
            │  (查询存储)   │     │  (读服务)     │
            └──────────────┘     └──────────────┘
4. 数据同步:读写模型的一致性保证
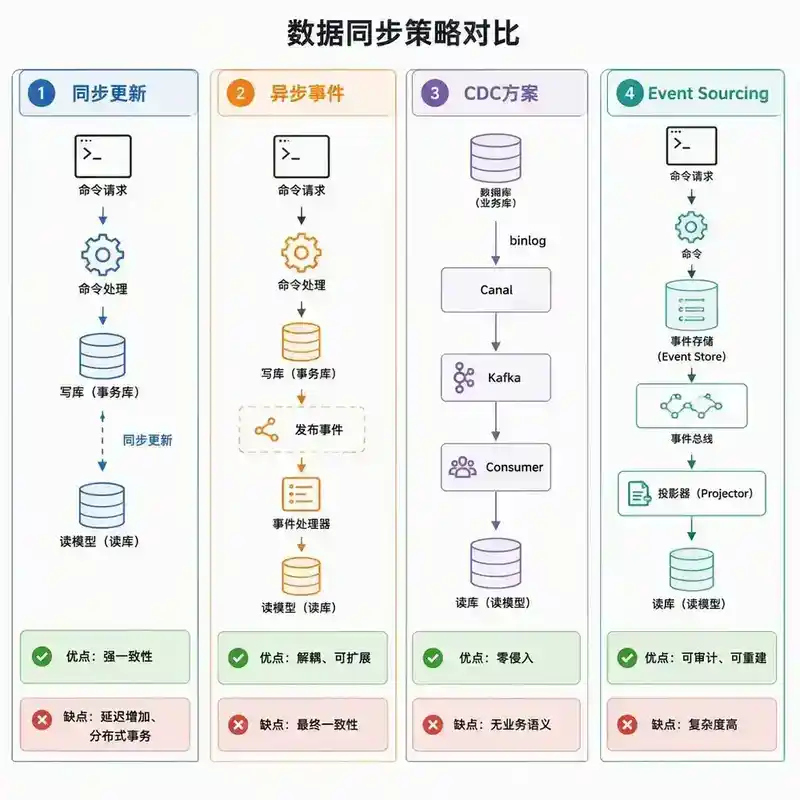
当读写模型分离到不同数据库时,核心挑战就是数据同步。以下是几种主流的同步策略。
4.1 同步更新(强一致性)
命令处理完成后,同步更新读模型。
@Transactional
public void placeOrder(PlaceOrderCommand command) {
    // 1. 写入命令模型(写库)
    Order order = orderRepository.save(command.toOrder());

    // 2. 同步更新查询模型(读库)
    OrderView view = OrderView.from(order);
    orderViewRepository.save(view);  // 写入 ES 或 Redis
}
优点:读模型实时一致。 缺点:
- 增加了写操作的延迟(写两个存储)
- 违反 CQRS 的"命令不返回数据"原则
- 如果读库写入失败,需要回滚写库,增加了分布式事务复杂度
- 耦合了命令和查询的处理逻辑
4.2 异步更新(最终一致性)——推荐方案
命令处理完成后,通过事件异步通知查询模型更新。
// 命令处理
@Transactional
public void placeOrder(PlaceOrderCommand command) {
    Order order = orderRepository.save(command.toOrder());
    // 发布领域事件
    eventPublisher.publish(new OrderPlacedEvent(order));
}

// 事件处理器:更新查询模型
@EventHandler
public void on(OrderPlacedEvent event) {
    OrderView view = OrderView.from(event.getOrder());
    orderViewRepository.save(view);
}
优点:
- 解耦命令和查询处理
- 写操作延迟不受读模型更新影响
- 可独立扩展
缺点:
- 存在短暂的数据不一致窗口
- 需要处理事件丢失、重复消费等问题
- 增加了系统复杂度
4.3 CDC(Change Data Capture)方案

不修改应用代码,通过数据库的变更捕获机制同步数据。
MySQL (Write DB) ──▶ binlog ──▶ Canal/Debezium ──▶ Kafka ──▶ Consumer ──▶ ES (Read DB)
优点:
- 对业务代码零侵入
- 可靠性高(binlog 是数据库层面的机制)
缺点:
- 对数据库有性能影响
- 只能捕获数据变更,无法捕获业务语义
- 当数据库表结构变更时需同步调整
4.4 同步策略选型建议
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 用户操作后立即查看自己的数据 | 同步更新 | 用户体验要求强一致 |
| 后台报表、统计分析 | 异步更新 | 可接受分钟级延迟 |
| 搜索索引、推荐数据 | CDC 或异步 | 对一致性要求低 |
| 审计日志、操作记录 | Event Sourcing | 不可变性是关键需求 |
5. 实现细节与最佳实践
5.1 命令模型设计
命令应该是不可变的、自描述的:
// 命令对象:不可变,包含完整的操作意图
@Value  // Lombok:不可变对象
public class PlaceOrderCommand {
    @NotBlank
    String userId;

    @NotEmpty
    List<OrderItemCommand> items;

    String couponCode;

    @Valid
    AddressCommand shippingAddress;
}

// 命令处理器:无返回值
public interface CommandHandler<C> {
    void handle(C command);
}

@Component
public class PlaceOrderHandler implements CommandHandler<PlaceOrderCommand> {

    private final OrderRepository orderRepository;
    private final InventoryService inventoryService;
    private final EventPublisher eventPublisher;

    @Override
    @Transactional
    public void handle(PlaceOrderCommand command) {
        // 1. 业务规则校验
        inventoryService.validate(command.getItems());

        // 2. 创建聚合根
        Order order = Order.create(command);

        // 3. 持久化
        orderRepository.save(order);

        // 4. 发布领域事件
        eventPublisher.publish(order.getDomainEvents());
    }
}
5.2 查询模型设计
查询模型应该为特定查询场景优化,允许数据冗余:
// 不同的查询场景,使用不同的视图模型
public class OrderListView {        // 订单列表页
    private String orderId;
    private String productImage;    // 冗余:首张商品图
    private String productName;     // 冗余:首件商品名
    private String orderStatus;     // 冗余:状态文本
    private BigDecimal totalAmount;
    private LocalDateTime createdTime;
}

public class OrderDetailView {      // 订单详情页
    private String orderId;
    private String userName;
    private String userPhone;
    private AddressView shippingAddress;
    private List<OrderItemDetail> items;  // 含商品图片、规格
    private PaymentInfoView paymentInfo;
    private LogisticsView logistics;       // 物流轨迹
    private List<OrderEventView> timeline; // 操作时间线
}
5.3 命令总线和中介者模式
在复杂系统中,可以引入命令总线来解耦命令发送者和处理器:
// 命令总线接口
public interface CommandBus {
    <C> void dispatch(C command);
}

// Spring 实现
@Component
public class SpringCommandBus implements CommandBus {

    private final Map<Class<?>, CommandHandler<?>> handlers;

    public SpringCommandBus(List<CommandHandler<?>> handlerList) {
        this.handlers = handlerList.stream()
            .collect(Collectors.toMap(
                h -> resolveCommandType(h.getClass()),
                h -> h
            ));
    }

    @Override
    @SuppressWarnings("unchecked")
    public <C> void dispatch(C command) {
        CommandHandler<C> handler = (CommandHandler<C>)
            handlers.get(command.getClass());
        if (handler == null) {
            throw new NoHandlerException(command.getClass());
        }
        handler.handle(command);
    }
}

// 使用
@RestController
public class OrderController {
    @Autowired
    private CommandBus commandBus;

    @PostMapping("/orders")
    public ResponseEntity<Void> placeOrder(@Valid @RequestBody PlaceOrderCommand command) {
        commandBus.dispatch(command);
        return ResponseEntity.accepted().build();  // 返回 202 Accepted
    }
}
6. CQRS 与 Event Sourcing 的关系
CQRS 和 Event Sourcing(事件溯源)经常被一起提及,但它们是两个独立的概念:
- CQRS:关注读写模型的分离
- Event Sourcing:关注状态的存储方式——用事件序列代替当前状态快照
它们为什么经常搭配使用?
- 事件溯源天然要求"写事件"和"读投影"分离,与 CQRS 的读写分离理念一致
- 事件存储不适合直接查询,必须构建查询投影
- CQRS 为 Event Sourcing 提供了自然的多投影支持
// Event Sourcing 中的聚合根
public class Order extends EventSourcedAggregate {
    private String orderId;
    private OrderStatus status;

    // 命令:不直接修改状态,而是产生事件
    public void place(PlaceOrderCommand cmd) {
        apply(new OrderPlacedEvent(cmd.getUserId(), cmd.getItems()));
    }

    public void cancel(CancelOrderCommand cmd) {
        if (status != OrderStatus.PAID) {
            throw new IllegalStateException("只有已支付订单可取消");
        }
        apply(new OrderCancelledEvent(cmd.getReason()));
    }

    // 事件应用:重建状态
    private void on(OrderPlacedEvent event) {
        this.orderId = event.getOrderId();
        this.status = OrderStatus.PLACED;
    }

    private void on(OrderCancelledEvent event) {
        this.status = OrderStatus.CANCELLED;
    }
}
注意:CQRS 不需要 Event Sourcing,Event Sourcing 也不需要 CQRS。但两者结合使用,能发挥出最大的架构价值。
7. 复杂度分析:CQRS 的代价
CQRS 不是银弹。在决定采用 CQRS 之前,需要清醒地认识到它引入的复杂度。
7.1 开发复杂度
| 维度 | 传统 CRUD | CQRS |
|---|---|---|
| 模型数量 | 1 个领域模型 | 2+ 个模型(命令模型 + N 个查询模型) |
| 代码量 | 基准 | 增加 50%-200% |
| 新增查询场景 | 加一个接口 | 可能需要新建一个视图模型和同步逻辑 |
| 调试难度 | 低 | 高(数据流经多个组件) |
7.2 运维复杂度
- 数据一致性监控:需要额外的监控和告警来判断读写模型是否一致
- 数据修复工具:当读模型数据损坏时,需要重放事件的工具
- 存储成本:多个数据库实例 + 消息队列,基础设施成本增加
- 部署复杂度:多个独立服务或模块,需要协调部署
7.3 一致性权衡
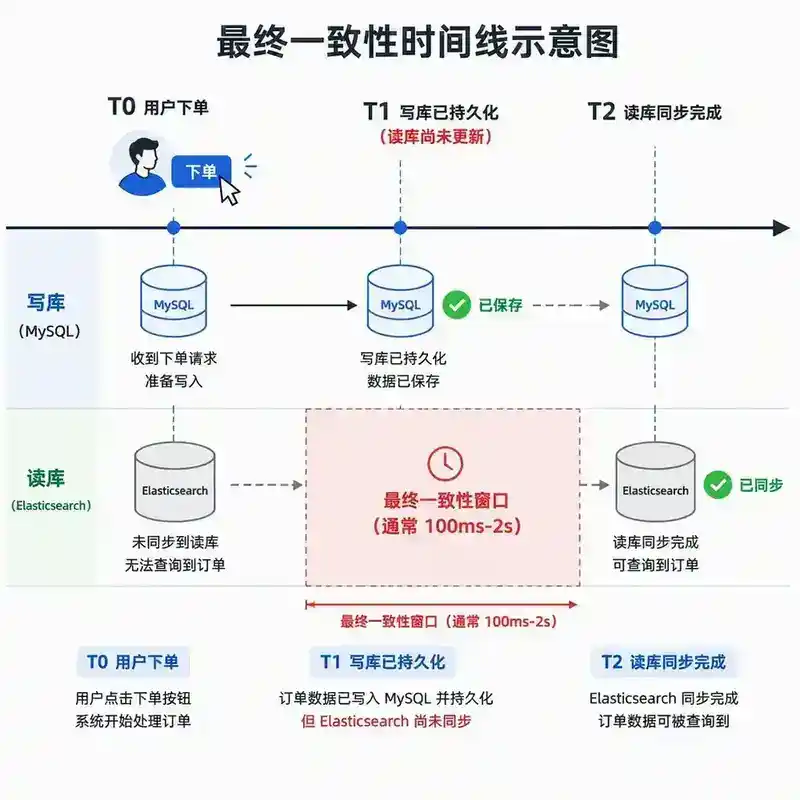
CQRS 带来了最终一致性,这是架构层面最需要理解的一点:
时间线:
T0: 用户下单 ──▶ 写库已保存
T1: 用户查看订单列表 ──▶ 读库可能还没有(数据不一致窗口)
T2: 事件消费完成 ──▶ 读库已更新
应对策略:
- 对用户自己的操作,可以走"读己之写"(read-your-writes)策略
- 前端在提交后,直接使用请求返回的数据渲染,不等读库
- 对非关键数据,通过 UI 提示"数据更新中"
8. 适用场景判断
8.1 适合使用 CQRS 的场景
- 读写负载差异大:例如电商的商品详情页(读多写少)和订单系统(读写均衡),需要独立扩缩容
- 查询需求复杂多变:需要多维度搜索、聚合、报表,传统 ORM 难以满足
- 读写模型天然不同:写操作需要事务保证,读操作需要高性能的 KV 存储或搜索引擎
- 领域复杂度高:DDD 聚合根设计复杂,查询模型需要跨越多个聚合边界
- 有 Event Sourcing 需求:需要完整的审计日志、时间旅行查询、状态重建
8.2 不适合使用 CQRS 的场景
- 简单的 CRUD 应用:数据模型简单,读写需求差别不大
- 团队经验不足:CQRS 的学习曲线陡峭,团队需要理解最终一致性、事件驱动等概念
- 数据一致性要求极高:无法接受任何时间窗口的数据不一致
- 项目处于早期阶段:业务模型尚未稳定,过早引入 CQRS 会过度设计
8.3 决策框架
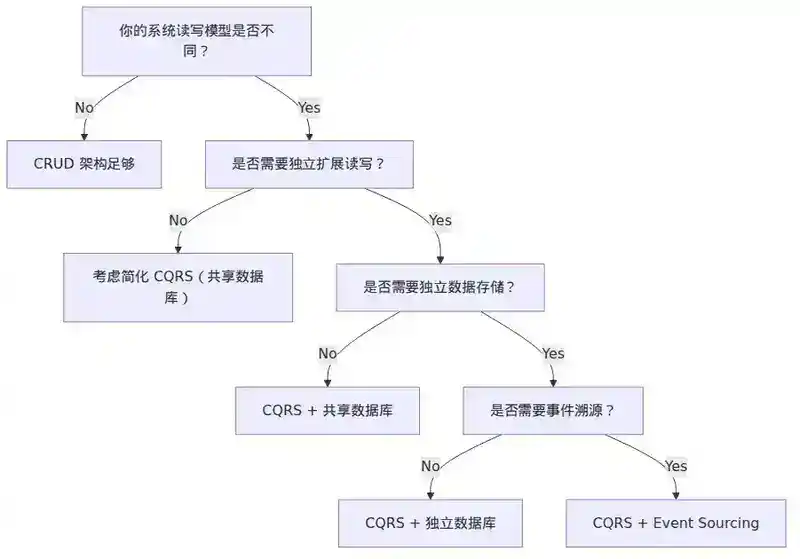
是否需要 CQRS?
    │
    ├── 读写模型是否天然不同? ── 否 ──▶ 使用传统 CRUD
    │   是
    ├── 是否需要独立扩展读写能力? ── 否 ──▶ 使用"层次一"(仅模型分离)
    │   是
    ├── 是否需要 Event Sourcing? ── 是 ──▶ 使用"层次三"(CQRS + ES)
    │   否
    └── 使用"层次二"(模型 + 数据库分离)
9. 生产实践案例
9.1 案例一:电商订单系统
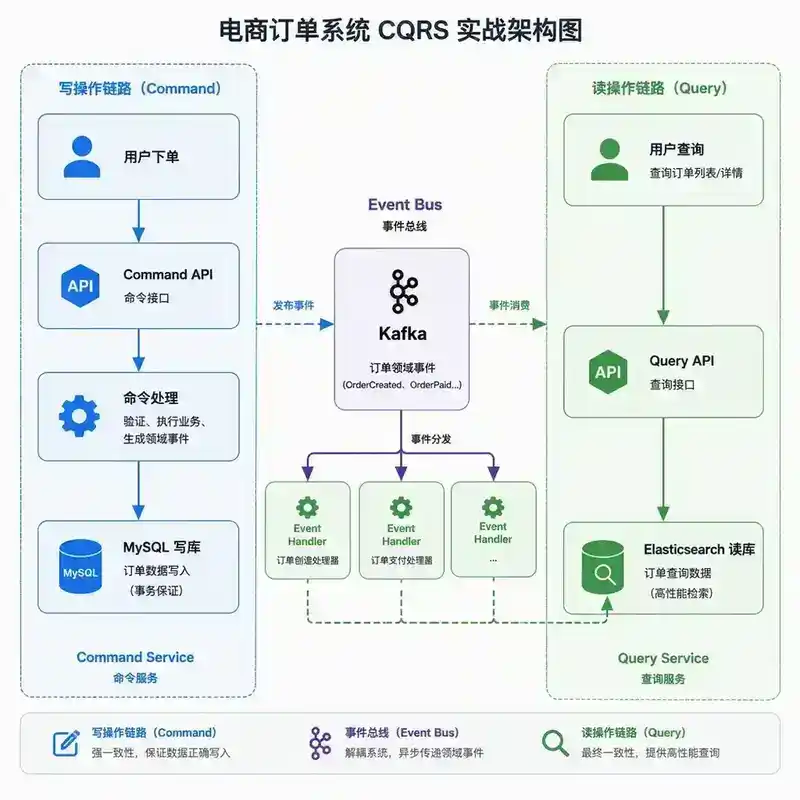
背景:某电商平台订单量日均百万级,订单详情页需要展示订单、商品、支付、物流等跨服务信息。
CQRS 设计:
- 写模型:MySQL,订单聚合根 + 事务保证
- 读模型:Elasticsearch,订单宽表(将订单、用户、商品、物流信息打平)
- 同步方式:订单服务发布 OrderPlaced / OrderPaid / OrderShipped 等事件,订单查询服务消费事件更新 ES
效果:
- 订单详情页查询从 200ms 降至 10ms(ES 宽表查询)
- 订单服务无需依赖用户、商品、物流服务完成查询
- 大促期间,查询服务可独立扩容(ES 集群),不影响下单链路
9.2 案例二:银行交易系统
背景:某银行核心交易系统,需要同时支持实时交易处理和复杂的对账报表。
CQRS 设计:
- 写模型:Oracle,事务处理,强一致性保证
- 读模型:HBase + Hive,交易流水宽表,支持批量对账和报表
- 同步方式:CDC(Oracle GoldenGate → Kafka → HBase)
效果:
- 交易处理不受报表查询影响
- 对账系统可独立运行,不影响核心交易链路
- 合规审计通过 Event Sourcing 实现不可篡改的交易记录
10. 常见陷阱与避坑指南
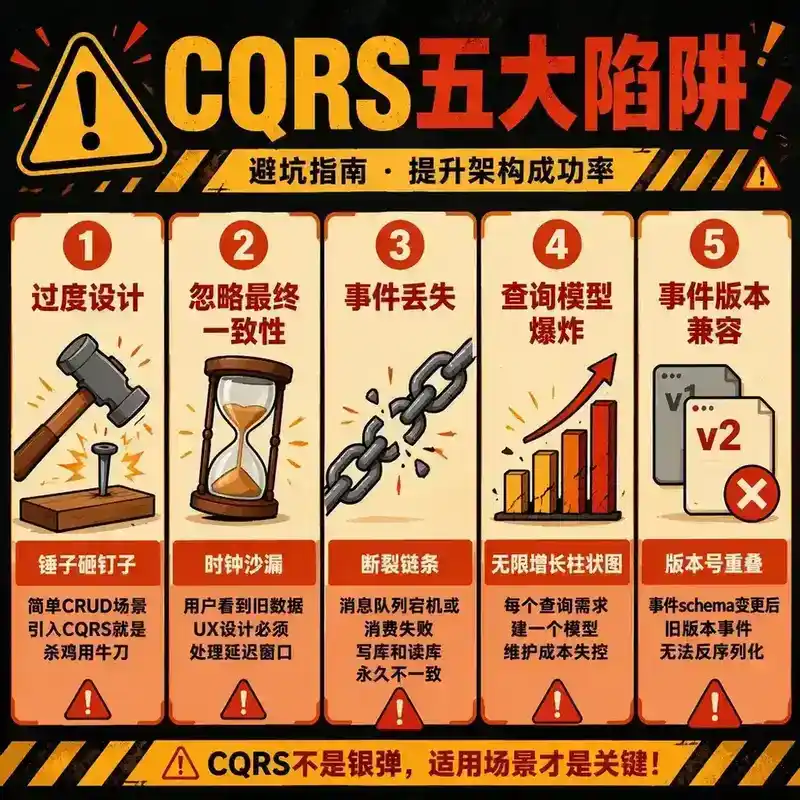
陷阱 1:过度设计
问题:在一个简单的 CMS 系统中引入 CQRS + Event Sourcing,导致 90% 的代码在维护基础设施。 解决:从最简单的 CRUD 开始,当确实遇到读写模型冲突时,再局部引入 CQRS。
陷阱 2:忽略最终一致性的影响
问题:用户下单后刷新页面看不到订单,打电话投诉。 解决:
- 前端提交后乐观更新
- 写操作返回后前端直接渲染(不依赖读库)
- 对关键操作使用同步更新
陷阱 3:事件丢失导致数据永久不一致
问题:消息队列故障导致读模型更新事件丢失,订单详情页永远看不到该订单。 解决:
- 使用消息队列的持久化 + 确认机制
- 实现定期对账,发现差异后重放事件
- 读模型数据可重建(Event Sourcing 天然支持)
陷阱 4:查询模型爆炸
问题:每个前端页面都建一个视图模型,导致 50+ 个视图表。 解决:
- 合并相似查询场景,使用参数化视图
- 使用 GraphQL 让前端灵活组合查询字段
- 对低频查询,回退到直接查询写库
陷阱 5:事件版本兼容
问题:事件格式变更后,旧的投影器无法消费新事件。 解决:
- 事件 Schema 向前兼容(只增字段,不删不改)
- 使用 Avro/Protobuf 的 Schema 演化机制
- 投影器支持多版本事件处理
11. 总结
CQRS 的核心价值在于将复杂的读写场景解耦,让命令处理和查询处理各自使用最优的数据模型和存储方案。它不是一个简单的技术选型,而是一种架构思维方式的转变——从"围绕数据设计"转向"围绕行为设计"。
核心要点回顾:
- CQRS 将读和写分离到不同的模型和存储中
- 数据同步是 CQRS 的核心挑战,异步事件驱动是推荐方案
- CQRS 不是全有或全无,可以根据需求选择不同层次
- CQRS 和 Event Sourcing 是独立但互补的两种模式
- 最终一致性是 CQRS 的固有特性,需要从前端到后端全面考虑
- 不要在简单的场景中引入 CQRS,过度设计比不设计更危险
面试官视角:提问与回答
以下问题从面试官视角出发,考察候选人对 CQRS 的深度理解,不仅是概念复述。
Q1:CQRS 和传统的读写分离(主从复制)有什么区别?
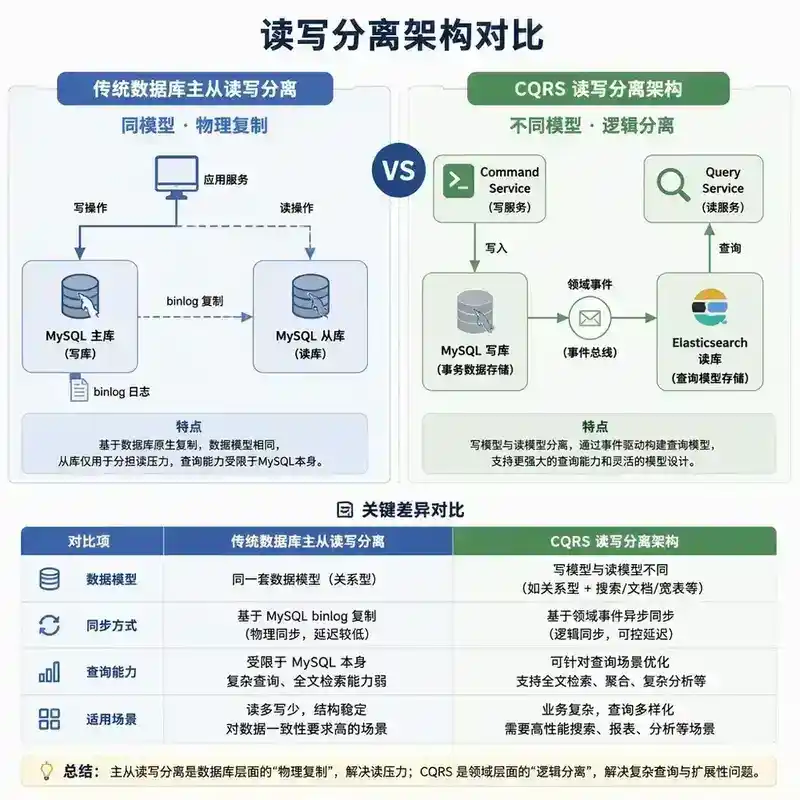
面试官关注点:是否理解两种"读写分离"的本质差异。
CQRS 的读写分离和数据库主从的读写分离是两个不同层面的概念:
- 数据库主从读写分离:物理层面,主库和从库使用相同的数据模型(同一套表结构),主库处理写,从库处理读,数据通过 binlog 复制。本质是同一模型的物理复制。
- CQRS 读写分离:逻辑层面,命令模型和查询模型使用不同的数据结构,可能是不同的表、不同的数据库类型。写库存规范化数据,读库存宽表/文档/索引。本质是不同模型的逻辑分离。
一个系统可以同时使用这两种分离:主从复制解决读写负载问题,CQRS 解决读写模型不匹配问题。
Q2:CQRS 项目中,如何保证"用户下单后立即看到自己的订单"?
面试官关注点:是否理解最终一致性的工程处理。
这是一个经典的"读己之写"(read-your-writes)问题。有几种处理策略:
- 前端乐观更新:提交订单后,前端直接用请求体中的数据渲染订单详情,不等待读库同步。这是成本最低的方案。
- 写操作返回完整视图:虽然违反纯粹的 CQRS(命令不返回数据),但在用户体验关键场景下,可以让写操作同步返回查询结果。这实际上是一种"实用主义 CQRS"。
- 用户维度的同步更新:对当前用户的操作走同步更新路径,对其他用户(如商家后台)走异步。通过在读库上标记"该用户数据已同步"来实现。
- Wait-for-sync 模式:命令返回后,客户端轮询查询接口,直到查询到新数据为止(超时后提示用户)。
实际项目中,通常组合使用策略 1 + 4。
Q3:什么时候不该用 CQRS?请举一个你实际遇到过的反例。
面试官关注点:是否有真实项目经验,能否识别过度设计。
一个典型的反例:我曾经接手过一个内部管理系统,开发团队在项目初期就引入了完整的 CQRS + Event Sourcing + DDD 架构。这个系统只有 20 张表、日均千次请求,核心功能是 CRUD 表单。
结果:
- 一个简单的"修改用户信息"功能,需要经过 Command → Aggregate → Event → Projector → View 五个环节
- 新增一个字段,需要在 Command、Event、View、Projector 四个地方修改
- 开发效率极低,新人上手需要 2 周
- 线上排查问题需要追踪 3 个服务 + 1 个消息队列
最终团队推倒重来,回归 Spring Boot + MyBatis 的简单架构,开发效率提升 5 倍。
教训:CQRS 应该在业务复杂度达到一定阈值后再引入,而不是作为默认架构。判断标准:当你的单个 CRUD 接口因为模型复杂度而难以维护时,才是考虑 CQRS 的时机。
Q4:CQRS 的查询模型如何应对"查询需求频繁变化"的问题?
面试官关注点:是否理解查询模型的演进策略。
几种应对策略:
- 物化视图 + 版本管理:每个查询模型有版本号,投影器可以同时维护多个版本的视图,前端按需切换。
- 宽表 + 前端过滤:查询模型存储比当前需求更多的字段(宽表),新需求只需前端调整过滤/展示逻辑,无需后端改动。
- GraphQL 作为查询层:读模型不直接暴露 REST 接口,而是通过 GraphQL 让前端按需组合字段。当查询需求变化时,只需调整 GraphQL 查询语句。
- CQRS 的极限:去读模型:对于极度灵活的场景(如 BI 分析),可以放弃预构建读模型,直接查询数据湖或 OLAP 引擎(如 ClickHouse),用计算能力换取灵活性。
Q5:在微服务架构中,CQRS 的查询模型需要跨多个服务的数据,如何设计?
面试官关注点:是否理解 CQRS 在分布式环境下的挑战。
跨服务查询模型的设计有几种模式:
- 组合式查询服务(API Composition):查询服务不存储数据,而是实时调用多个下游服务聚合数据。适合数据量小、下游服务响应快的场景。
- CQRS 查询服务订阅多个服务的事件:查询服务订阅所有相关服务发布的领域事件,构建本地宽表。查询时直接查本地,不依赖下游。这是最纯粹的 CQRS 方式,但维护成本高。
- 数据网格(Data Mesh):每个服务负责提供自己的查询数据接口,由一个"查询编排层"聚合。查询模型不集中到一个服务,而是分布式管理。
- BFF(Backend for Frontend):每个前端有自己的 BFF 层,BFF 负责聚合多个服务的数据。这不是严格的 CQRS,但能解决跨服务查询问题。
实际项目中,组合使用模式 2(核心高频数据)和模式 4(低频/个性化数据)最为常见。
延伸阅读:
本文为「Java 技术专家与架构师面试:250 个高频考点」系列第 200 篇
下一考点预告:201|事件溯源 Event Sourcing:事件存储、状态重建、快照和审计