一、短链接系统概述
1.1 什么是短链接
短链接(Short URL)是将一个冗长的原始 URL 映射为一个更短的字符串,并通过短链服务完成重定向跳转。典型的短链接如 https://t.cn/A6xYz9Qk,其中 A6xYz9Qk 即为短码(short code),对应的原始链接可能是数百字符的带参数 URL。
短链接的本质是"映射 + 重定向"——维护一个 key-value 映射关系,key 是短码,value 是原始 URL,用户访问短链时服务端查表获取原始 URL 并返回 301/302 重定向。
1.2 核心价值
| 价值维度 | 说明 |
|---|---|
| 节省空间 | 短信、微博等有字符限制的场景,长链接占用大量空间 |
| 美观简洁 | 二维码中嵌入短链比长链更稀疏、识别率更高 |
| 可追踪 | 在原始链接上附加统计参数,实现点击监控 |
| 可管理 | 短链可设置过期时间、访问密码、权限控制 |
| 品牌化 | 使用自有域名(如 t.yourcompany.com)增强品牌认知 |
1.3 核心能力矩阵
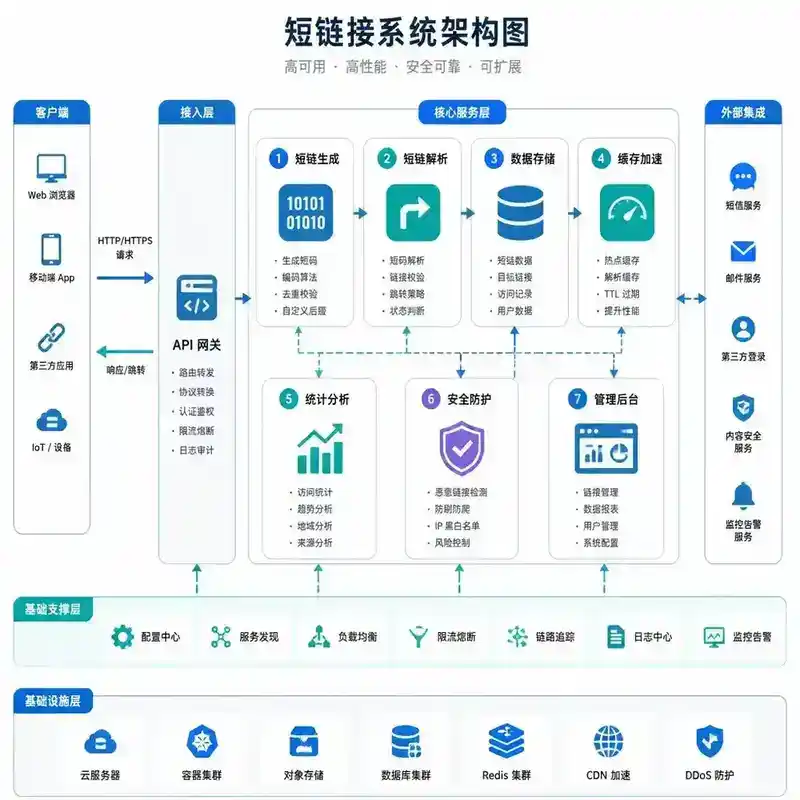
一个完整的短链接系统需要具备以下核心能力:
- 生成:将长 URL 转换为全局唯一的短码
- 解析:根据短码快速查找原始 URL 并重定向
- 存储:持久化映射关系,支持海量数据
- 缓存:高频访问的短链需要多级缓存加速
- 统计:记录和聚合访问数据,提供分析能力
- 安全:防止恶意链接、控制访问频率
- 管理:短链的创建、更新、删除、过期控制
二、编码算法:从长到短的转换
短链接系统的核心挑战之一是如何将任意长度的 URL 映射为一个短且唯一的字符串。主流方案分为两大类:哈希算法和自增 ID 编码。
2.1 哈希算法方案
基本原理
对原始 URL 计算哈希值(如 MD5、SHA-1、MurmurHash),然后截取前 N 位作为短码。MD5 输出 128 位(32 个十六进制字符),SHA-1 输出 160 位(40 个十六进制字符)。
long_url = "https://example.com/very/long/path?param1=value1¶m2=value2"
hash_value = MD5(long_url) # → "e4d909c290d0fb1ca068ffaddf22cbd0"
short_code = hash_value[:7] # → "e4d909c"
字符集扩展
直接使用十六进制字符(0-9a-f)效率较低。改用 Base62(0-9a-zA-Z,共 62 个字符)可以在相同长度下表达更多组合:
- 7 位十六进制:16^7 ≈ 2.68 亿
- 7 位 Base62:62^7 ≈ 3.52 万亿
优缺点分析
| 优点 | 缺点 |
|---|---|
| 实现简单,无需全局发号器 | 存在哈希冲突(不同 URL 可能产生相同短码) |
| 相同 URL 始终生成相同短码(幂等) | 需要额外的冲突处理逻辑 |
| 短码长度固定 | 7 位以上才有足够容量,不够"短" |
2.2 自增 ID + Base62 编码
这是业界最主流的方案,也是 TinyURL、Bitly 等系统的核心思路。
核心流程
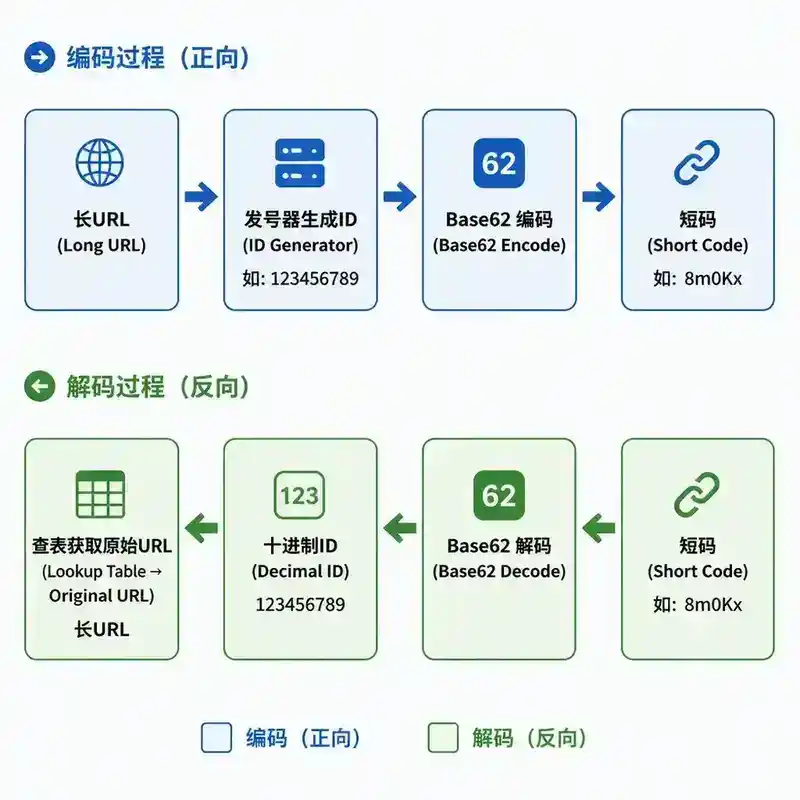
1. 全局发号器生成唯一递增 ID → 例如 123456789
2. 将十进制 ID 转换为 62 进制 → 得到 "8m0Kx"
3. 短码 = Base62 编码结果
4. 存储:short_code → long_url 映射
Base62 编码算法
public class Base62Encoder {
    private static final String CHARS =
        "0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz";

    // 十进制 → Base62
    public static String encode(long id) {
        StringBuilder sb = new StringBuilder();
        while (id > 0) {
            sb.append(CHARS.charAt((int)(id % 62)));
            id /= 62;
        }
        return sb.reverse().toString();
    }

    // Base62 → 十进制
    public static long decode(String code) {
        long result = 0;
        for (char c : code.toCharArray()) {
            result = result * 62 + CHARS.indexOf(c);
        }
        return result;
    }
}
关键点:encode 是可逆的,这意味着从短码可以直接反算出 ID,无需额外存储短码到 ID 的映射。这是自增 ID 方案相比哈希方案的重要优势。
短码长度与容量
| 短码长度 | Base62 组合数 | 可服务量级 |
|---|---|---|
| 5 位 | 62^5 ≈ 9.16 亿 | 亿级 |
| 6 位 | 62^6 ≈ 568 亿 | 百亿级 |
| 7 位 | 62^7 ≈ 3.5 万亿 | 万亿级 |
| 8 位 | 62^8 ≈ 218 万亿 | 千万亿级 |
建议:生产环境使用 7 位短码,兼顾简洁性和容量(3.5 万亿足够支撑绝大多数业务)。
2.3 分布式 ID 生成方案
自增 ID 方案的最大挑战在于:分布式环境下,如何生成全局唯一的递增 ID?
方案一:UUID
UUID.randomUUID() → "550e8400-e29b-41d4-a716-446655440000"
不推荐:UUID 是无序的 128 位值,作为主键会导致 B+ 树频繁分裂,写入性能极差。而且 128 位转换为 Base62 后仍有约 22 位字符,不够短。
方案二:雪花算法(Snowflake)
Twitter 开源的分布式 ID 生成算法,生成 64 位长整型:
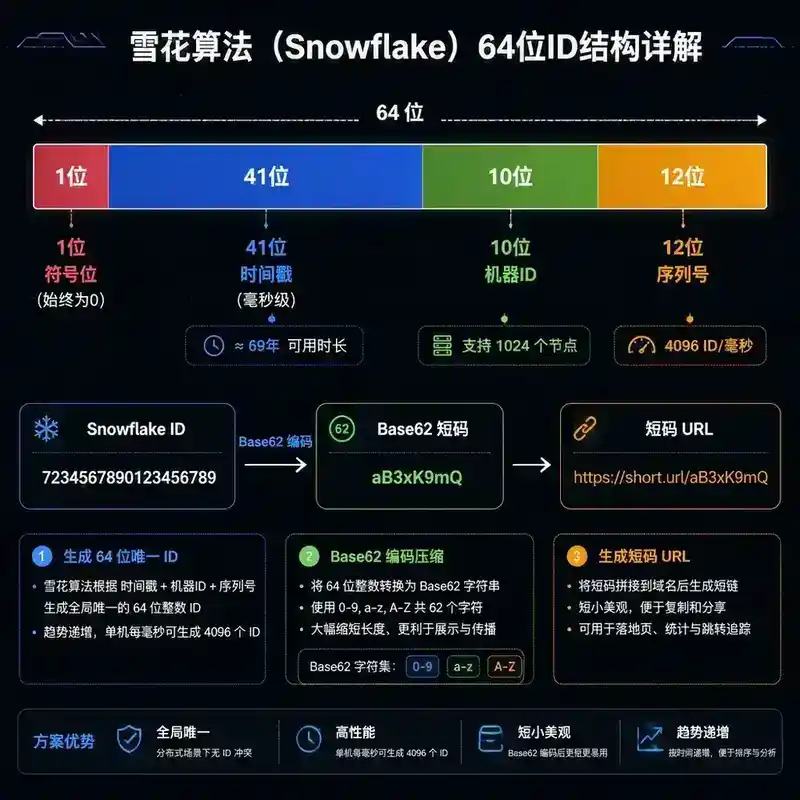
| 1bit 符号位 | 41bit 时间戳(ms) | 10bit 机器ID | 12bit 序列号 |
- 41 位时间戳可支撑约 69 年
- 10 位机器 ID 支持 1024 个节点
- 12 位序列号支持每毫秒 4096 个 ID
优点:趋势递增、高性能、纯内存计算 缺点:依赖机器时钟,时钟回拨会导致 ID 重复
时钟回拨解决方案:
- 等待时钟追上(简单粗暴)
- 使用备用 worker ID
- 扩展位(牺牲序列号位给时钟回拨计数器)
- 引入外部协调服务(ZooKeeper/etcd)
方案三:号段模式(美团 Leaf-segment)
// 从数据库批量获取号段
UPDATE leaf_alloc SET max_id = max_id + step WHERE biz_tag = 'short_url'
// 返回 [max_id - step + 1, max_id] 的号段
- 每个节点预取一个号段(如 step=1000),本地分配
- 号段用完再取下一段
- 即使数据库短暂不可用,本地缓存的号段可继续服务
优点:即使数据库宕机,已取号段仍可用;ID 连续递增 缺点:号段用完后需要数据库交互,存在短暂延迟
双 Buffer 优化:当号段消耗到 10% 时,异步预取下一个号段,保证号段耗尽前新号段已就绪。
方案四:Redis 自增
# 单机 Redis
short_id = redis.incr("short_url:id:counter")

# Redis Cluster(使用 Lua 脚本保证原子性)
# 每个分片独立维护计数器
优点:实现简单,Redis 单线程天然原子性 缺点:Redis 持久化可能丢失部分 ID;Redis Cluster 下需要分片策略
2.4 方案对比与选型
| 维度 | 哈希截取 | 自增+Base62 | 雪花算法 | 号段模式 |
|---|---|---|---|---|
| 实现复杂度 | 低 | 中 | 中 | 中 |
| 冲突概率 | 有(需处理) | 无 | 无 | 无 |
| 短码长度 | 固定(较长) | 随 ID 增长 | 固定(Base62 编码后) | 固定(Base62 编码后) |
| 分布式支持 | 天然支持 | 需额外设计 | 天然支持 | 需数据库 |
| 性能 | 低(哈希计算) | 高 | 极高 | 高 |
| 短码可逆 | 否 | 是 | 是 | 是 |
推荐方案:雪花算法 + Base62 编码。兼顾高性能、水平扩展和短码可逆性。
三、冲突处理策略
3.1 冲突的来源
在哈希算法方案中,不同 URL 可能产生相同的哈希短码,导致冲突。在自增 ID 方案中,如果 ID 生成器出现时钟回拨或配置错误,也可能产生重复 ID。
冲突的本质:短码空间有限(如 7 位 Base62),而长 URL 空间无限,必然存在碰撞。
3.2 再哈希法
当检测到冲突时,对原始 URL 进行微小变形后重新哈希:
short_code = hash(url)
while (exists_in_db(short_code)):
    short_code = hash(url + salt)       // 方案1:加盐重试
    short_code = hash(short_code + url)  // 方案2:链式哈希
    short_code = hash(url) + counter     // 方案3:附加计数器
问题:随着数据量增长,冲突概率增加,重试次数增多,生成性能下降。
3.3 布隆过滤器预判
使用布隆过滤器快速判断短码是否已存在,避免每次都查询数据库:
if (bloom_filter.might_contain(short_code)):
    // 可能存在,查询数据库确认
    if (db.exists(short_code)):
        // 确实冲突,重新生成
        short_code = generate_new()
else:
    // 一定不存在,直接使用
    insert_db(short_code, long_url)
布隆过滤器可以减少 90% 以上的无效数据库查询,但需要额外维护布隆过滤器的数据一致性。
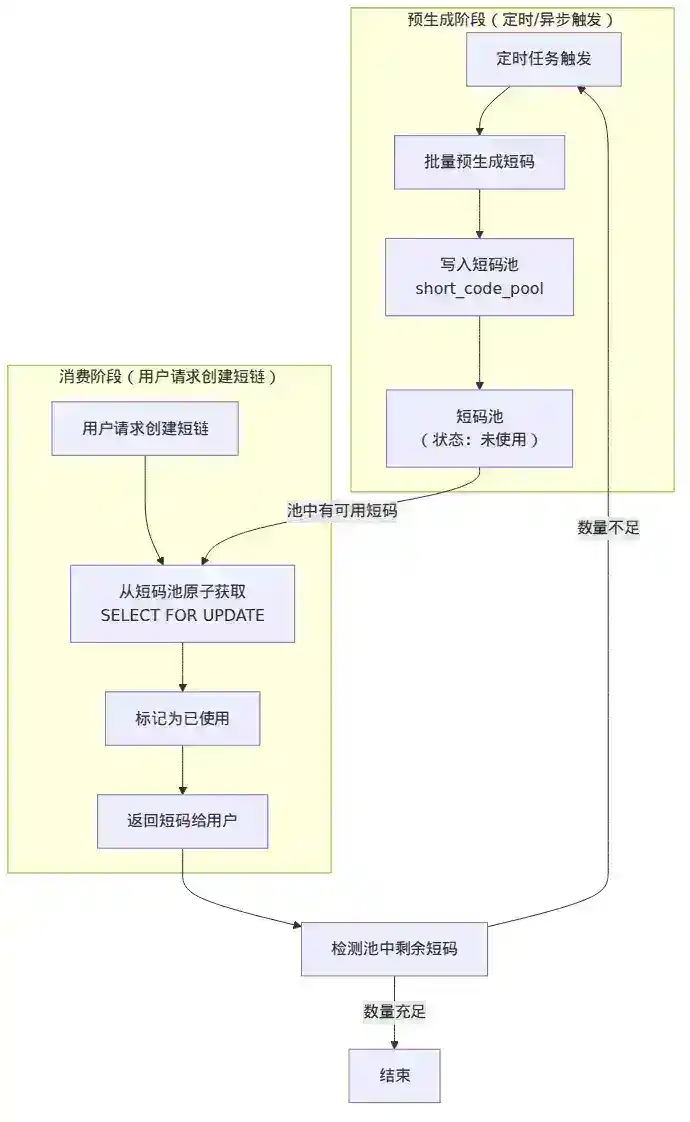
3.4 预生成 + 号段分配
这是彻底避免冲突的方案,也是生产环境推荐的做法:
1. 离线批量生成短码(如预生成 100 万个),通过唯一索引保证不重复
2. 将短码写入"短码池"(short_code_pool 表)
3. 创建短链时,从池中取一个未使用的短码(SELECT ... FOR UPDATE)
4. 使用后标记为已用
5. 异步补充池中短码
-- 短码池表结构
CREATE TABLE short_code_pool (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    short_code VARCHAR(8) NOT NULL,
    status TINYINT DEFAULT 0,  -- 0:未使用, 1:已使用
    used_at DATETIME,
    UNIQUE KEY uk_code (short_code),
    KEY idx_status (status)
);

-- 原子获取一个未使用短码
START TRANSACTION;
SELECT short_code FROM short_code_pool
WHERE status = 0 LIMIT 1 FOR UPDATE;
UPDATE short_code_pool SET status = 1, used_at = NOW()
WHERE short_code = ?;
COMMIT;
3.5 分布式环境下的冲突处理
在分布式短链生成场景中,冲突处理面临额外挑战:
乐观重试:多个节点同时生成短码,插入数据库时通过唯一索引检测冲突,冲突则重试。适合冲突率低的场景。
预占机制:每个节点预分配一段短码范围(如节点 A 使用 0-999,节点 B 使用 1000-1999),避免跨节点冲突。
一致性哈希路由:根据原始 URL 的哈希值,将请求路由到固定节点,同一 URL 始终由同一节点处理,天然避免跨节点冲突。
四、存储架构设计
4.1 数据模型设计
核心映射表
CREATE TABLE short_url_mapping (
    id BIGINT PRIMARY KEY,
    short_code VARCHAR(8) NOT NULL,
    original_url VARCHAR(2048) NOT NULL,
    expire_at DATETIME,
    creator_id BIGINT,
    status TINYINT DEFAULT 1,  -- 1:有效, 0:无效
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP,
    updated_at DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
    UNIQUE KEY uk_short_code (short_code),
    KEY idx_expire_at (expire_at),
    KEY idx_creator (creator_id)
);
访问日志表
CREATE TABLE access_log (
    id BIGINT PRIMARY KEY,
    short_code VARCHAR(8) NOT NULL,
    access_time DATETIME NOT NULL,
    ip VARCHAR(45),
    user_agent VARCHAR(512),
    referer VARCHAR(2048),
    country VARCHAR(64),
    city VARCHAR(64),
    device_type VARCHAR(32),
    browser VARCHAR(64),
    os VARCHAR(64),
    KEY idx_short_code_time (short_code, access_time),
    KEY idx_access_time (access_time)
) PARTITION BY RANGE (TO_DAYS(access_time)) (
    PARTITION p202401 VALUES LESS THAN (TO_DAYS('2024-02-01')),
    PARTITION p202402 VALUES LESS THAN (TO_DAYS('2024-03-01'))
    -- ...
);
关键设计决策:
original_url使用VARCHAR(2048):大多数浏览器和 HTTP 协议限制 URL 不超过 2048 字符- 访问日志表使用时间分区:便于按时间范围查询和数据清理
- 访问日志独立存储:避免影响核心映射表的读写性能
4.2 存储选型
方案一:MySQL
┌─────────────────────────────────┐
│        MySQL 分库分表            │
│  ┌─────────┐    ┌─────────┐    │
│  │ db_0    │    │ db_1    │    │
│  │ ├─ m_0  │    │ ├─ m_0  │    │
│  │ ├─ m_1  │    │ ├─ m_1  │    │
│  │ └─ ...  │    │ └─ ...  │    │
│  └─────────┘    └─────────┘    │
│  ┌─────────┐    ┌─────────┐    │
│  │ db_2    │    │ db_3    │    │
│  └─────────┘    └─────────┘    │
└─────────────────────────────────┘
- 分片键:
short_code的哈希值 - 分片算法:
shard_id = hash(short_code) % shard_count - 优点:成熟稳定、事务支持好、运维经验丰富
- 缺点:分库分表后跨分片查询困难;扩展需要数据迁移
方案二:Redis
# 短码 → 原始 URL 映射
redis.setex(f"su:{short_code}", ttl_seconds, original_url)

# 访问计数
redis.hincrby(f"su:stats:{short_code}", "pv", 1)
redis.pfadd(f"su:uv:{short_code}:{date}", ip)  # HyperLogLog 统计 UV
- 优点:极低延迟、数据结构丰富、天然支持 TTL
- 缺点:全内存存储,成本高;持久化依赖 RDB/AOF,数据量大时恢复慢
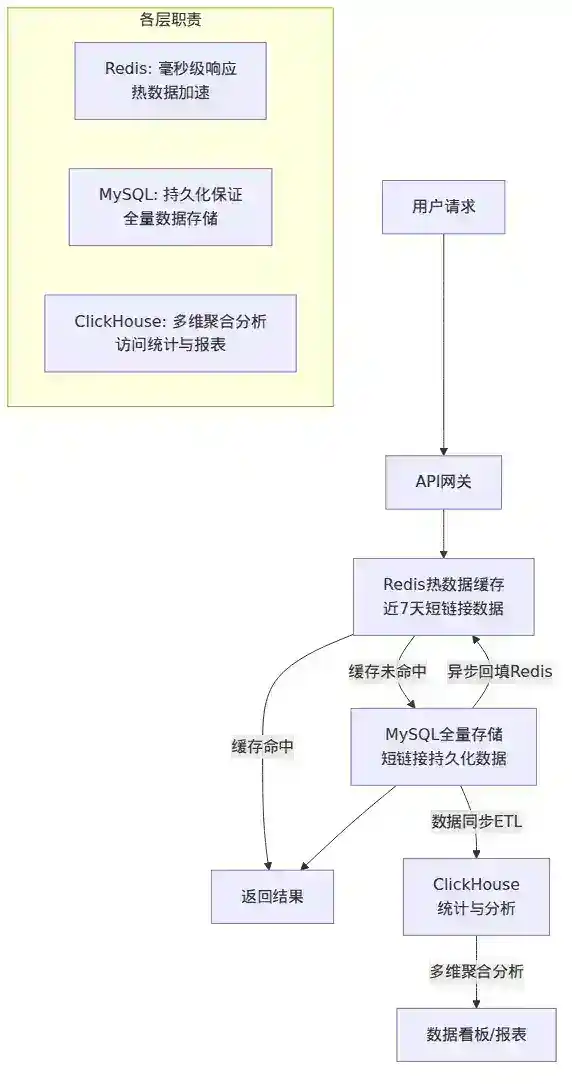
方案三:混合存储(推荐)
                ┌──────────────┐
    请求 ──────▶│   API 网关    │
                └──────┬───────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
   ┌──────────────┐         ┌──────────────┐
   │  Redis 热数据 │         │  MySQL 全量   │
   │  (近 7 天)    │         │  (持久化)     │
   └──────────────┘         └──────────────┘
          │                         │
          └────────────┬────────────┘
                       ▼
              ┌─────────────────┐
              │ ClickHouse/日志  │
              │   (统计与分析)   │
              └─────────────────┘
- 热数据(近期活跃的短链)存储在 Redis 中,提供毫秒级响应
- 全量数据存储在 MySQL 中,保证持久化和数据完整性
- 统计日志写入 ClickHouse,支持高效的多维聚合分析
- Redis 中未命中时回源 MySQL,并异步回填 Redis
4.3 数据过期与清理
# 策略 1:Redis TTL 自动过期
redis.setex(f"su:{short_code}", expire_seconds, original_url)

# 策略 2:定时任务清理
# 每天凌晨执行,删除过期映射和归档日志
DELETE FROM short_url_mapping
WHERE expire_at < NOW() AND expire_at IS NOT NULL
LIMIT 10000;  -- 分批删除,避免长事务

# 策略 3:惰性删除
# 访问时检查是否过期,过期则返回 404 并异步清理
def resolve_short_url(short_code):
    record = cache.get(short_code) or db.get(short_code)
    if record and record.is_expired():
        cache.delete(short_code)
        db.mark_deleted(short_code)
        return None
    return record
五、缓存体系设计
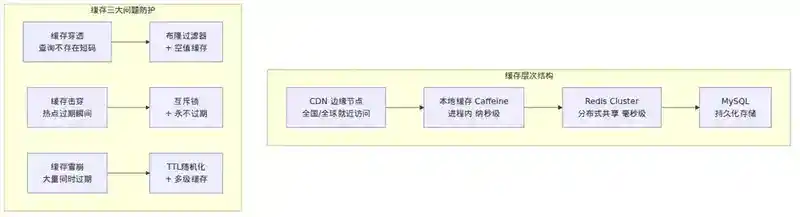
5.1 缓存层次结构
                    ┌──────────────────┐
                    │   CDN / 边缘节点   │  ← 全国/全球就近访问
                    └────────┬─────────┘
                             │
                    ┌────────▼─────────┐
                    │  本地缓存 Caffeine │  ← 进程内,纳秒级
                    │  (maxSize: 10000) │
                    └────────┬─────────┘
                             │
                    ┌────────▼─────────┐
                    │  Redis Cluster    │  ← 毫秒级,分布式共享
                    └────────┬─────────┘
                             │
                    ┌────────▼─────────┐
                    │   MySQL           │  ← 持久化存储
                    └──────────────────┘
5.2 缓存策略
Cache-Aside(旁路缓存)
public String resolveUrl(String shortCode) {
    // 1. 查本地缓存
    String url = localCache.get(shortCode);
    if (url != null) return url;

    // 2. 查 Redis
    url = redis.get("su:" + shortCode);
    if (url != null) {
        localCache.put(shortCode, url);
        return url;
    }

    // 3. 查 MySQL
    ShortUrl record = db.findByShortCode(shortCode);
    if (record != null) {
        // 4. 回写缓存
        redis.setex("su:" + shortCode, ttlSeconds, record.getOriginalUrl());
        localCache.put(shortCode, record.getOriginalUrl());
        return record.getOriginalUrl();
    }
    return null;
}
为什么用 Cache-Aside 而不是 Write-Through?
短链接系统的读写比极高(读远多于写),Cache-Aside 只在读时填充缓存,避免写操作时维护缓存一致性,实现更简单。
5.3 缓存三大问题防护
| 问题 | 场景 | 解决方案 |
|---|---|---|
| 缓存穿透 | 查询不存在的短码,绕过缓存直接打到 DB | 布隆过滤器 + 空值缓存(短 TTL) |
| 缓存击穿 | 热点短码过期瞬间,大量并发请求打到 DB | 互斥锁 + 永不过期 + 异步刷新 |
| 缓存雪崩 | 大量缓存同时过期,DB 压力骤增 | 过期时间随机化 + 多级缓存 + 限流 |
// 缓存击穿的互斥锁方案
public String resolveUrlWithLock(String shortCode) {
    String url = redis.get("su:" + shortCode);
    if (url != null) return url;

    // 获取分布式锁
    String lockKey = "lock:su:" + shortCode;
    if (redis.setnx(lockKey, "1", 10)) {  // 10 秒超时
        try {
            // 双重检查
            url = redis.get("su:" + shortCode);
            if (url != null) return url;

            // 查 DB 并回写
            ShortUrl record = db.findByShortCode(shortCode);
            if (record != null) {
                redis.setex("su:" + shortCode, ttlSeconds, record.getOriginalUrl());
                return record.getOriginalUrl();
            }
        } finally {
            redis.del(lockKey);
        }
    } else {
        // 未获取锁,短暂等待后重试
        Thread.sleep(50);
        return resolveUrl(shortCode);
    }
    return null;
}
5.4 热点短链优化
对于营销活动等场景,单个短链可能瞬间产生百万级访问:
- 多级缓存:本地缓存(Caffeine)→ Redis → MySQL,逐级下沉
- 本地缓存预热:监控系统检测到短链访问量飙升时,主动推送至各节点本地缓存
- 广播失效:短链更新时,通过消息队列广播失效指令,通知所有节点清除本地缓存
六、跳转与高可用设计
6.1 301 vs 302 重定向
| 301 永久重定向 | 302 临时重定向 | |
|---|---|---|
| 浏览器行为 | 后续直接访问短链,不再请求服务端 | 每次访问短链都请求服务端 |
| 统计准确性 | 无法统计后续点击(浏览器缓存) | 每次点击都能统计 |
| 服务端压力 | 低 | 高 |
| 短链更新 | 更新后已缓存用户看不到新目标 | 每次都能获取最新目标 |
推荐使用 302:虽然增加服务端压力,但保证了统计准确性和短链可更新性。配合缓存优化,302 的性能开销可控。
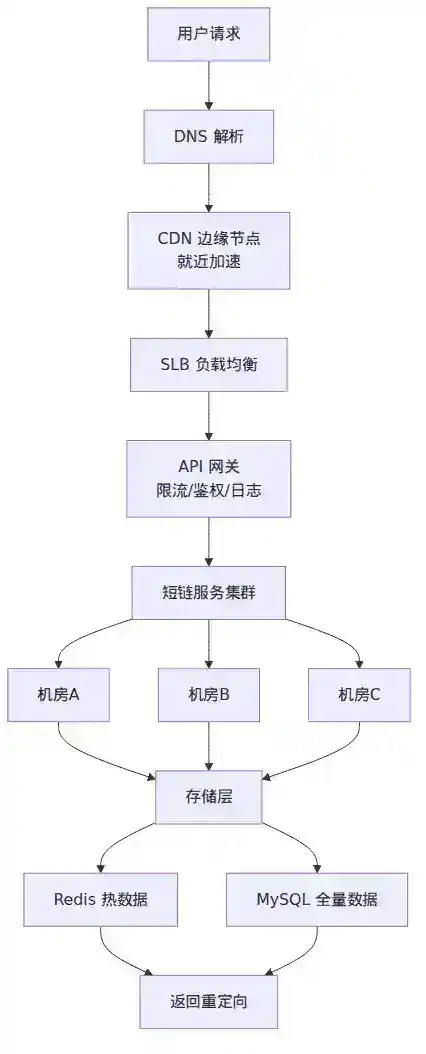
6.2 高可用架构
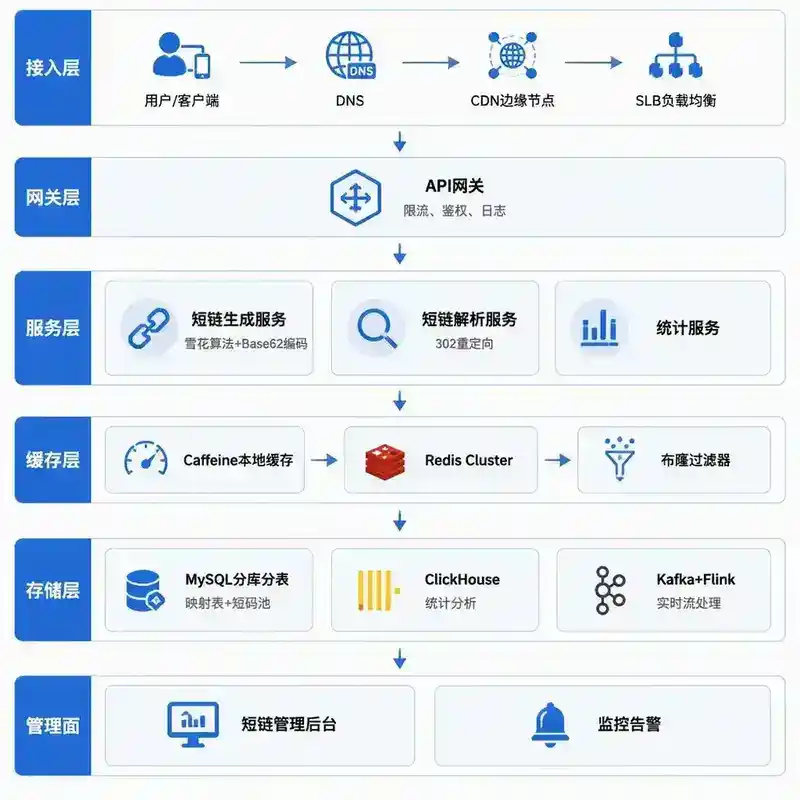
        用户请求
           │
    ┌──────▼──────┐
    │   DNS 解析   │
    └──────┬──────┘
           │
    ┌──────▼──────────────────────┐
    │  CDN (边缘节点就近加速)      │
    └──────┬──────────────────────┘
           │
    ┌──────▼──────┐    ┌──────────┐
    │   SLB 负载   │◀───│ 健康检查  │
    └──────┬──────┘    └──────────┘
           │
    ┌──────▼──────────────────────┐
    │  API 网关 (限流/鉴权/日志)    │
    └──────┬──────────────────────┘
           │
    ┌──────▼──────────────────────┐
    │  短链服务集群 (多机房)        │
    │  ┌─────┐ ┌─────┐ ┌─────┐   │
    │  │ 机房A │ │ 机房B │ │ 机房C │   │
    │  └─────┘ └─────┘ └─────┘   │
    └──────┬──────────────────────┘
           │
    ┌──────▼──────────────────────┐
    │  存储层 (Redis + MySQL)      │
    └─────────────────────────────┘
关键高可用措施:
- 多机房部署:用户就近访问,单机房故障自动切换
- 限流降级:令牌桶/漏桶算法限制单 IP 和全局 QPS
- 熔断降级:存储层故障时,返回预设的降级页面
- 读写分离:MySQL 主从复制,读操作走从库
七、统计分析系统
7.1 统计维度
┌─────────────────────────────────────────────────────────┐
│                   短链访问统计维度                         │
├───────────┬───────────┬───────────┬───────────────────────┤
│  基础指标  │  地域分布  │  设备信息  │  来源分析              │
├───────────┼───────────┼───────────┼───────────────────────┤
│  PV       │  国家     │  设备类型  │  直接访问              │
│  UV       │  省份     │  操作系统  │  搜索引擎              │
│  IP       │  城市     │  浏览器   │  社交媒体              │
│  访问时长  │  运营商   │  屏幕分辨率│  外部链接              │
│  跳出率   │          │  网络类型  │  二维码                │
└───────────┴───────────┴───────────┴───────────────────────┘
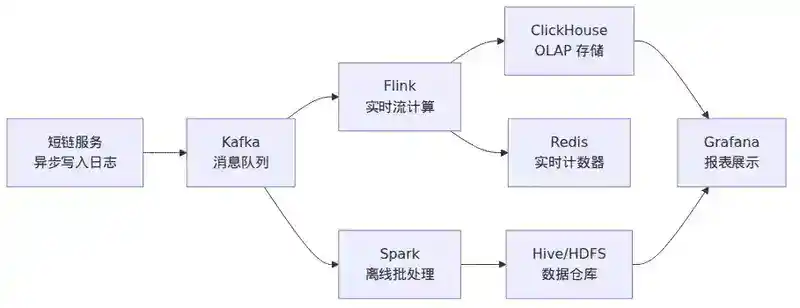
7.2 数据采集架构
访问日志是海量且对时效性要求较低的数据,不适合直接写入 MySQL。推荐的采集架构:
┌──────────┐     ┌──────────┐     ┌──────────┐     ┌──────────────┐
│ 短链服务  │────▶│  Kafka   │────▶│  Flink   │────▶│  ClickHouse  │
│ (异步写入) │     │ (消息队列) │     │ (实时计算) │     │  (OLAP 存储)  │
└──────────┘     └──────────┘     └──────────┘     └──────────────┘
                                            │
                                            ▼
                                     ┌──────────────┐
                                     │   展示/报表    │
                                     │  (Grafana等)  │
                                     └──────────────┘
异步写入:短链服务将访问日志异步写入 Kafka,不阻塞跳转响应。日志丢失不影响核心跳转功能。
实时 + 离线结合:
- Flink 实时聚合最近 5 分钟/1 小时的 PV/UV
- Spark 离线计算每日报表和趋势分析
- ClickHouse 作为 OLAP 引擎,支持秒级多维查询
7.3 UV 统计的近似算法
精确 UV 统计需要存储每个短链的访问 IP 集合,在亿级数据量下成本极高。使用 HyperLogLog 算法可实现误差 1% 以内的近似 UV:
// Redis HyperLogLog 统计 UV
redis.pfadd("su:uv:" + shortCode + ":" + date, ip);
long uv = redis.pfcount("su:uv:" + shortCode + ":" + date);
每个 HyperLogLog 仅占用约 12KB 内存,可统计 2^64 个不同元素。
八、安全与风控
8.1 短链滥用场景
- 钓鱼攻击:短链隐藏真实目标,诱导用户点击钓鱼网站
- 恶意跳转:短链指向恶意软件下载、垃圾广告
- 垃圾信息:利用短链绕过短信/邮件系统的黑名单检测
- DDoS 利用:大量短链指向同一目标,形成流量攻击
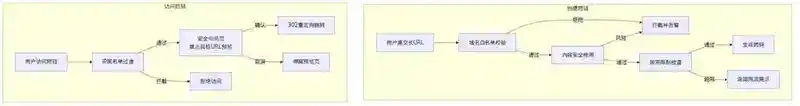
8.2 防护策略
            ┌─────────────────────┐
  创建短链   │  1. 域名白名单校验    │
  ─────────▶│  2. 内容安全检测      │──▶ 拦截/放行
            │  3. 频率限制          │
            └─────────────────────┘

            ┌─────────────────────┐
  访问短链   │  1. 安全中间页(可选) │
  ─────────▶│  2. IP 黑名单过滤     │──▶ 跳转/拦截
            │  3. 访问频率限制      │
            └─────────────────────┘
安全中间页(Preview Page):在跳转前展示目标 URL 的预览,用户可以确认后再跳转。这是防止钓鱼链接的有效手段。
域名白名单:仅允许将特定域名(如企业自有域名、合作方域名)生成短链,拒绝未知域名。
短链有效期:默认设置 30 天有效期,到期自动失效,降低长期风险。
九、面试官提问
以下问题从面试官视角设计,考察对短链接系统设计的深层理解,而非简单复述文档内容。
Q1:如果短链的 QPS 达到 10 万级别,你的缓存架构需要做哪些调整?布隆过滤器应该放在哪里?本地缓存的大小如何确定?
Q2:雪花算法中,如果机器时钟发生回拨,除了常见的等待和备用 worker ID 方案,你还能想到哪些工程上的容错手段?这些手段各自有什么代价?
Q3:你提到使用 Base62 编码,为什么不直接用 Base64?Base64 中的 + 和 / 在 URL 中会有什么问题?如果短链需要支持大小写不敏感的场景,应该怎么调整编码方案?
Q4:如果短链服务需要支持用户自定义短码(如 t.cn/my-brand),你的数据库设计和冲突处理策略需要做哪些改变?自定义短码和系统生成的短码如何统一管理?
Q5:访问日志的写入量可能达到每秒数万条,如果 Kafka 集群出现故障,你会如何设计降级方案保证核心跳转功能不受影响?
Q6:你的混合存储方案中,Redis 和 MySQL 之间如何保证数据一致性?如果 Redis 中的数据与 MySQL 不一致,会出现什么问题?你如何监控和修复这种不一致?
Q7:短链系统中的"短码"是否有被枚举遍历的风险?攻击者可以通过遍历短码获取所有映射关系,你如何防范这种风险?
Q8:如果要设计一个全球化的短链服务,多机房之间如何同步短链映射数据?如何保证用户在不同地区访问同一短链时都能正确跳转,同时最小化跨机房流量?