阅读时间:约 40-50 分钟 适用读者:Java 架构师、分布式系统工程师、后端技术专家
一、问题起源:为什么单机房不够?
2018 年某电商大促,凌晨 0 点流量洪峰涌入,华东机房数据库连接池瞬间打满,全国用户看到的都是"系统繁忙"。运维团队紧急扩容,但机房的物理机柜已经插满了——没了。
这不是段子,这是真实发生过的事。它暴露了单机房架构的三个致命短板:
- 物理天花板:一个机房的机柜、电力、带宽都是有限的,扩容有上限。
- 单点故障域:光缆被挖断、交换机故障、空调停机——任何一个都能让整个服务下线。
- 用户延迟不均衡:华南用户访问华北机房,RTT 50ms+,每次请求都比本地用户多等几十毫秒。
于是业界开始探索"把服务部署到多个机房"。但"多机房"和"异地多活"之间,隔着一条巨大的鸿沟。
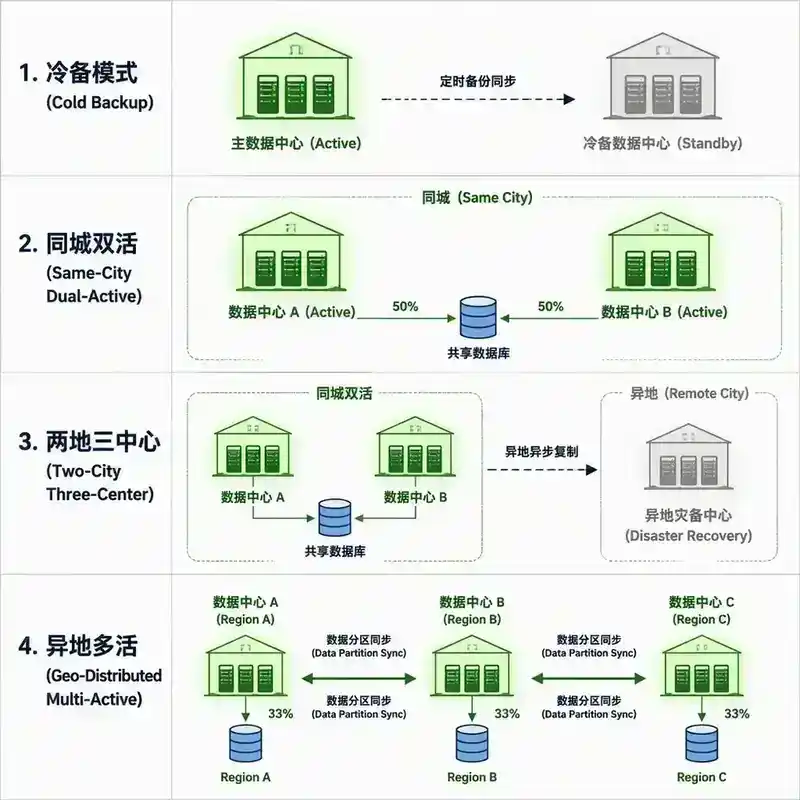
多机房部署的三种形态
| 形态 | 读 | 写 | 故障切换 | 数据一致性 |
|---|---|---|---|---|
| 冷备 | 仅主机房 | 仅主机房 | 手动(分钟级) | 异步复制,丢数据 |
| 同城双活 | 双机房 | 仅主机房 | 自动(秒级) | 同步复制,不丢数据 |
| 异地多活 | 多机房 | 多机房 | 自动(秒级) | 最终一致,需冲突解决 |
从冷备到异地多活,每一步都在解决上一个方案的痛点,但每一步也引入了新的复杂度。异地多活让"所有机房都能写",这听起来很美好,但实现的代价是巨大的——你需要重新思考数据如何分布、请求如何路由、冲突如何解决。
二、核心架构:单元化
异地多活最核心的概念是单元化(Cell-based Architecture)。
2.1 什么是单元
一个单元(Cell)是一个自包含的、可独立对外服务的部署集合。它包含了该业务所需的全部服务——接入层、业务逻辑层、数据层——并且不依赖其他单元就能完成用户请求。
关键特征:
- 自包含:一个单元内部有完整的服务调用链,不需要跨单元调用。
- 流量闭环:用户请求进入某个单元后,所有读写操作都在该单元内完成。
- 独立部署:每个单元可以独立扩缩容、独立升级、独立故障恢复。
2.2 单元化的核心思想
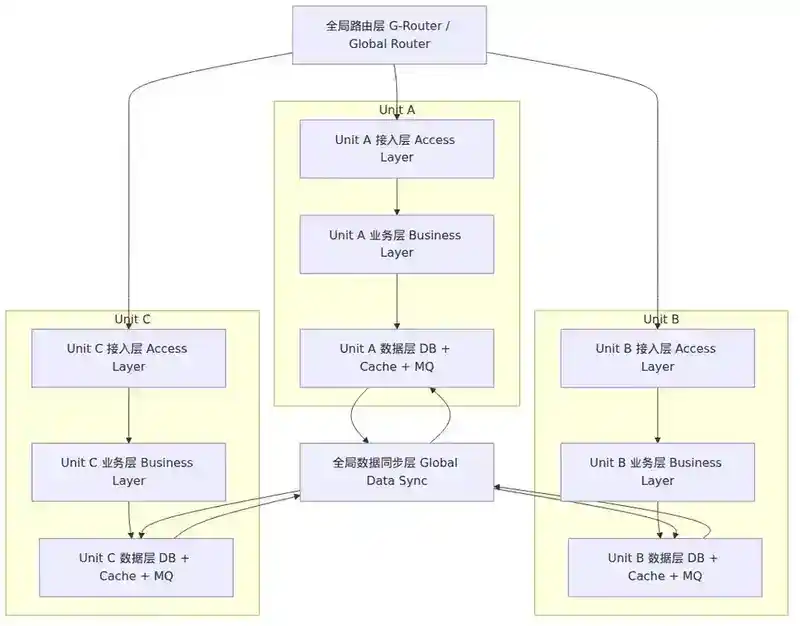
如果把一个大的分布式系统想象成一个"大集群",单元化就是把这个大集群拆成多个"小集群",每个小集群服务一部分用户,互不干扰。
┌─────────────────────────────────────────────────────┐
│                      全局路由层                       │
│          (按用户ID哈希 → 路由到对应单元)                │
└──────┬──────────────┬──────────────┬────────────────┘
       │              │              │
  ┌────▼────┐    ┌────▼────┐    ┌────▼────┐
  │ 单元 A   │    │ 单元 B   │    │ 单元 C   │
  │ 华东机房  │    │ 华北机房  │    │ 华南机房  │
  │          │    │          │    │          │
  │ 接入层    │    │ 接入层    │    │ 接入层    │
  │ 业务层    │    │ 业务层    │    │ 业务层    │
  │ 数据库    │    │ 数据库    │    │ 数据库    │
  │ 缓存      │    │ 缓存      │    │ 缓存      │
  │ 消息队列  │    │ 消息队列  │    │ 消息队列  │
  └──────────┘    └──────────┘    └──────────┘
每个单元内部的架构和单机房几乎一样——但单元之间通过数据分区确保数据不交叉。
2.3 单元化的好处
- 故障隔离:一个单元挂了,只影响该单元内的用户,其他单元不受影响。
- 水平扩展:加用户 → 加单元,而不是在单个机房内堆机器。
- 就近服务:用户请求路由到最近的单元,降低延迟。
- 灰度发布:先在某个单元上线新版本,观察一段时间再全量。
三、数据分区:单元化的基石
单元化架构的核心挑战不是服务拆分,而是数据怎么切分。如果数据还放在一个共享数据库里,那单元化就是空壳——所有单元还是得去同一个数据库读写,瓶颈依然在。
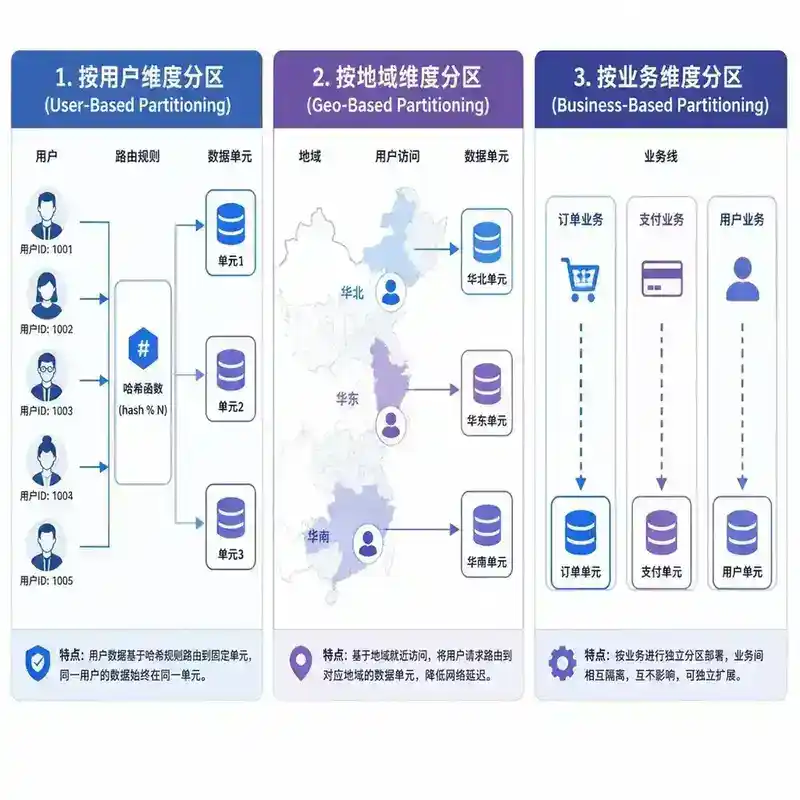
3.1 分区策略选型
方案一:按用户维度分区(最常用)
以用户 ID 为 sharding key,哈希取模到不同单元。
单元编号 = hash(userId) % 单元总数
优点:同一个用户的所有数据(订单、购物车、收藏)都在同一个单元,本地事务可行。 缺点:用户跟单元绑定,如果用户迁移到另一个城市,数据还在原单元。
方案二:按地域维度分区
以用户注册地或常用地址为分区维度。
单元 = 根据用户所属地域映射
优点:天然支持就近服务,延迟最低。 缺点:用户出差/搬家时体验变差;地域流量不均(如北京用户远多于西藏)。
方案三:按业务维度分区
不同业务线部署在不同单元。
单元A = 订单服务集群
单元B = 商品服务集群
单元C = 支付服务集群
优点:业务隔离,一个业务挂了不影响其他。 缺点:不是真正的"多活"——每个业务还是只有一套集群在写。
3.2 分区键的选择
分区键(Sharding Key / Partition Key)是单元化架构最重要的设计决策。选错了,后续所有设计都会出问题。
分区键的选择原则:
- 高基数值:分区键的取值空间要足够大,避免数据倾斜。比如"性别"就不能做分区键,只有两个值。
- 均匀分布:哈希后各分区的数据量要基本一致。
- 业务亲和性:经常一起访问的数据应该落在同一个分区。比如用户和用户的订单,应该用同一个 userId 分区。
- 稳定性:分区键的值不应该频繁变化。比如"用户昵称"就不合适,因为用户可能改名。
3.3 全局数据 vs 分区数据
不是所有数据都适合分区。需要区分:
| 数据类型 | 存储方式 | 示例 |
|---|---|---|
| 分区数据 | 每个单元独立存储 | 用户订单、购物车、收藏夹 |
| 全局数据 | 中心化存储,各单元只读 | 商品目录、配置信息、字典表 |
| Global 表 | 每个单元全量同步 | 用户基础信息(用于跨单元查询) |
全局数据的特点是:写少读多,对一致性要求不那么严格。通常的做法是:中心化写入,通过异步复制分发到各单元。
四、流量路由:如何把请求送到正确的单元
数据分区之后,下一个问题是:用户请求来了,怎么知道它应该去哪个单元?
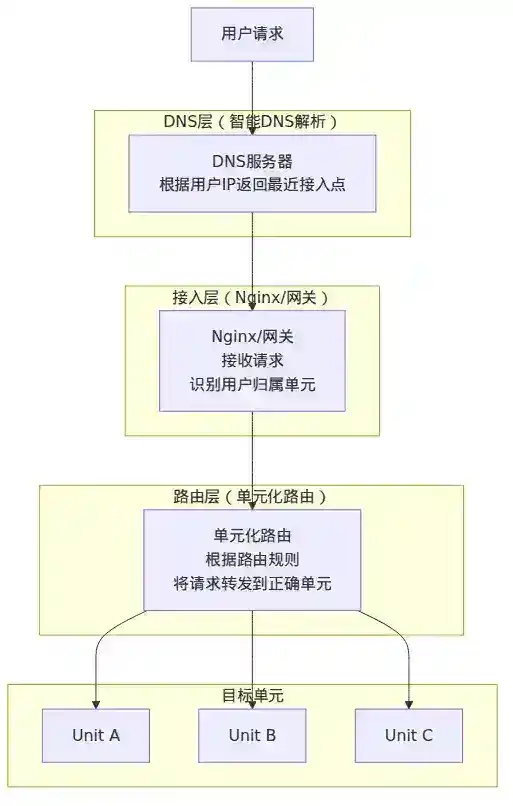
4.1 路由的三层架构
┌──────────┐
│  DNS 层   │  ← 智能 DNS 解析,根据用户 IP 返回最近机房入口 IP
└────┬─────┘
┌────▼─────┐
│ 接入层    │  ← Nginx / API Gateway,解析 Cookie/Header 中的路由信息
└────┬─────┘
┌────▼─────┐
│ 路由层    │  ← 根据 userId 查路由表,判断目标单元,必要时转发
└────┬─────┘
     │
  ┌──▼──┐
  │ 单元 │
  └─────┘
第一层:DNS 智能解析
用户的 DNS 请求被智能 DNS 服务(如阿里云 DNS、AWS Route 53)解析,根据用户 IP 归属地返回最近机房的入口 IP。这一层做的是地理就近,不考虑用户数据在哪个单元。
第二层:接入层路由
接入层(通常是 Nginx 或 API Gateway)从请求中提取路由信息:
- 已登录用户:从 Cookie/JWT 中解析 userId,查路由表
- 未登录用户:默认走地理位置最近的单元
如果发现用户数据不在当前单元,有两种处理方式:
- 转发:把请求转发到目标单元(增加一跳延迟)
- 重定向:返回 302 让客户端直接请求目标单元(客户端感知)
第三层:服务间路由
微服务之间调用时,也需要知道目标服务在哪个单元。这通常通过服务注册中心(如 Nacos、Consul)的元数据来实现——每个服务实例注册时带上自己的单元标签。
4.2 路由表的设计
路由表是单元化架构的"总控开关",它记录了用户→单元的映射关系。
-- 简化的路由表结构
CREATE TABLE route_table (
    user_id      BIGINT PRIMARY KEY,
    cell_id      VARCHAR(16) NOT NULL,   -- 目标单元
    version      BIGINT NOT NULL,         -- 乐观锁版本号
    updated_at   TIMESTAMP NOT NULL
);

-- 分片规则:hash(user_id) % 单元数
-- 路由表的查询:O(1) 哈希计算,不需要真正查数据库
实际实现中,路由表通常做在内存缓存 + 本地配置中,而不是每次请求都查数据库。路由规则的变更(如单元扩容、用户迁移)通过配置中心(如 Apollo、Nacos)推送到各接入层。
4.3 路由错误的处理
如果请求被路由到了错误的单元怎么办?
- 能处理就处理:比如查询全局数据,任何单元都能返回。
- 转发:把请求转发到正确单元,对客户端透明。
- 拒绝:返回错误码,让客户端重试到正确单元。
关键是:绝对不能在一个单元里修改另一个单元的数据。一旦跨单元写入,数据一致性就彻底乱了。
五、数据同步:单元间的数据如何保持一致
单元化之后,每个单元有自己的数据库。但有些数据需要跨单元同步——比如用户从北京搬到了上海,他的数据需要从华北单元迁移到华东单元。
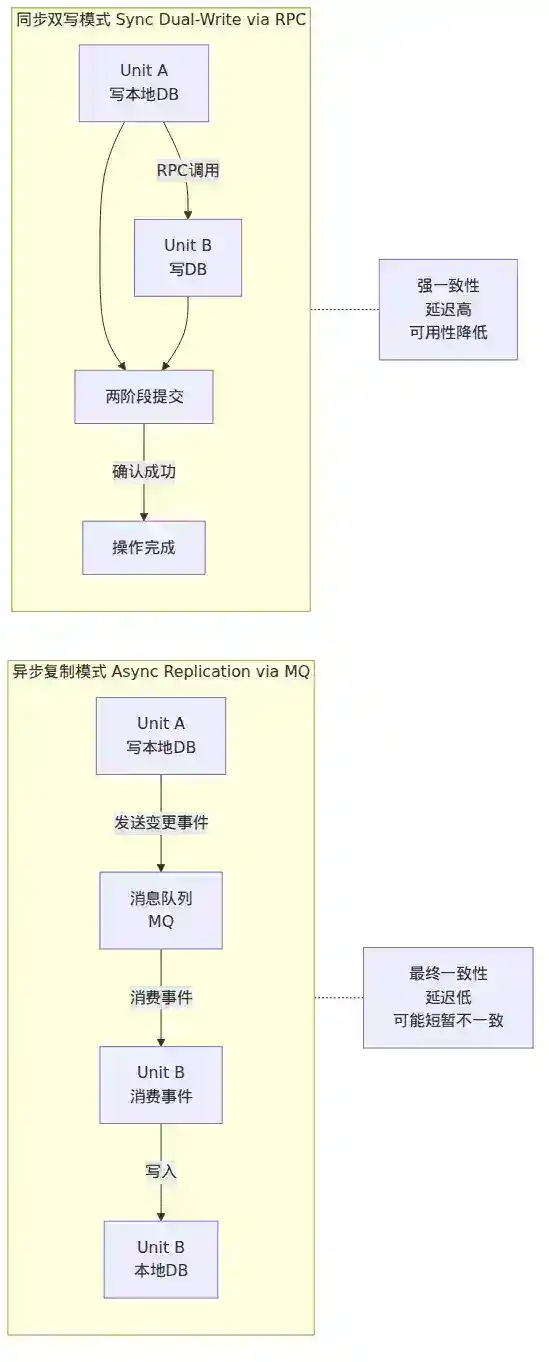
5.1 同步模式
异步复制(最常见)
  单元A (写)                    单元B
  ┌──────┐                    ┌──────┐
  │ 业务  │──写入本地DB         │      │
  │ 服务  │──发MQ消息──────────▶│ 消费  │
  │      │                    │ 写DB  │
  └──────┘                    └──────┘
流程:
- 业务服务在本地单元写入数据库
- 同时发送一条 MQ 消息(binlog 或业务事件)
- 目标单元消费消息,写入本地数据库
优点:不影响本地写入性能。 缺点:有延迟,可能丢消息。
同步双写
  单元A                          单元B
  ┌──────┐                    ┌──────┐
  │ 业务  │──写本地DB            │      │
  │ 服务  │──RPC调用───────────▶│ 写DB  │
  │      │◀──返回结果───────────│      │
  └──────┘                    └──────┘
优点:强一致。 缺点:跨机房 RTT 延迟(如北京↔深圳 ~40ms),如果其中一边失败需要回滚,代价高。
5.2 数据同步的核心挑战
挑战一:顺序性
如果用户在短时间内连续做了两次操作——修改地址 A→B,然后又 B→C——消息到达目标单元的顺序必须是 A→B→C,不能是 A→C→B。
解决方案:
- 使用分区有序的消息队列(如 Kafka 的 partition key = userId)
- 在消费端做版本号检查(version 递增,拒绝旧版本)
挑战二:幂等性
由于网络抖动,同一条消息可能被消费多次。每次处理的结果必须相同。
解决方案:
- 基于唯一键(如 userId + 操作时间戳)做去重
- 使用 Redis 记录已处理的消息 ID(设置 TTL 防止无限增长)
挑战三:循环复制
单元A 写入 → 同步到 单元B → 单元B 的同步机制又发回 单元A → ...
解决方案:
- 在消息中标记来源单元(source_cell),消费端判断来源单元不是自己才处理
- 使用 MySQL 的 server-id 过滤 binlog 复制
六、冲突解决:多写场景下的数据一致性
异地多活最棘手的问题不是同步,而是冲突解决。当两个单元同时修改同一条数据时,到底以哪个为准?
6.1 冲突的类型
| 冲突类型 | 场景 | 示例 |
|---|---|---|
| 更新冲突 | 两个单元同时更新同一条记录 | 用户A在单元1修改昵称为"张三",同时在单元2修改为"李四" |
| 唯一键冲突 | 两个单元同时插入相同的唯一键 | 用户A和用户B同时注册了同一个手机号 |
| 删除-更新冲突 | 一个单元删除记录,另一个单元更新它 | 用户在单元1删除了订单,单元2在同步延迟期间更新了它 |
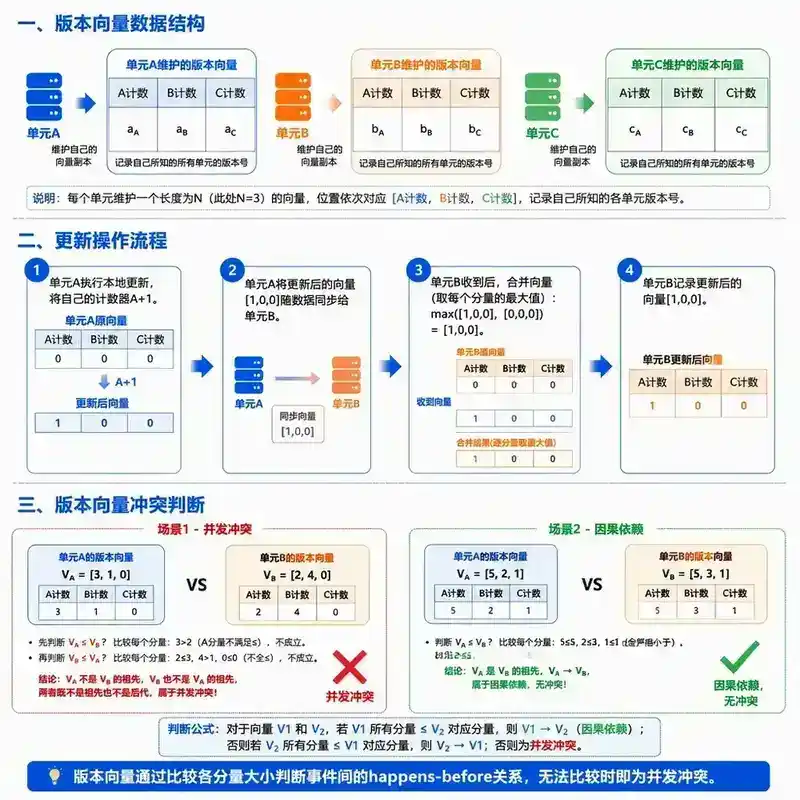
6.2 冲突解决策略
LWW(Last Write Wins,最后写入胜出)
给每条数据加一个时间戳(或版本号),冲突时保留时间戳最大的那个。
public Data merge(Data local, Data remote) {
    if (remote.getVersion() > local.getVersion()) {
        return remote;
    }
    return local;
}
优点:实现简单,性能好。 缺点:依赖时钟同步。如果两个单元的时钟偏差超过同步延迟,时间戳小的"新数据"会被错误丢弃。
CRDT(Conflict-free Replicated Data Types)
CRDT 是一种数学上保证最终一致且无冲突的数据结构。比如:
- G-Counter(增长计数器):每个节点独立计数,合并时取各节点值的和
- PN-Counter(正负计数器):支持增减的计数器
- OR-Set(Observed-Remove Set):支持添加和删除的集合,删除操作不会丢失并发添加的元素
// G-Counter 示例
public class GCounter {
    private Map<String, Long> counts = new HashMap<>(); // nodeId → count

    public void increment(String nodeId) {
        counts.merge(nodeId, 1L, Long::sum);
    }

    public long value() {
        return counts.values().stream().mapToLong(Long::longValue).sum();
    }

    public void merge(GCounter other) {
        other.counts.forEach((node, count) ->
            counts.merge(node, count, Math::max));
    }
}
优点:不需要中心化协调,数学上保证无冲突。 缺点:只适用于特定数据结构,业务逻辑需要适配 CRDT 模型。
业务规则合并
对于更新冲突,可以用业务规则决定合并结果:
// 示例:购物车合并
public Cart mergeCart(Cart cart1, Cart cart2) {
    Cart merged = new Cart();
    // 合并两个购物车的商品,相同商品数量取最大值
    for (Item item : union(cart1.getItems(), cart2.getItems())) {
        int qty1 = cart1.getQuantity(item.getSku());
        int qty2 = cart2.getQuantity(item.getSku());
        merged.addItem(item, Math.max(qty1, qty2));
    }
    return merged;
}
人工介入
对于金融交易等关键数据,冲突时不要自动解决,而是:
- 记录冲突,双方数据都保留
- 通知运营人员人工处理
- 处理完成后同步正确结果
6.3 版本向量(Version Vector)
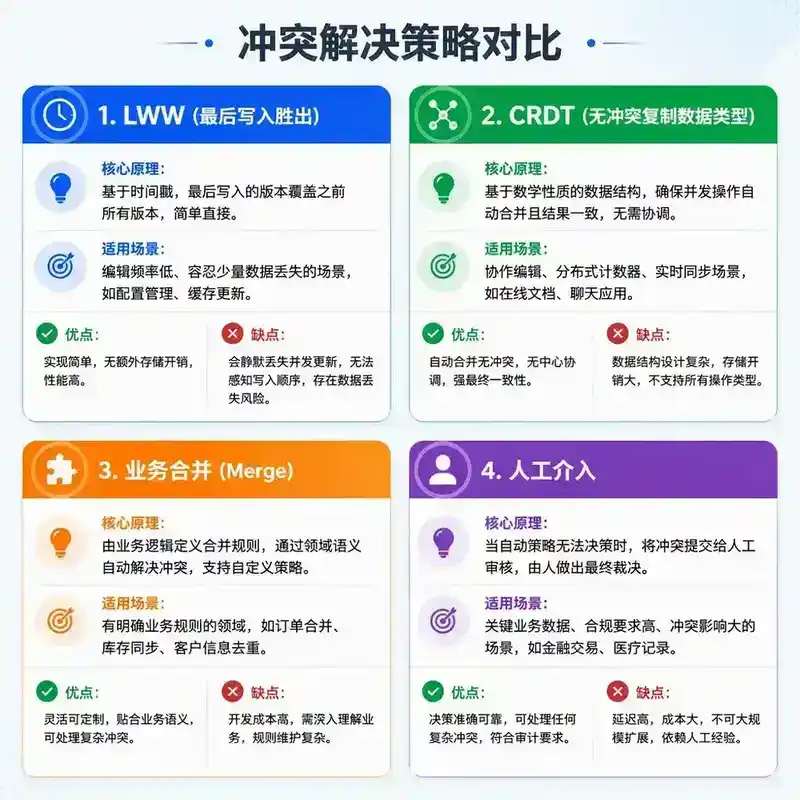
版本向量是一种比时间戳更可靠的冲突检测机制。
// 版本向量:[单元A:3, 单元B:5, 单元C:2]
// 含义:该数据在单元A被修改了3次,单元B 5次,单元C 2次

public class VersionVector {
    private Map<String, Long> versions = new HashMap<>();

    public void increment(String cellId) {
        versions.merge(cellId, 1L, Long::sum);
    }

    public ConflictType compare(VersionVector other) {
        boolean thisGreater = false, otherGreater = false;
        Set<String> allCells = new HashSet<>();
        allCells.addAll(this.versions.keySet());
        allCells.addAll(other.versions.keySet());

        for (String cell : allCells) {
            long v1 = this.versions.getOrDefault(cell, 0L);
            long v2 = other.versions.getOrDefault(cell, 0L);
            if (v1 > v2) thisGreater = true;
            if (v2 > v1) otherGreater = true;
        }

        if (thisGreater && !otherGreater) return ConflictType.THIS_WINS;
        if (otherGreater && !thisGreater) return ConflictType.OTHER_WINS;
        if (!thisGreater && !otherGreater) return ConflictType.EQUAL;
        return ConflictType.CONCURRENT; // 并发冲突,需要合并
    }
}
版本向量的核心思想:如果版本向量 A 的每个维度都 ≥ 版本向量 B,说明 A 是 B 的后继版本,可以直接覆盖。否则就是并发修改,需要合并。
七、容灾切换:当故障发生时
异地多活最核心的价值体现就是容灾切换。一个单元挂了,流量必须无缝切换到其他单元。
7.1 故障检测
故障检测是容灾切换的起点。如果检测慢了,故障已经扩散;如果检测误判,可能造成不必要的切换。
常用检测机制:
| 检测方式 | 检测对象 | 检测周期 | 判定条件 |
|---|---|---|---|
| 健康检查 | 服务实例 | 每 5 秒 | 连续 3 次失败 |
| 业务监控 | 业务指标 | 每分钟 | 成功率 < 阈值 |
| 拨测 | 端到端 | 每 30 秒 | 从多个地域同时探测 |
关键设计:避免误判
- 必须从多个探测点同时检测,单一探测点故障不能触发切换
- 需要有"观察期"——连续失败 N 次才判定为故障,避免瞬时抖动触发切换
- 故障判定需要"人机结合"——自动检测 + 人工确认(对于核心业务)
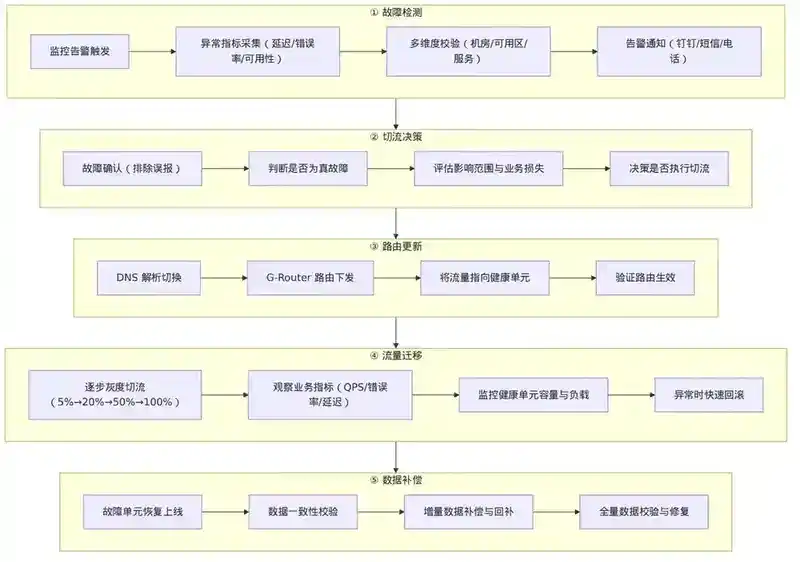
7.2 切换流程
┌──────────────┐
│ 1. 故障检测   │  ← 监控系统发现单元A不可用
└──────┬───────┘
       ▼
┌──────────────┐
│ 2. 切流决策   │  ← 自动/人工确认,生成切换指令
└──────┬───────┘
       ▼
┌──────────────┐
│ 3. 路由更新   │  ← 更新路由表,将单元A的用户指向单元B
└──────┬───────┘
       ▼
┌──────────────┐
│ 4. 流量迁移   │  ← DNS/接入层生效新路由,流量逐步切到单元B
└──────┬───────┘
       ▼
┌──────────────┐
│ 5. 数据补偿   │  ← 单元A恢复后,补偿切换期间丢失的数据
└──────────────┘
7.3 切换的几种模式
计划内切换(灰度切换)
目标:将单元A的 10% 用户迁移到单元B

步骤:
1. 更新路由表,将 10% 用户的 route 指向单元B
2. 等待数据同步完成(单元B拉取这 10% 用户的全量数据)
3. 验证单元B中数据完整性
4. DNS/接入层生效新路由
5. 观察 30 分钟,确认无异常
6. 继续迁移下一批
紧急切换(故障切换)
目标:单元A完全不可用,所有流量切到单元B

步骤:
1. 确认单元A确实故障(多探测点 + 人工确认)
2. 立即更新路由表,所有单元A的用户指向单元B
3. 推送路由变更到所有接入层
4. 单元B接收全部流量,可能触发自动扩容
5. 故障恢复后,逐步回切流量
7.4 回切与数据补偿
故障单元恢复后,需要把流量切回去。但切换期间,数据在单元B上有新的写入,这些数据需要同步回单元A。
// 数据补偿的关键逻辑
public void compensateData(String sourceCell, String targetCell, long failoverTime) {
    // 1. 查询故障期间在 sourceCell 上的所有变更
    List<ChangeLog> changes = changeLogService.query(
        sourceCell,
        failoverTime,  // 故障开始时间
        System.currentTimeMillis()  // 当前时间
    );

    // 2. 逐条应用到 targetCell
    for (ChangeLog change : changes) {
        try {
            dataSyncService.apply(targetCell, change);
        } catch (ConflictException e) {
            // 3. 冲突时使用版本向量判断
            conflictResolver.resolve(change, targetCell);
        }
    }

    // 4. 验证数据一致性
    boolean consistent = dataValidator.verify(sourceCell, targetCell);
    if (!consistent) {
        alertService.send("数据补偿后仍不一致,需人工处理");
    }
}
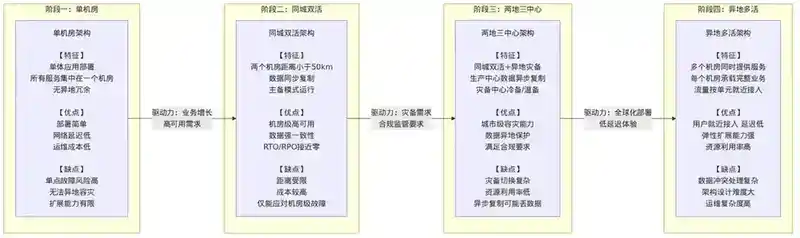
八、实战:一个典型的异地多活架构演进
阶段一:单机房(创业初期)
┌─────────────────┐
│   华东机房        │
│  全部服务 + 全部数据 │
└─────────────────┘
问题:机房故障 = 全线瘫痪。
阶段二:同城双活(用户量增长)
┌──────────┐    ┌──────────┐
│ 华东机房A  │    │ 华东机房B  │
│ 主库(写)   │◀──▶│ 从库(读)   │
│           │ 同步 │           │
└──────────┘    └──────────┘
解决了单机房故障问题,但两个机房物理距离近(通常 < 50km),无法应对城市级灾难。
阶段三:两地三中心(金融级容灾)
┌──────────┐  异步复制  ┌──────────────┐
│ 同城双活   │──────────▶│ 异地灾备中心    │
│ 上海A+B   │           │ 深圳(冷备)    │
└──────────┘           └──────────────┘
同城双活保证服务可用性,异地灾备保证数据不丢。但异地机房平时不服务流量,资源浪费。
阶段四:异地多活(终极形态)
┌──────────┐   ┌──────────┐   ┌──────────┐
│ 华东单元   │   │ 华北单元   │   │ 华南单元   │
│ (上海)    │   │ (北京)    │   │ (深圳)    │
│ 用户: 33% │   │ 用户: 33% │   │ 用户: 34% │
└──────────┘   └──────────┘   └──────────┘
      │              │              │
      └──────────────┼──────────────┘
                     │
              ┌──────▼──────┐
              │  全局数据层   │
              │ (商品、配置)  │
              └─────────────┘
每个单元服务 1/3 的用户,全球数据通过异步复制共享。任一单元故障,流量自动切换到其他单元。
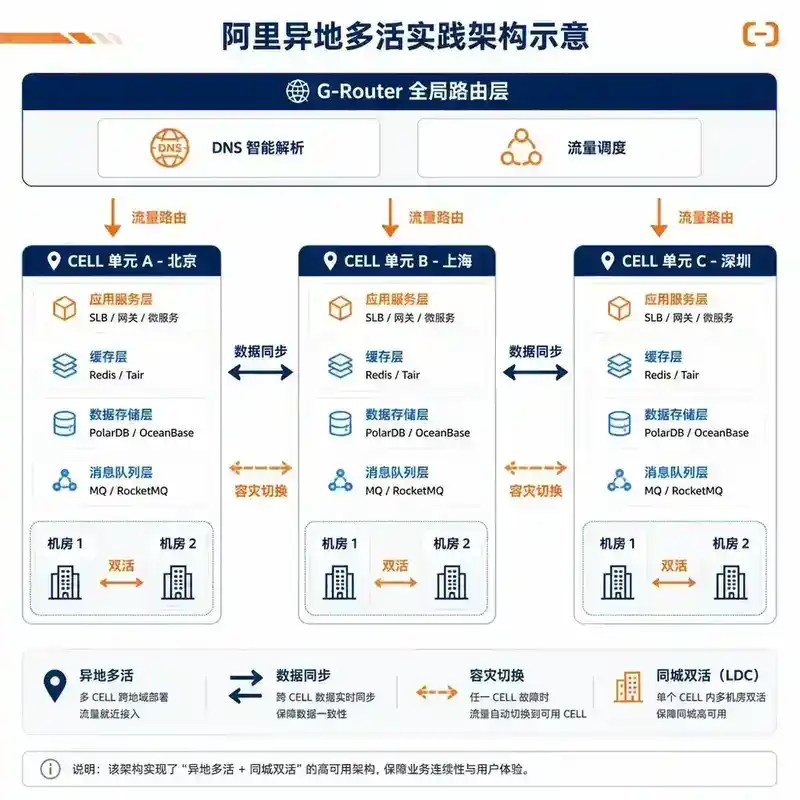
真实案例:阿里异地多活实践
阿里巴巴在 2013 年就开始探索异地多活。经过多年的演进,形成了"单元化 + 同城双活 + 异地多活"的三层架构:
- 同城双活(LDC):同一个城市内部署两个逻辑数据中心,数据库主备同步
- 异地多活(CELL):根据用户 ID 哈希,将不同用户路由到不同城市的单元
- 全局路由(G-Router):统一的路由层,负责请求分发和故障切换
九、关键技术决策 Checklist
在实际落地异地多活时,需要回答以下问题:
- 分区键选什么?用户 ID?商户 ID?地域?
- 全局数据怎么处理?哪些数据需要全局共享,哪些可以分区?
- 同步延迟容忍多少?秒级?分钟级?
- 冲突解决策略?LWW?CRDT?还是人工介入?
- 故障检测阈值?连续多少次失败算故障?
- 切换粒度?整个单元切换,还是按用户比例切换?
- 数据补偿机制?故障恢复后怎么确保数据一致?
- 网络分区怎么办?两个单元之间网络断了,但各自都能正常服务,怎么处理?
十、总结
异地多活不是银弹。它解决了单机房的天花板问题,但引入了巨大的架构复杂度。是否采用异地多活,取决于业务的真实需求:
- 用户量百万级:单机房 + 同城灾备足够
- 用户量千万级、对可用性要求高:同城双活 + 异地灾备
- 用户量亿级、对延迟也有要求:异地多活
异地多活的核心思想可以概括为三句话:
分而治之:用单元化把大问题拆成小问题。 就近服务:让用户数据尽可能靠近用户。 最终一致:接受一定程度的延迟,换取更高的可用性。
面试官提问
以下问题从面试官视角设计,考察候选人是否真正理解异地多活架构的设计权衡,而非简单记忆概念。
Q1:假设你设计的系统按 userId 哈希分区,现在要新增一个单元(从 3 个扩到 4 个),原有用户的数据怎么迁移?迁移过程中用户请求怎么处理?
Q2:异地多活中,如果北京和上海之间的网络光纤断了(网络分区),但两个单元各自都能正常服务。此时两个用户分别在两个单元修改了同一个商品的价格,网络恢复后怎么处理这个冲突?
Q3:你的系统使用了"DNS 智能解析 + 接入层路由"两层路由。用户在家里用 WiFi 登录,被路由到了上海单元;然后出门用 4G,DNS 解析到了深圳单元。深圳单元发现该用户数据在上海,它应该怎么做?转发还是重定向?各自的利弊是什么?
Q4:单元化架构中,全局数据(如商品信息)的更新怎么同步?如果运营在上海单元修改了商品价格,北京单元的用户什么时候能看到新价格?你能接受的最大延迟是多少?
Q5:故障切换时,如何确保"切换动作本身"不会造成更大的问题?比如监控系统误判了一个单元故障,把所有流量切到另一个单元,结果那个单元也被打挂了——这种"雪崩"怎么避免?